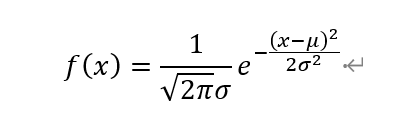
<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <title>月之燃梦</title>
  
  <subtitle>完全属于自己的安静的一隅</subtitle>
  <link href="https://www.lightdream.xyz/atom.xml" rel="self"/>
  
  <link href="https://www.lightdream.xyz/"/>
  <updated>2026-08-23T02:00:00.000Z</updated>
  <id>https://www.lightdream.xyz/</id>
  
  <author>
    <name>lightdm</name>
    
  </author>
  
  <generator uri="https://hexo.io/">Hexo</generator>
  
  <entry>
    <title>用云服务器中转，让 DeepSeek Harness 跑进手机浏览器</title>
    <link href="https://www.lightdream.xyz/dsh-mobile-cloud-relay.html"/>
    <id>https://www.lightdream.xyz/dsh-mobile-cloud-relay.html</id>
    <published>2026-08-23T02:00:00.000Z</published>
    <updated>2026-08-23T02:00:00.000Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>前几天部署了 DSH 的手机访问链路：DeepSeek Harness 跑在电脑上，手机浏览器通过云服务器中转也能随时打开。本文记录这套方案的骨架、安全设计和踩过的坑，给同样想”把本机工具搬进手机”的朋友一份参考。</p></blockquote><h2 id="为什么需要中转"><a href="#为什么需要中转" class="headerlink" title="为什么需要中转"></a>为什么需要中转</h2><p>DeepSeek Harness（下文简称 DSH）默认只监听本机回环地址，这是安全设计——一个跑在本地、能读写文件与配置的助手，不应该裸奔在公网上。但它也带来一个问题：离开电脑就访问不到了。</p><p>解决思路很朴素：**让一台云服务器做”中立中转站”**——电脑把 DSH 的端口通过 SSH 反向隧道”推到”服务器的回环地址上，手机访问服务器域名时，服务器再把请求原路送回电脑。全程只有一条保持连接的加密隧道，服务器上不会存留任何会话数据。</p><h2 id="架构"><a href="#架构" class="headerlink" title="架构"></a>架构</h2><pre><code class="highlight text">手机浏览器   │  https://&lt;桌面入口子域名&gt; / https://&lt;移动网关子域名&gt;   ▼云服务器 nginx (443/HTTP2 + 自动续期证书)   │  反向代理 -&gt; 127.0.0.1:3080 / :3443   ▼SSH 反向隧道 (电脑 -&gt; 服务器，常驻)   │   ▼电脑上的 DSH Web (仅监听 127.0.0.1)</code></pre><p>整条链路就三块拼图：<strong>电脑端的 DSH</strong>（只监听自己的回环地址，是”中心”）、<strong>服务器端的 nginx</strong>（唯一暴露在公网的门面）、<strong>连接二者的 SSH 反向隧道</strong>（负责搬请求，全程加密）。</p><p>下面按搭建顺序一步一步来。每一步都说明：做什么、用什么命令、踩过什么坑。</p><h2 id="分步搭建"><a href="#分步搭建" class="headerlink" title="分步搭建"></a>分步搭建</h2><h3 id="第-1-步：准备云服务器与域名"><a href="#第-1-步：准备云服务器与域名" class="headerlink" title="第 1 步：准备云服务器与域名"></a>第 1 步：准备云服务器与域名</h3><p><strong>做什么</strong>：一台有公网 IP 的云服务器（个人使用最低配就够，这里只做转发）+ 一个域名，解析好两个子域名：<strong>桌面入口</strong>和<strong>移动网关</strong>。</p><p><strong>命令</strong>：</p><pre><code class="highlight bash"><span class="comment"># 服务器网络是否可达（ICMP 常被云厂商禁 ping，用 HTTP 探测更靠谱）</span>curl -v http://&lt;服务器IP&gt;<span class="comment"># 域名解析是否生效</span>nslookup &lt;桌面入口子域名&gt;</code></pre><p><strong>坑</strong>：</p><ul><li>云厂商的”安全组&#x2F;防火墙”和系统内的防火墙（ufw&#x2F;firewalld&#x2F;iptables）是<strong>两层</strong>，必须都放行才算数——只开一层，症状是”外面访问不通，服务器自己也连不上”；</li><li><strong>解析线路类型</strong>这个坑很隐蔽：看着 A 记录明明存在，访问却总被导到别处、证书也签不下来，最后发现是解析商的线路类型（默认&#x2F;境外线路）把路引到了非预期节点。我当时就是没查这一项，排查了好久。<strong>动手前务必先把解析验证好。</strong></li></ul><h3 id="第-2-步：服务器基础加固"><a href="#第-2-步：服务器基础加固" class="headerlink" title="第 2 步：服务器基础加固"></a>第 2 步：服务器基础加固</h3><p><strong>做什么</strong>：SSH 改用非标准端口 + 密钥登录、禁用密码认证、限制认证次数，装 fail2ban 盯 sshd（后面再加 nginx）。先做这一步，因为后面所有操作都在这台机器上，先把暴露面收住。</p><p><strong>命令</strong>：</p><pre><code class="highlight bash"><span class="comment"># 本机生成密钥（一次即可）</span>ssh-keygen -t ed25519<span class="comment"># 上传公钥（Windows 下用 scp 同样可以）</span>scp ~/.ssh/id_ed25519.pub 用户@&lt;服务器IP&gt;:~/.ssh/authorized_keys<span class="comment"># 服务器端修改 SSH 配置</span><span class="built_in">sudo</span> vi /etc/ssh/sshd_config<span class="comment">#   Port &lt;改成的非标准端口&gt;</span><span class="comment">#   PasswordAuthentication no</span><span class="comment">#   MaxAuthTries 3</span><span class="built_in">sudo</span> systemctl restart sshd<span class="comment"># fail2ban（Debian/Ubuntu 示例）</span><span class="built_in">sudo</span> apt install fail2ban</code></pre><p><strong>坑</strong>：</p><ul><li>改 SSH 端口后，<strong>云安全组要同步放行新端口</strong>，否则下一步就把自己锁在门外；</li><li>改配置之前，先另开一个终端验证密钥能登录，确认无误再断开旧会话——经典的自锁事故。</li></ul><h3 id="第-3-步：nginx-反向代理与-HTTPS-证书"><a href="#第-3-步：nginx-反向代理与-HTTPS-证书" class="headerlink" title="第 3 步：nginx 反向代理与 HTTPS 证书"></a>第 3 步：nginx 反向代理与 HTTPS 证书</h3><p><strong>做什么</strong>：装 nginx，建两个 server 块——桌面入口反代到 <code>127.0.0.1:3080</code>（加 Basic Auth），移动网关反代到 <code>127.0.0.1:3443</code>（改写 Host&#x2F;Origin）；然后用 Let’s Encrypt 自动签发并续期证书。</p><p><strong>命令</strong>（配置模板，域名自行替换）：</p><pre><code class="highlight nginx"><span class="comment"># /etc/nginx/sites-available/dsh-desktop —— 桌面入口</span><span class="section">server</span> &#123;    <span class="attribute">listen</span> <span class="number">443</span> ssl http2;    <span class="attribute">server_name</span> &lt;桌面入口子域名&gt;;    <span class="attribute">ssl_certificate</span>     /etc/letsencrypt/live/&lt;桌面入口子域名&gt;/fullchain.pem;    <span class="attribute">ssl_certificate_key</span> /etc/letsencrypt/live/&lt;桌面入口子域名&gt;/privkey.pem;    <span class="attribute">auth_basic</span> <span class="string">&quot;restricted&quot;</span>;    <span class="attribute">auth_basic_user_file</span> /etc/nginx/.htpasswd;    <span class="section">location</span> / &#123;        <span class="attribute">proxy_pass</span> http://127.0.0.1:3080;        <span class="attribute">proxy_set_header</span> Host              <span class="variable">$host</span>;        <span class="attribute">proxy_set_header</span> X-Real-IP         <span class="variable">$remote_addr</span>;        <span class="attribute">proxy_set_header</span> X-Forwarded-For   <span class="variable">$proxy_add_x_forwarded_for</span>;        <span class="attribute">proxy_set_header</span> X-Forwarded-Proto <span class="variable">$scheme</span>;    &#125;&#125;</code></pre><pre><code class="highlight nginx"><span class="comment"># /etc/nginx/sites-available/dsh-mobile —— 移动网关</span><span class="section">server</span> &#123;    <span class="attribute">listen</span> <span class="number">443</span> ssl http2;    <span class="attribute">server_name</span> &lt;移动网关子域名&gt;;    <span class="attribute">ssl_certificate</span>     /etc/letsencrypt/live/&lt;移动网关子域名&gt;/fullchain.pem;    <span class="attribute">ssl_certificate_key</span> /etc/letsencrypt/live/&lt;移动网关子域名&gt;/privkey.pem;    <span class="section">location</span> / &#123;        <span class="attribute">proxy_pass</span> http://127.0.0.1:3443;        <span class="comment"># 网关会校验 Host/Origin，必须改写成自己的域名，否则握手直接被拒</span>        <span class="attribute">proxy_set_header</span> Host              <span class="variable">$host</span>;        <span class="attribute">proxy_set_header</span> Origin            <span class="variable">$scheme</span>://<span class="variable">$host</span>;        <span class="attribute">proxy_set_header</span> X-Real-IP         <span class="variable">$remote_addr</span>;        <span class="attribute">proxy_set_header</span> X-Forwarded-For   <span class="variable">$proxy_add_x_forwarded_for</span>;        <span class="attribute">proxy_set_header</span> X-Forwarded-Proto <span class="variable">$scheme</span>;    &#125;&#125;</code></pre><p>证书与 Basic Auth 密码：</p><pre><code class="highlight bash"><span class="built_in">sudo</span> apt install certbot python3-certbot-nginx<span class="comment"># HTTP-01 校验：要求 80 端口可达、域名已解析到本机</span><span class="built_in">sudo</span> certbot --nginx -d &lt;桌面入口子域名&gt; -d &lt;移动网关子域名&gt;<span class="built_in">sudo</span> systemctl <span class="built_in">enable</span> certbot.timer     <span class="comment"># 自动续期</span><span class="built_in">sudo</span> apt install apache2-utils<span class="built_in">sudo</span> htpasswd -c /etc/nginx/.htpasswd &lt;用户名&gt;   <span class="comment"># Basic Auth 密码</span></code></pre><p><strong>坑</strong>：</p><ul><li>证书签不下来，十有八九是：80 端口没放行，或解析没到这台服务器（回看第 1 步）；</li><li><strong>Host&#x2F;Origin 头不匹配是深层坑</strong>：DSH 移动网关会校验请求的 <code>Host</code>&#x2F;<code>Origin</code>，直接代理转发（不改写）时请求头还是内部地址，握手直接失败。排查顺序建议先确认 <code>proxy_set_header Host $host</code> 与 <code>Origin $scheme://$host</code> 都写了，大部分握手问题就消失了；</li><li>两个子域名<strong>一次签发、一份证书覆盖</strong>即可，证书自动续期后全链路无感，不要去手动换证书引入新错误。</li></ul><h3 id="第-4-步：电脑端-SSH-反向隧道"><a href="#第-4-步：电脑端-SSH-反向隧道" class="headerlink" title="第 4 步：电脑端 SSH 反向隧道"></a>第 4 步：电脑端 SSH 反向隧道</h3><p><strong>做什么</strong>：在电脑上建立常驻反向隧道，把本地 <code>3080</code> 和 <code>3443</code> 两个端口推到服务器的回环地址，并配置保活与自动重连。</p><p><strong>命令</strong>（以 Linux&#x2F;Mac 为例；Windows 下用编辑器直接改 <code>C:\Users\&lt;你&gt;\.ssh\config</code>，效果相同）：</p><pre><code class="highlight bash"><span class="comment"># ~/.ssh/config 里给服务器起个别名，以后一条命令即可</span>Host dsh-cloud    HostName &lt;服务器IP&gt;    Port &lt;SSH端口&gt;    User &lt;用户名&gt;    IdentityFile ~/.ssh/id_ed25519    ServerAliveInterval 30    ServerAliveCountMax 3    ExitOnForwardFailure <span class="built_in">yes</span><span class="comment"># 建立反向隧道（常驻前台）</span>ssh -N -R 127.0.0.1:3080:127.0.0.1:3080 \       -R 127.0.0.1:3443:127.0.0.1:3443 \       dsh-cloud</code></pre><p>做成常驻：Windows 用计划任务（开机启动、失败重启）或 <code>winsw</code>&#x2F;<code>nssm</code> 把上述命令包装成系统服务；Linux&#x2F;Mac 用 <code>autossh</code> 更省心（<code>autossh -M 0 -N -R 127.0.0.1:3080:127.0.0.1:3080 -R 127.0.0.1:3443:127.0.0.1:3443 dsh-cloud</code>）。</p><p><strong>坑</strong>：</p><ul><li>服务器端 sshd 的 <code>AllowTcpForwarding</code> 若被改成 <code>no</code>（部分厂商镜像改过），隧道”成功”但端口根本不会出现在服务器上——用 <code>ss -tlnp | grep -E &#39;3080|3443&#39;</code> 验证一下最直接；</li><li>**务必写 <code>-R 127.0.0.1:3443:...</code> 而不是 <code>-R 3443:...</code>**：后者的远端端口会绑在 <code>0.0.0.0</code> 上，等于把移动网关直接暴露到公网，违背安全设计；</li><li>加 <code>ExitOnForwardFailure yes</code>：服务器上若有残留端口占用，隧道会立刻报错退出，而不是假装正常挂着；</li><li>Windows 的 OpenSSH 对私钥文件权限敏感，报 “bad permissions” 时用 <code>icacls</code> 收一下权限，只留当前用户；</li><li>网络切换（如宿舍↔家）会导致连接挂起，<code>ServerAliveInterval</code> 保活 + 服务自动重启能把这种情况兜住。</li></ul><h3 id="第-5-步：移动端网关（dsh-mobile）"><a href="#第-5-步：移动端网关（dsh-mobile）" class="headerlink" title="第 5 步：移动端网关（dsh-mobile）"></a>第 5 步：移动端网关（dsh-mobile）</h3><p><strong>做什么</strong>：给 DSH 装社区插件 <strong>dsh-mobile</strong>（开源仓库 <code>saya-ch/dsh-mobile</code>，Apache-2.0，通过 npm 安装）作为移动端网关，再配对手机。</p><p><strong>操作</strong>：</p><pre><code class="highlight bash">npm install dsh-mobile    <span class="comment"># 按插件文档接入 DSH</span><span class="comment"># 手机浏览器打开 https://&lt;移动网关子域名&gt; → 进入配对页</span><span class="comment"># 电脑端开配对窗口（一次性令牌，10 分钟内有效）：</span>curl -X POST http://127.0.0.1:3443/api/mobile-access/pairing/open -d <span class="string">&#x27;&#123;&#125;&#x27;</span><span class="comment"># 手机输入令牌 → 配对完成；设备记录存在 ~/.dsh/mobile-access/devices.json</span></code></pre><p><strong>信任模型要记牢</strong>：<strong>已配对的设备 &#x3D; 完全信任</strong>。所以网关本身只监听回环地址、只有公网域名才放开配对入口、配对窗口只能从电脑端发起。设备记录有效期 90 天，会话 8 小时，且会话在网关内存态——<strong>网关重启后手机要重新授权</strong>（重绑时先回电脑端重开配对窗口）。</p><p><strong>版本兼容上的小工作</strong>：dsh-mobile 的启动校验只对较早的 DSH 版本放行（官方验证到 <code>0.1.0-rc.7</code>），遇到更新的版本会直接拒绝启动；而我本机使用的 DSH 是 <code>0.1.1-rc.2</code>。本地适配只做了两处几行的小改动：一是把版本白名单补齐到当前使用的 rc.2；二是适配新版前端启动脚本中全局变量声明书写形式的变化（新版本改用了 <code>globalThis</code> 写法）。两处补丁都已整理成建议反馈给插件作者，等上游更新合并后即可去掉。</p><p><strong>坑</strong>：</p><ul><li>网关启动被拒，先看日志区分是”版本校验”还是”端口占用”——前者按上面补丁处理，后者检查 3443 是否被其他进程占用；</li><li>本地调试直接访问 <code>127.0.0.1:3443</code> 时，请求头必须携带网关认可的 <code>Host</code>&#x2F;<code>Origin</code>（也就是走 nginx 那条链路、用域名访问），裸地址直连会被校验拒掉——<strong>所有访问都走域名，本地调试也一样</strong>。</li></ul><h3 id="第-6-步：联动验收"><a href="#第-6-步：联动验收" class="headerlink" title="第 6 步：联动验收"></a>第 6 步：联动验收</h3><p><strong>做什么</strong>：按清单走一遍，确认整条链路成立、自愈能力可用。</p><pre><code class="highlight bash"><span class="comment"># 服务器端：隧道端口是否在监听（理想输出应只有 127.0.0.1 绑定）</span>ss -tlnp | grep -E <span class="string">&#x27;3080|3443&#x27;</span><span class="comment"># 证书状态</span><span class="built_in">sudo</span> certbot certificates</code></pre><ul><li>浏览器打开 <code>https://&lt;桌面入口子域名&gt;</code>：应弹 Basic Auth，输入后进入 DSH 桌面界面；</li><li>手机打开 <code>https://&lt;移动网关子域名&gt;</code>：配对 → 正常使用，移动端布局与交互正常；</li><li>自愈测试：电脑重启 &#x2F; 切换网络后，隧道应自动恢复；服务器重启后，重连脚本应把隧道拉回来。</li></ul><h2 id="安全设计（硬底线）"><a href="#安全设计（硬底线）" class="headerlink" title="安全设计（硬底线）"></a>安全设计（硬底线）</h2><p>这套方案把”方便”和”安全”做了明确切割：</p><table><thead><tr><th>层</th><th>措施</th></tr></thead><tbody><tr><td>公网暴露面</td><td>云防火墙只放行 80&#x2F;443&#x2F;SSH；SSH 改用非标准端口</td></tr><tr><td>SSH</td><td>仅密钥登录、禁止密码、限制最大认证次数，配合 fail2ban 自动封禁扫描</td></tr><tr><td>Web</td><td>桌面入口加 Basic Auth；移动网关仅回环监听 + 域名校验；fail2ban 盯非 2xx 状态码</td></tr><tr><td>证书</td><td>全自动签发&#x2F;续期，几个域名一条龙</td></tr><tr><td>监控</td><td>nginx 日志按域名拆分；每周一 08:00 自动生成安全运维周报发到邮箱（登录失败、封禁统计、证书剩余天数、资源占用）</td></tr></tbody></table><p>一句话：<strong>公网只暴露”门面”，真正干活的服务永远只在回环地址上</strong>；手机侧访问请求后也无任何数据落盘在服务器。</p><h2 id="使用体验与踩坑"><a href="#使用体验与踩坑" class="headerlink" title="使用体验与踩坑"></a>使用体验与踩坑</h2><h3 id="手机第一次访问"><a href="#手机第一次访问" class="headerlink" title="手机第一次访问"></a>手机第一次访问</h3><p>打开移动网关子域名页面 → 配对页面 → 在电脑端开配对窗口（一次性令牌）→ 手机输码 → 完成。之后就是正常的主界面，移动端布局、键盘交互都调过。</p><h3 id="两个容易误会的现象"><a href="#两个容易误会的现象" class="headerlink" title="两个容易误会的现象"></a>两个容易误会的现象</h3><ul><li>**网关重启后手机上”要重新授权”**：网关的会话是内存态，重启就要重新配一次对。这不是 bug，是设计——也意味着服务器&#x2F;隧道恢复后手机要重绑，重绑前记得先在电脑端重开配对窗口。</li><li><strong>打开大历史会话时报”用户中止了请求”<strong>：手机上每次打开会话都会全量回放事件日志，几 MB 级别的重会话会明显吃力，浏览器干脆掐断了请求。</strong>结论是：重会话只在电脑端开，手机上开轻量会话&#x2F;新会话</strong>。</li></ul><h3 id="其他细节"><a href="#其他细节" class="headerlink" title="其他细节"></a>其他细节</h3><ul><li>插件的 3 秒轮询（扩展清单、自定义样式）是插件自身设计，移动端首屏慢多半在插件客户端模块下载，不是网络故障；</li><li>隧道断了会自动重连，但网关会话重置时需要手机重绑，出远门前建议在电脑端保持隧道常驻。</li></ul><h2 id="小结"><a href="#小结" class="headerlink" title="小结"></a>小结</h2><p>这套方案的成本：一台任意廉价云服务器 + 一个域名 + 一个周末下午的配置时间，换来的是”自己的助手跟着自己走”。安全性上，只要坚持”服务不进公网、入口全部代理+鉴权+自动封禁”这三条，个人使用足够放心。</p><p>如果你也想要同款，欢迎交流：关于页留了我的联系方式。</p>]]></content>
    
    
    <summary type="html">&lt;p&gt;前几天部署了 DSH 的手机访问链路：DeepSeek Harness 跑在电脑上，手机浏览器通过云服务器中转也能随时打开。本文记录这套方案的骨架、安全设计和踩过的坑，给同样想”把本机工具搬进手机”的朋友一份参考。 为什么需要中转 DeepSeek Harness（下文简称 DSH）默认只监听本机回环地址，这是安全设计——一个跑在本地、能读写文件与配置的助手…&lt;/p&gt;</summary>


    <category term="Web技术" scheme="https://www.lightdream.xyz/categories/Web%E6%8A%80%E6%9C%AF/"/>
    
    
    <category term="DSH" scheme="https://www.lightdream.xyz/tags/DSH/"/>
    
    <category term="远程访问" scheme="https://www.lightdream.xyz/tags/%E8%BF%9C%E7%A8%8B%E8%AE%BF%E9%97%AE/"/>
    
    <category term="云服务器" scheme="https://www.lightdream.xyz/tags/%E4%BA%91%E6%9C%8D%E5%8A%A1%E5%99%A8/"/>
    
    <category term="安全" scheme="https://www.lightdream.xyz/tags/%E5%AE%89%E5%85%A8/"/>
    
  </entry>
  
  <entry>
    <title>Git原理及命令总结</title>
    <link href="https://www.lightdream.xyz/GitPrincipleAndComandSummary.html"/>
    <id>https://www.lightdream.xyz/GitPrincipleAndComandSummary.html</id>
    <published>2021-09-09T05:23:48.000Z</published>
    <updated>2021-10-01T20:32:40.583Z</updated>
    
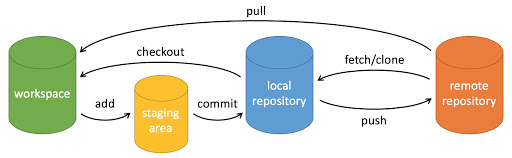
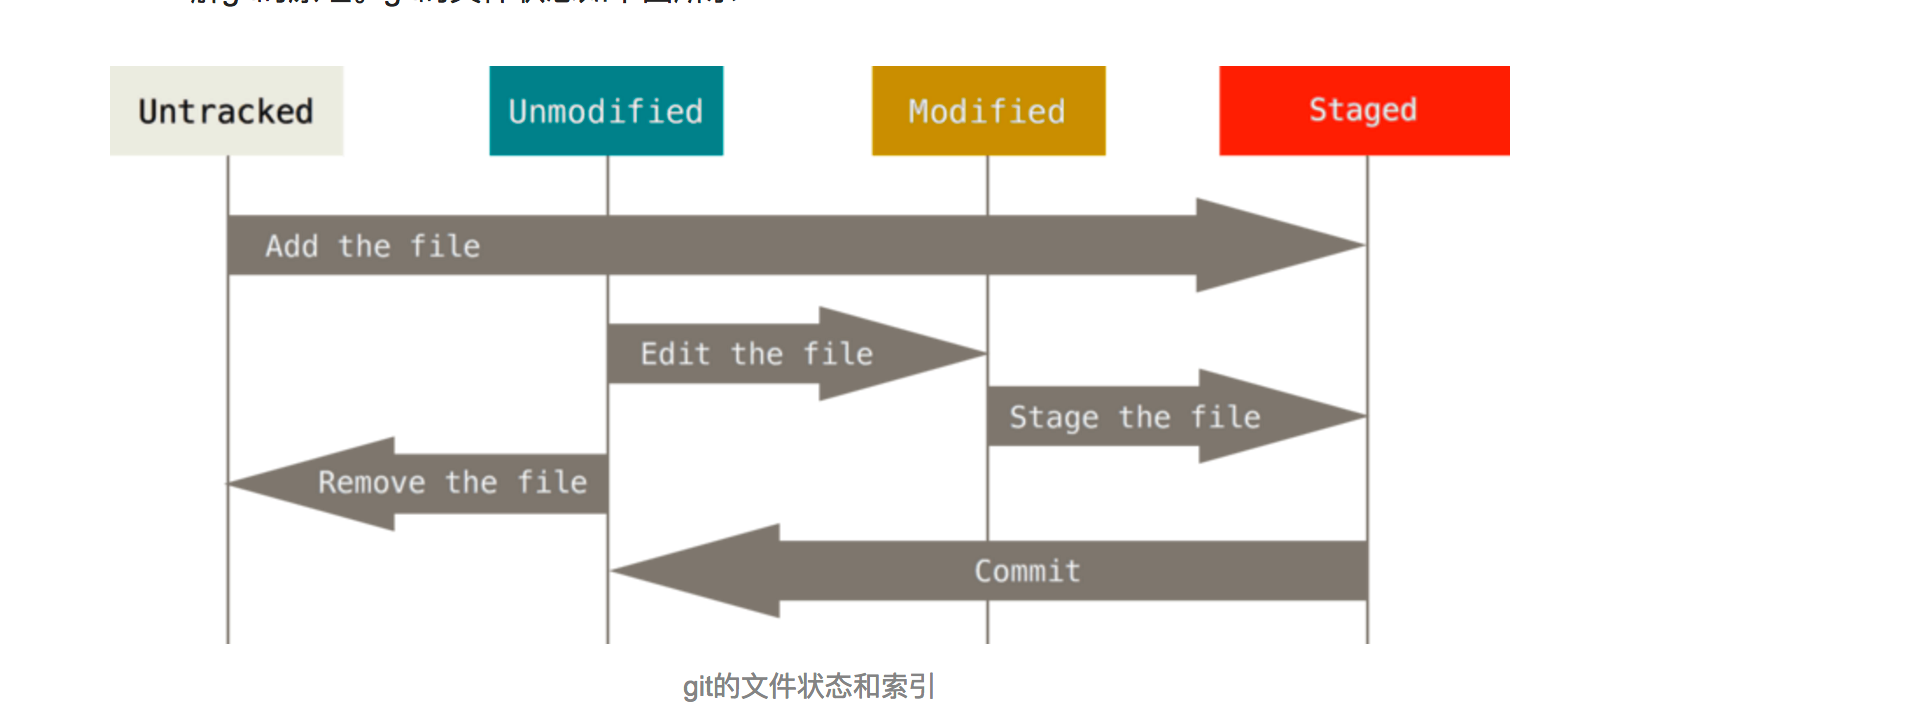
    <content type="html"><![CDATA[<p>工作区-(暂存区)-本地仓库-远程仓库  </p><h2 id="1-基本操作"><a href="#1-基本操作" class="headerlink" title="1. 基本操作"></a>1. 基本操作</h2><p><img src="/../image/git_base.png"></p><h2 id="2-工作区文件状态转换"><a href="#2-工作区文件状态转换" class="headerlink" title="2. 工作区文件状态转换"></a>2. 工作区文件状态转换</h2><p><img src="/../image/file_status.png"></p><ul><li><strong>已追踪状态</strong>：纳入版本控制，【已修改&#x2F;未修改&#x2F;已暂存】状态<br>注： 经克隆下来的仓库处于：【已跟踪(未修改)】状态</li><li><strong>未追踪状态</strong>：未被纳入版本控制。<br>注：例如经克隆下来的仓库，在仓库添加一个文件，该文件处于未跟踪<ul><li>未跟踪的文件经过<strong>git add</strong>命令转换到【已跟踪】(已暂存)</li><li>未修改的文件经过【修改】—&gt;【已修改】</li><li>已修改的文件经过<strong>git add</strong>命令转换到【已暂存】</li><li>已暂存的文件经过<strong>git commit</strong>命令转换到【未修改】</li><li>未修改的文件经过<strong>git rm</strong> 命令转换到【未跟踪】， 文件被删除。</li></ul></li></ul><h2 id="3-分支相关操作"><a href="#3-分支相关操作" class="headerlink" title="3. 分支相关操作"></a>3. 分支相关操作</h2><ul><li><p><strong>Git branch -a</strong> 查看所有分支，HEAD指向</p></li><li><p><strong>Git checkout</strong> 分支名 ，切换分支</p></li><li><p><strong>git status</strong> 查看当前分支状态</p></li><li><p><strong>Git reflog</strong> 历史操作s</p></li><li><p><strong>Git merge</strong> 合并远程和本地仓库的冲突</p></li><li><p><strong>git clone -b 分支名 克隆指定仓库的分支到本地</strong></p></li></ul><h3 id="3-1-克隆指定仓库分支，修改后再上传到该分支"><a href="#3-1-克隆指定仓库分支，修改后再上传到该分支" class="headerlink" title="3.1 克隆指定仓库分支，修改后再上传到该分支"></a>3.1 克隆指定仓库分支，修改后再上传到该分支</h3><p>  首先将指定分支克隆下来：</p><pre><code class="lang-shell">git clone -b &lt;分支名&gt; &lt;url&gt;.git</code></pre><p>  其次新建一个本地分支并与远程分支关联，同时切换到本地分支：</p><pre><code class="lang-bash">git checkout -b &lt;本地分支名&gt; origin/&lt;远程分支名&gt;</code></pre><p>  此时，开始修改克隆下来的分支文件，修改好以后，将当前目录添加至缓冲区</p><pre><code class="lang-shell">git add .  # 添加新增的、修改的文件或者git add -A # 添加新增的、修改的、删除的文件</code></pre><p>  接下来将缓存区的目录提交至本地仓库</p><pre><code class="lang-bash">git commit -m &lt;&quot;修改的注释&quot;&gt;</code></pre><p>  最后将本地仓库push到远程仓库：</p><pre><code class="lang-bash">git push origin &lt;远程仓库名&gt;</code></pre><h2 id="4-Git-撤销commit-方法"><a href="#4-Git-撤销commit-方法" class="headerlink" title="4. Git 撤销commit 方法"></a>4. Git 撤销commit 方法</h2><ul><li><p>Git revert (还原某个commit， 但留下还原记录)，其基本用法为，其中 <strong>-n</strong> 表示，表示revert以后需要重新提交一个commit信息再推送，若不使用 <strong>-n</strong> 则会弹出vim编辑commit注释。</p><pre><code class="lang-bash">git revert -n &lt;commit-id&gt;</code></pre><p>假如有一条commit线，</p><pre><code class="mermaid">graph LR;subgraph flowA--&gt;B--&gt;Cend</code></pre><p>上方的revert命令中(可通过git log命令查看)为B的id，则执行以上命令后，commit线变为以下</p><pre><code class="mermaid">graph LR;subgraph flowA--&gt;B--&gt;C--&gt;Dendsubgraph pointerHEAD--&gt;masterendmaster--&gt;D</code></pre></li><li><p>Git reset (整段commit还原，不留记录，其修改HEAD指针的指向位置。</p><pre><code class="lang-bash">git reset --hard &lt;commit-id&gt;</code></pre><p>变为之前的commit-id对应版本)。适用于只想恢复到之前某个提交的版本，后面的都不要了，用commit图表示如下，还是上面的commit线，假如需要回退到A版本，将上面的commit-id设为A，执行命令后变为如下:</p><pre><code class="mermaid">graph LR;subgraph flowAendsubgraph pointerHEAD--&gt;master--&gt;Aend</code></pre></li></ul>]]></content>
    
    
    <summary type="html">&lt;p&gt;工作区-(暂存区)-本地仓库-远程仓库 1. 基本操作 2. 工作区文件状态转换 已追踪状态 ：纳入版本控制，【已修改&amp;#x2F;未修改&amp;#x2F;已暂存】状态 注： 经克隆下来的仓库处于：【已跟踪(未修改)】状态 未追踪状态 ：未被纳入版本控制。 注：例如经克隆下来的仓库，在仓库添加一个文件，该文件处于未跟踪 未跟踪的文件经过 git add 命令转换到【…&lt;/p&gt;</summary>


    <category term="Git" scheme="https://www.lightdream.xyz/categories/Git/"/>
    
    
    <category term="Git" scheme="https://www.lightdream.xyz/tags/Git/"/>
    
    <category term="技术总结" scheme="https://www.lightdream.xyz/tags/%E6%8A%80%E6%9C%AF%E6%80%BB%E7%BB%93/"/>
    
  </entry>
  
  <entry>
    <title>我的2020</title>
    <link href="https://www.lightdream.xyz/TheDisappeared2020.html"/>
    <id>https://www.lightdream.xyz/TheDisappeared2020.html</id>
    <published>2020-12-31T08:00:00.000Z</published>
    <updated>2026-08-23T04:31:01.686Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>人生似一阕高低起伏的乐章，起伏不尽。 ——雪林</p></blockquote><p>　　2020年，我的人生轨迹发生重大改变的一年。  </p><p>　　在这一年，我可能考上研究生了，到了梦想中的大学去读研究生，开启另一段学生生涯；我可能没考上研究生，凭自己在本科期间的一顿乱学找到了一份匹配我的能力的工作，开启另一个人生新阶段。然，由于我的胆怯，又或者由于我还不想放弃曾经的那个飘渺的梦想，我调剂到了另一所学校，还是去读了研究生。要是人人都能实现梦想，那还要梦想做什么呢？(此处开始找个借口说服自己！)就这样我选择了第三个选项。<br>　　在我选择结束的那一刻，波函数坍缩，人生下半场已定。我这只可爱的薛定谔之猫是挣扎成功了还是越陷越深呢？<br>　　我的2020年正好可以从6月一分为二。6月以前，我在焦虑中沉沦；6月以后，我在微光中看到了些许希望。<br><img src="/../image/%E5%A4%9C%E7%A9%BA.jpg" alt="image"></p><h2 id="前半章"><a href="#前半章" class="headerlink" title="前半章"></a>前半章</h2><p>　　考研结束以后，隔天我就写了大学前三年的总结。那时候写作效率蛮高的嘛。现在，就想着刷手机，哪怕什么也刷不出来(那是不可能的)。二话不多说，开始主题。<br>　　陷入回忆……前半年一直在家里，又焦虑自己没有学上，又焦虑自己找不到工作，还打死都不想学习提高自己。如果时间再长一些，我可能会得抑郁症吧。所幸痛苦并没有持续太久。<br>………………………………………………….<strong>以下写于2021年8月14日</strong>………………………………………………….<br>总体来说，1月到6月一方面是毕业设计相关的事情，一方面是考研相关的事情。</p><ol><li>毕业设计心路历程<br>　　前期可能老师对我不太信任，竟然想让我做一个系统实现方面的毕设！<strong>像我这样一个喜欢挑战自己的人会容忍这种事情吗？作为一个本科还算是努力的同学，毕业设计不是应该做一个对自己的有挑战性的课题吗？</strong><br>　　于是我毅然委婉的拒绝老师换题的好意，欣然开始研究学习粒子群算法相关的知识。总体来说，我并没有将这个方向摸透，但是学习到了这个算法的本质，以及改进这个算法的思路，关于这个粒子群算法的前世今生，大背景等倒是看得津津有味。总体来说，在毕设方面，由于老师的小心谨慎(我敏感的察觉到，从让我换题就意味到了)，整个流程还是比较顺利的，按部就班的做实验，写论文。颇有些得心应手🙊<br>　　但是，在毕业答辩的时候却翻车了——<strong>PPT没有及时演练，导致内容太多，演讲时间过长！这是一个教训！</strong><br>所以对于重要演讲，首先是PPT内容，详略得当！其次应该要提前演练，控制<strong>时间，节奏，流程。</strong><br>……</li><li>考研之后至被录取之间的心路历程<br>　　作为一篇自己看的文章，我不得不以欺骗自己为目的。那段时间，其实我是煎熬的，面对未知既恐惧又焦虑。我不想接受自己考研失败的事实。那段时间，只能靠打游戏来暂时忘却焦虑。<br>　　终于等到查分数的那一天,在看到分数以后随着心猛烈的颤抖一下，我的眼睛也对分数对好焦了——311分，数学63，此时我好像还长舒了一口气，数学堪堪的过线了!数学后面的线代和概率论分数没有拿到，导致我数学终究没能拿到一个满意的成绩。我太注重仪式感了！前期复习数学时候，非要看教科书。然而教科书内容太多，我当时的确没有静下心来，认真做每一道题和过知识点。也就是我暑假时候才真正开始复习数学，但是好像有点晚。那时候也是很焦急，情急之下就只干进度而不重视质量了。这是从战略上就出错了。<br>　　<strong>其一，我一直对自己的数学没有自信，就想将基础打稳点，然而我没有考虑时间问题，总觉得时间还够。然而时间并不够。这是战略上的一大失误，保守主义（想通过先学习教科书打稳基础）冲昏了头脑，没有对自身处境冷静分析。</strong><br>　　<strong>其二，学习不踏实。我还是太过于浮躁，学习东西总是浅尝辄止。因为精通一门东西，后期花的时间往往很长，我还是不愿吃这段平坦过渡区的苦啊。我需要改变这种心态，为什么不从现在开始呢？我越来越靠近明白我正在经历的是什么，心中映照前路风光以给予自己前行的力量。</strong><br>　　4月24日，考研成绩查到，5月24日下午参加调剂复试，定于BUCEA。我安慰自己没有退步，然而现实却不是如此。<br>我希望靠自己在硕士期间再经历一段刻骨铭心的低谷期，取得一个好的结果。啊，到底是会是什么样的结果呢？</li></ol>]]></content>
    
    
    <summary type="html">&lt;p&gt;人生似一阕高低起伏的乐章，起伏不尽。 ——雪林 2020年，我的人生轨迹发生重大改变的一年。 在这一年，我可能考上研究生了，到了梦想中的大学去读研究生，开启另一段学生生涯；我可能没考上研究生，凭自己在本科期间的一顿乱学找到了一份匹配我的能力的工作，开启另一个人生新阶段。然，由于我的胆怯，又或者由于我还不想放弃曾经的那个飘渺的梦想，我调剂到了另一所学校，还是去…&lt;/p&gt;</summary>


    <category term="静夜思" scheme="https://www.lightdream.xyz/categories/%E9%9D%99%E5%A4%9C%E6%80%9D/"/>
    
    
    <category term="2020年" scheme="https://www.lightdream.xyz/tags/2020%E5%B9%B4/"/>
    
    <category term="人生变局" scheme="https://www.lightdream.xyz/tags/%E4%BA%BA%E7%94%9F%E5%8F%98%E5%B1%80/"/>
    
  </entry>
  
  <entry>
    <title>对数几率回归</title>
    <link href="https://www.lightdream.xyz/MachineLearningAlgorithm-logisticRegression.html"/>
    <id>https://www.lightdream.xyz/MachineLearningAlgorithm-logisticRegression.html</id>
    <published>2020-06-26T02:07:47.000Z</published>
    <updated>2020-07-04T23:07:24.534Z</updated>
    
    <content type="html"><![CDATA[<p>对率回归原理及其编程实现  </p><h3 id="原理"><a href="#原理" class="headerlink" title="原理"></a>原理</h3><p>用线性模型解决分类问题，只需找一个单调可微函数将分类任务的标记y与线性回归模型的预测值联系起来。而对数几率函数正是这样的一个常用替代函数：</p><p>$$y &#x3D; \frac{1}{1+e^{-z}}$$</p><p>令$z &#x3D; \vec{\omega}^T\vec{x}+b$，则可得到：</p><p>$$ln\frac{y}{1-y} &#x3D; \vec{\omega}^T\vec{x} + b$$</p><p>令 $p(y &#x3D; 1 | \vec{x}) &#x3D; y$，则$p(y&#x3D;0|\vec{x}) &#x3D; 1-p(y &#x3D; 1 | \vec{x})$，这里假定为二分类任务，则有：</p><p>$$p(y &#x3D; 1 | \vec{x}) &#x3D; \frac{e^{\vec{\omega}^T\vec{x}+b}}{1+e^{\vec{\omega}^T\vec{x}+b}}$$$$p(y &#x3D; 0 | \vec{x}) &#x3D; \frac{1}{1+e^{\vec{\omega}^T\vec{x}+b}}$$</p><p>运用”极大似然法”，则对率回归模型最大似然函数如下：</p><p>$$\ell(\vec{\omega},b) &#x3D; \sum_{i&#x3D;1}^{m}{lnp(y_{i}|\vec{x}_{i};\vec{\omega},b)}$$</p><p>令$\beta &#x3D; ({\vec{w};b})$，令$\dot{x} &#x3D; (\vec{x};1)$，则$\vec{\omega}^T\vec{x}+b &#x3D; \beta^T\dot{x}$。再令$p_{1}(\dot{x};\beta) &#x3D; p(y&#x3D;1|\dot{x};\beta)$，则$p_{0}(\dot{x};\beta)&#x3D;p(y&#x3D;0|\dot{x};\beta)&#x3D;1-p_{1}(\dot{x};\beta)$，则上式为：</p><p>$$p(\vec{y}<em>i|\vec{x}<em>i,\vec{\omega},b)&#x3D;y</em>{i}p</em>{1}(\vec{x}<em>i;\beta) + (1-y_i)(p</em>{0}(\vec{x}_i;\beta))$$</p><p>最大化上式等价于最小化下式，</p><p>$$\ell(\beta) &#x3D; \sum_{i&#x3D;1}^{m}{(-y_i\beta^T\dot{x}_i+ln(1+e^{\beta^T\dot{x}_i}))}$$</p><p>上式是关于$\beta$的高阶可导连续凸函数，根据凸优化理论，可用梯度下降法和牛顿法求得其最优解。<br>这里给出第$t+1$代牛顿迭代法公式：</p><p>$$\beta^{t+1} &#x3D; \beta^t - (\frac{\partial^2\ell{(\beta)}}{\partial\beta \partial\beta^T})^{-1}\frac{\partial\ell{(\beta)}}{\partial\beta}$$</p><p>其中$\ell(\beta)$的一阶，二阶导如下：</p><p>$$\frac{\partial\ell{(\beta)}}{\partial\beta} &#x3D; -\sum_{i&#x3D;1}^{m}{\dot{x}_i(y_i-p_1(\dot{x}<em>i;\beta))}$$$$\frac{\partial^2\ell{(\beta)}}{\partial\beta \partial\beta^T} &#x3D; \sum</em>{i&#x3D;1}^{m}\dot{x}_i\dot{x}_i^Tp_1(\dot{x}_i;\beta)(1-p_1(\dot{x}_i;\beta))$$</p><h3 id="代码所用算法与数据结构分析"><a href="#代码所用算法与数据结构分析" class="headerlink" title="代码所用算法与数据结构分析"></a>代码所用算法与数据结构分析</h3><p>因为目标函数是凸函数，所以可以直接将数据代入目标函数，用经典最优化算法进行求解。</p><h4 id="Python语言实现"><a href="#Python语言实现" class="headerlink" title="Python语言实现"></a>Python语言实现</h4><p>可以将格式化后的数据集存入文件（数据集较小），每次运行读取数据放入内存进行迭代最优化求解即可。代码库见我的码云<br><a href="https://gitee.com/lightingdream/MachineLearningAlgorithm">雨落纷飞</a></p>]]></content>
    
    
    <summary type="html">&lt;p&gt;对率回归原理及其编程实现 原理 用线性模型解决分类问题，只需找一个单调可微函数将分类任务的标记y与线性回归模型的预测值联系起来。而对数几率函数正是这样的一个常用替代函数： $$y &amp;#x3D; &#92;frac{1}{1+e^{-z}}$$ 令$z &amp;#x3D; &#92;vec{&#92;omega}^T&#92;vec{x}+b$，则可得到： $$ln&#92;frac{y}{1-y} &amp;#…&lt;/p&gt;</summary>


    <category term="机器学习" scheme="https://www.lightdream.xyz/categories/%E6%9C%BA%E5%99%A8%E5%AD%A6%E4%B9%A0/"/>
    
    
    <category term="对率回归" scheme="https://www.lightdream.xyz/tags/%E5%AF%B9%E7%8E%87%E5%9B%9E%E5%BD%92/"/>
    
    <category term="机器学习算法" scheme="https://www.lightdream.xyz/tags/%E6%9C%BA%E5%99%A8%E5%AD%A6%E4%B9%A0%E7%AE%97%E6%B3%95/"/>
    
  </entry>
  
  <entry>
    <title>微信疫情通自动提交</title>
    <link href="https://www.lightdream.xyz/autoSubmitTableSystem.html"/>
    <id>https://www.lightdream.xyz/autoSubmitTableSystem.html</id>
    <published>2020-06-12T07:06:37.000Z</published>
    <updated>2020-06-26T01:42:46.399Z</updated>
    
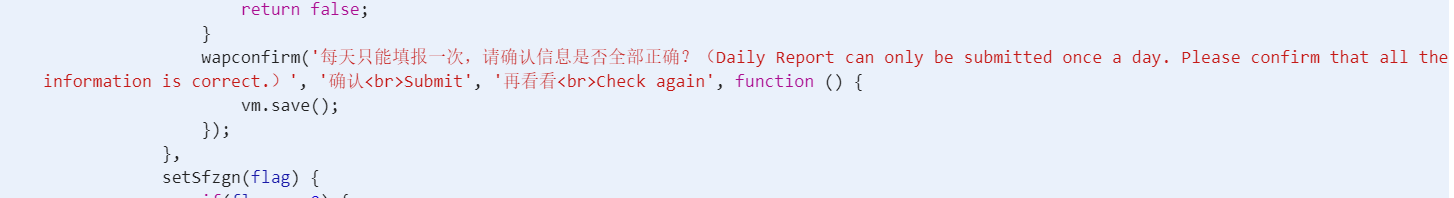
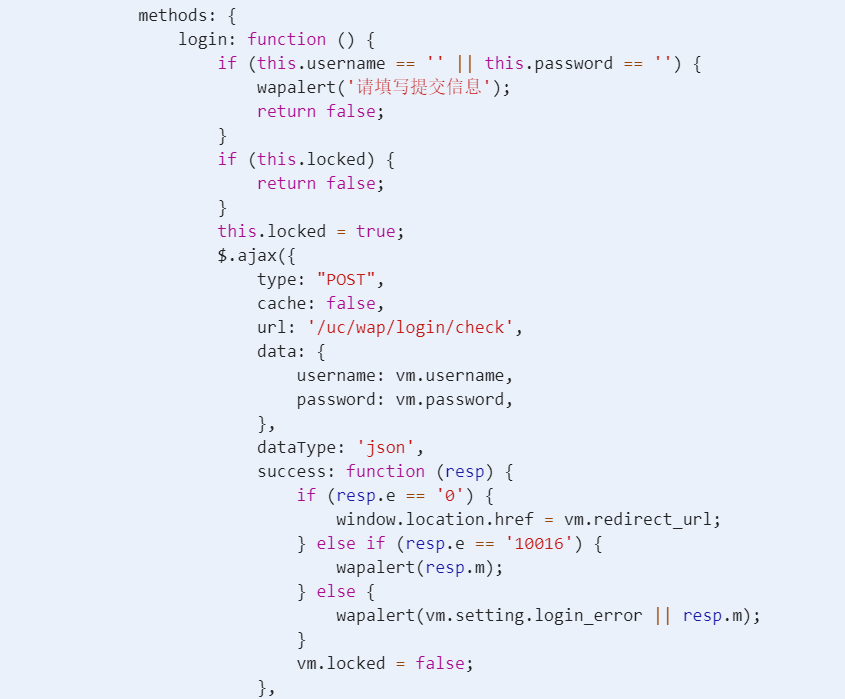
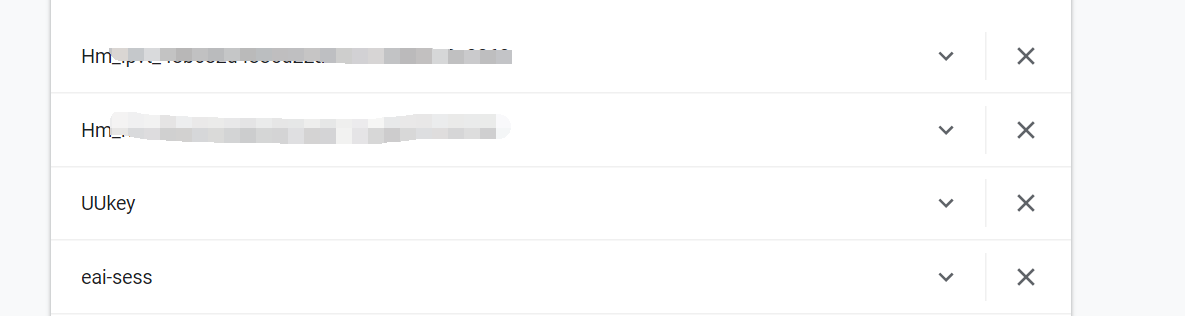
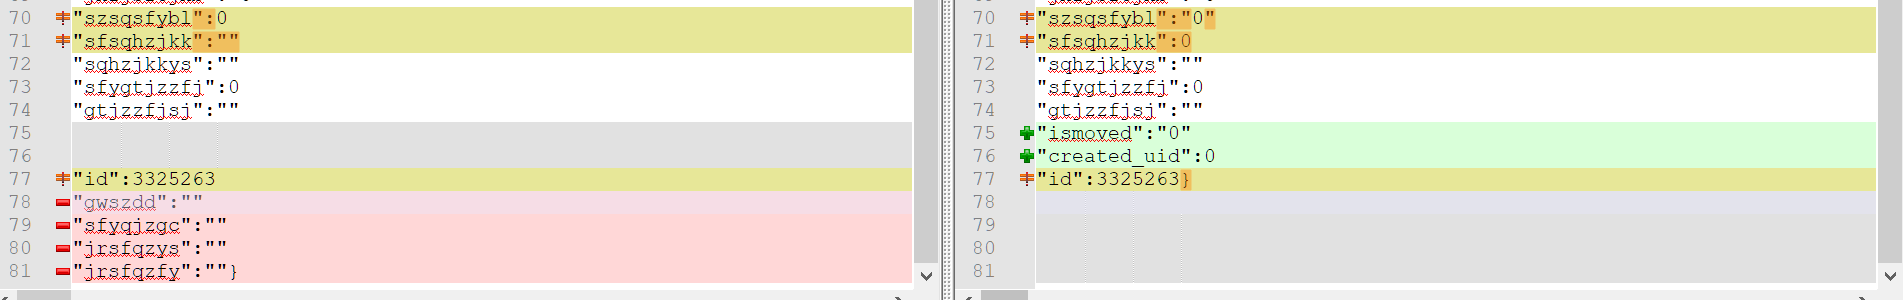
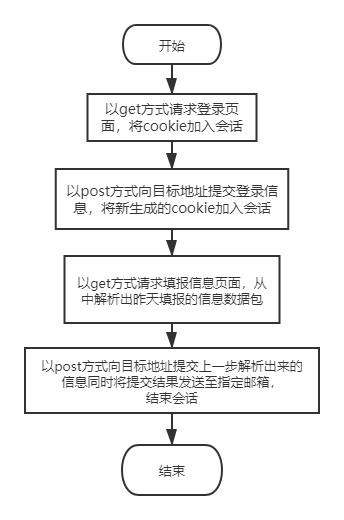
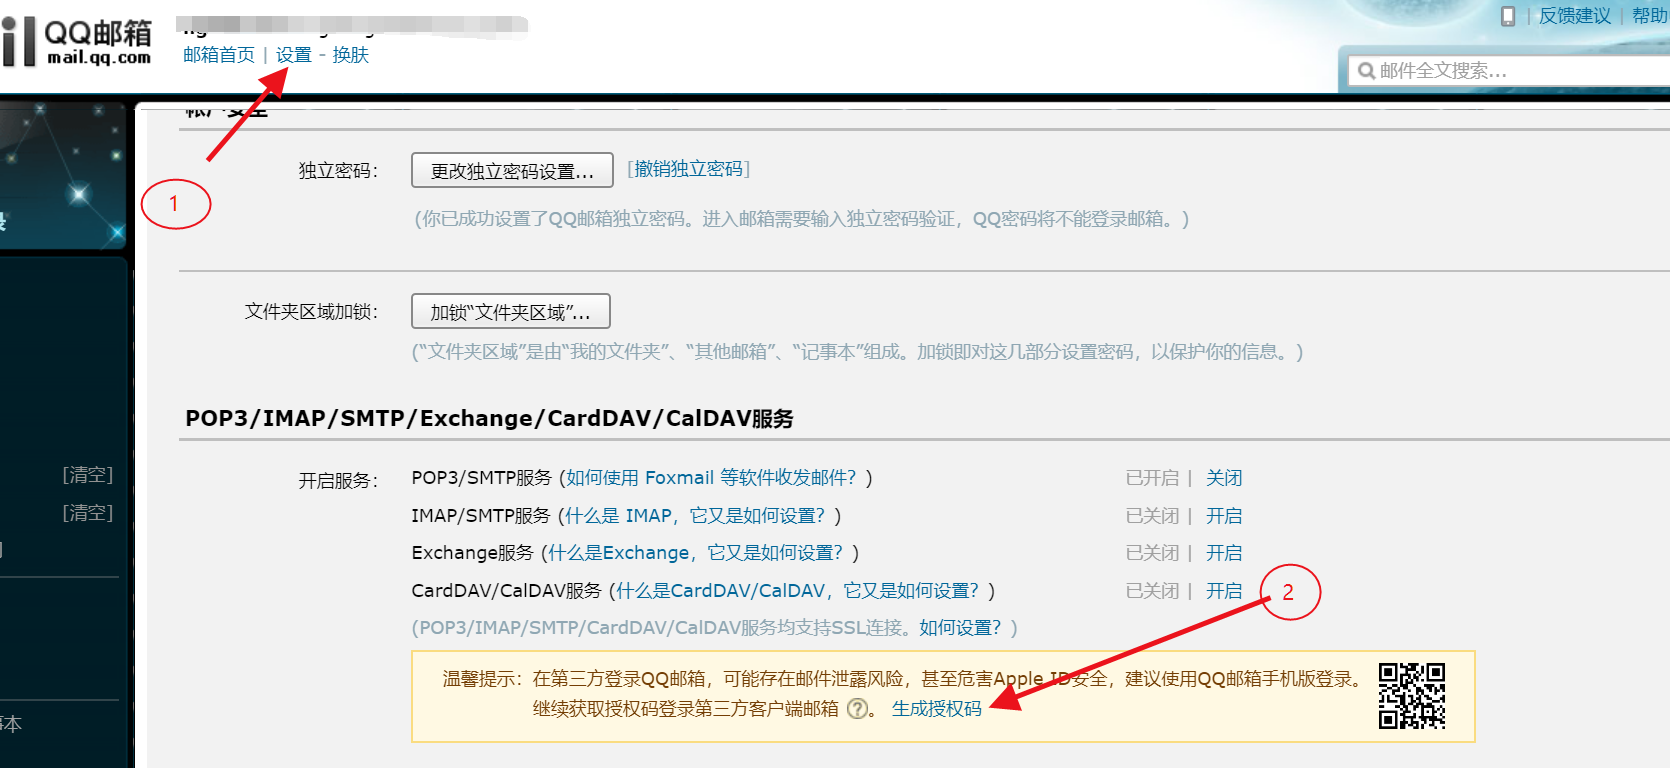
    <content type="html"><![CDATA[<p>疫情期间，学校要求每天都要提交体温等相关信息（如果不按时提交就会被全院通报😳，为了写脚本付出了仅有的一次），就想着写一个脚本放到服务器上每天定时自动提交，付诸自己好几个月前的想法。在这里记录自己学习、写脚本的过程，同时可怜一下学校的服务器。  </p><p>写这个脚本用到的技术，经过研究，可以用Python的selenim库或者urllib、requests库，但是后者需要更多的Web相关背景知识，由于我用进废退，脑中残存的Web相关知识只剩那些最基础的了，还是在实践中增长知识吧。</p><h3 id="1-尝试用selenium库"><a href="#1-尝试用selenium库" class="headerlink" title="1. 尝试用selenium库"></a>1. 尝试用selenium库</h3><p>　　这个库的学习成本极其低，一篇博客就可以入门了。<a href="https://www.jianshu.com/p/6c82c965c014">selenium教程</a>。看完之后就着手写脚本了。疫情通的整个填报动作分解如下：</p><pre><code>登录-&gt;获取地理位置-&gt;提交-&gt;确认提交</code></pre><hr><p>但是在脚本写完后却遇到了两个致命的问题，使我不得不转向使用urllib或requests库。</p><ul><li>问题1：Windows系统获取地理位置信息具有不稳定性，每次脚本运行到获取地理位置时大多数都是要么定位失败，要么定位不准，在这种情况下只能放弃这个方法了。</li><li>问题2：js里面弹出的确认框wapconfirm并不能被识别，好了，一朝回到解放前。<br><img src="https://lightpicture-1257032496.cos.ap-chengdu.myqcloud.com/blog/wapconfirmCode.png"></li></ul><h3 id="2-尝试用requests库"><a href="#2-尝试用requests库" class="headerlink" title="2.尝试用requests库"></a>2.尝试用requests库</h3><h4 id="i-分析整个表单的提交过程"><a href="#i-分析整个表单的提交过程" class="headerlink" title="i. 分析整个表单的提交过程"></a>i. 分析整个表单的提交过程</h4><p>据我现有的Web知识，从登录界面开始分析：<br>根据观察，在登录界面点击登录之前该网站下只有1个Cookie，<br><img src="https://lightpicture-1257032496.cos.ap-chengdu.myqcloud.com/blog/cookiesList0.png"><br>点击登录后，会将username和password用ajax技术通过post方式提交到验证登录网站，</p><p><img src="https://lightpicture-1257032496.cos.ap-chengdu.myqcloud.com/blog/login00.png"><br>验证通过后，该网站下的cookies由1个变成了4个，</p><p><img src="https://lightpicture-1257032496.cos.ap-chengdu.myqcloud.com/blog/cookiesList.png"></p><p>接着跳转向填报界面，在填报界面根据新增的Cookie，后台获取该用户的前一天的填报信息并填好，留下地理位置需要手动获取。获取位置信息后，将之以post方式提交到服务器。</p><hr><h4 id="ii-大致思路"><a href="#ii-大致思路" class="headerlink" title="ii. 大致思路"></a>ii. 大致思路</h4><h5 id="1-尝试直接复制出整个data包，以post方式提交至目标地址。"><a href="#1-尝试直接复制出整个data包，以post方式提交至目标地址。" class="headerlink" title="1)尝试直接复制出整个data包，以post方式提交至目标地址。"></a>1)尝试直接复制出整个data包，以post方式提交至目标地址。</h5><p>经过观察，data包算是解析出来了，但是这个数据命名实在是惨不忍睹（变量每个汉字拼音的首字母，现在是知道了阅读变量命令不清晰的程序的感觉，<del>口吐芬芳</del>）。用Notepad++的Compare插件对比 def（今天要提交的数据） 和 oldInfo（昨天的数据），发现多了后面4行数据，在页面找了一番后无果，索性在处理了一下def数据包，直接提交至目标网址，但服务器响应返回的却是整个填报系统的登录入口页面，说明在提交时，可能服务器还对提交者的身份进行验证，具体应该是通过验证请求头的Cookie，最终还是要进行模拟登录。<br><img src="https://lightpicture-1257032496.cos.ap-chengdu.myqcloud.com/blog/diff.png"></p><h5 id="2-进行模拟登陆，获取cookies后再提交信息，最后编写接口程序"><a href="#2-进行模拟登陆，获取cookies后再提交信息，最后编写接口程序" class="headerlink" title="2)进行模拟登陆，获取cookies后再提交信息，最后编写接口程序"></a>2)进行模拟登陆，获取cookies后再提交信息，最后编写接口程序</h5><p>经过分析，整个脚本流程图绘制如下：<br><img src="https://lightpicture-1257032496.cos.ap-chengdu.myqcloud.com/blog/submit.png"><br>完整代码见我的github<a href="https://github.com/lightingmoon/BlogSourceCode/blob/master/%E5%BE%AE%E4%BF%A1%E7%96%AB%E6%83%85%E9%80%9A%E8%87%AA%E5%8A%A8%E6%8F%90%E4%BA%A4/autoSubmitForm.py">明月光</a></p><p>邮箱授权码获取方法如下图：<br><img src="https://lightpicture-1257032496.cos.ap-chengdu.myqcloud.com/blog/getauthoritiedCode.png"><br>参考资料：<br>提取用户昨天提交的信息的正则表达式来自以下大佬博客，自己也该好好学一学正则表达式了。其中发送邮件方法也来自这篇博客，丰富了我的见识：<br><a href="https://blog.csdn.net/solitudi/article/details/105066215">记一次SCU疫情期间每日健康报送任务的自动化处理（一）</a></p>]]></content>
    
    
    <summary type="html">&lt;p&gt;疫情期间，学校要求每天都要提交体温等相关信息（如果不按时提交就会被全院通报😳，为了写脚本付出了仅有的一次），就想着写一个脚本放到服务器上每天定时自动提交，付诸自己好几个月前的想法。在这里记录自己学习、写脚本的过程，同时可怜一下学校的服务器。 写这个脚本用到的技术，经过研究，可以用Python的selenim库或者urllib、requests库，但是后者需…&lt;/p&gt;</summary>


    <category term="自动化脚本" scheme="https://www.lightdream.xyz/categories/%E8%87%AA%E5%8A%A8%E5%8C%96%E8%84%9A%E6%9C%AC/"/>
    
    
    <category term="Python爬虫" scheme="https://www.lightdream.xyz/tags/Python%E7%88%AC%E8%99%AB/"/>
    
    <category term="模拟登录" scheme="https://www.lightdream.xyz/tags/%E6%A8%A1%E6%8B%9F%E7%99%BB%E5%BD%95/"/>
    
    <category term="表单提交" scheme="https://www.lightdream.xyz/tags/%E8%A1%A8%E5%8D%95%E6%8F%90%E4%BA%A4/"/>
    
  </entry>
  
  <entry>
    <title>将Hexo博客部署至腾讯云服务器</title>
    <link href="https://www.lightdream.xyz/deployHexoProjecttoTencentCloud.html"/>
    <id>https://www.lightdream.xyz/deployHexoProjecttoTencentCloud.html</id>
    <published>2020-06-09T19:02:27.000Z</published>
    <updated>2021-11-17T02:57:46.828Z</updated>
    
    <content type="html"><![CDATA[<p>最近根据相关法律法规要求：域名在哪个云服务提供商备案就必须将该域名解析到云服务提供商的服务器，这波操作秀啊。这下白嫖了两年的Github Pages服务也用不了了，为了不放弃我这个域名。😐。弱弱地买了一个弱弱的学生(qióngbi)版低配服务器，花了一天时间将博客弱弱的部署到服务器上了。在这里总结一下自己踩的坑。  </p><h3 id="方法"><a href="#方法" class="headerlink" title="方法"></a>方法</h3><p>　　考虑到网上有很多写的不错的<strong>将Hexo博客部署到服务器</strong>的博客，我就不重复造轮子了。下面是一些我当时参考的博客的链接：</p><ul><li><a href="https://blog.csdn.net/qq_35561857/article/details/81590953">带你跳过各种坑，一次性把 Hexo 博客部署到自己的服务器</a></li><li><a href="https://blog.csdn.net/wx_15323880413/article/details/104576799?utm_medium=distribute.pc_relevant_t0.none-task-blog-BlogCommendFromMachineLearnPai2-1.nonecase&depth_1-utm_source=distribute.pc_relevant_t0.none-task-blog-BlogCommendFromMachineLearnPai2-1.nonecase">记录Hexo部署到阿里云服务器全过程</a></li><li><a href="https://blog.csdn.net/NoCortY/article/details/99631249?utm_medium=distribute.pc_relevant.none-task-blog-BlogCommendFromMachineLearnPai2-3.nonecase&depth_1-utm_source=distribute.pc_relevant.none-task-blog-BlogCommendFromMachineLearnPai2-3.nonecase">从零搭建Hexo博客并部署阿里云服务器（奶妈级教学）</a></li><li><a href="https://blog.csdn.net/StaunchKai/article/details/82878928?utm_medium=distribute.pc_relevant.none-task-blog-BlogCommendFromMachineLearnPai2-2.nonecase&depth_1-utm_source=distribute.pc_relevant.none-task-blog-BlogCommendFromMachineLearnPai2-2.nonecase">Hexo 博客部署到腾讯云服务器全流程</a></li></ul><p>　　<strong>只要一步步仔细跟着教程走，应该不会遇到问题。如果遇到了问题，可以参考博客下面评论区或者在搜索引擎上搜索。最后还是解决不了的话，可以请教周围的大神或者在教程博客评论区留言。感谢互联网，让我能站在巨人的肩膀上</strong>。</p><h3 id="踩坑-跳出坑"><a href="#踩坑-跳出坑" class="headerlink" title="踩坑-&gt;跳出坑"></a>踩坑-&gt;跳出坑</h3><h4 id="1-安装nginx中间的问题"><a href="#1-安装nginx中间的问题" class="headerlink" title="1.安装nginx中间的问题"></a>1.安装nginx中间的问题</h4><p>在解压完 [nginx-1.15.2] 包后执行指令：</p><pre><code>./configure --prefix=/usr/local/nginx --with-http_stub_status_module --with-http_ssl_module --with-file-aio --with-http_realip_module</code></pre><p>会出现类似于这样的错：</p><pre><code>checking for OS + Linux 3.10.0-957.el7.x86_64 x86_64 checking for *** ... not found ./config</code></pre><p>中间的***可以是任何软件，此时只需要手动安装那些软件即可，例如：</p><pre><code>yum -y install gcc</code></pre><h4 id="2-万恶的403错误"><a href="#2-万恶的403错误" class="headerlink" title="2.万恶的403错误"></a>2.万恶的403错误</h4><p>　　这个错误应该是相当玄学了，如果没有这个错，我一下午应该就部署好了。反思一下，其实自己一来对linux系统操作不精通，二来对Git操作也不精通，三来对服务器nginx了解也有限…大神的博客也不可能面面俱到，所以在自己知识有限的情况下，只能找寻前人解决的经验了。<br>　　这个错误，我在试遍了评论区的方法后没有作用，后来不太清楚过程的最终解决了。所以现在只能模糊的猜测当时自己修改的条件。<br>　　我在修改好本地的配置文件后，运行以下指令：</p><pre><code>hexo cl &amp;&amp; hexo g -d</code></pre><p>在命令运行后并没有发生错误，我登录进服务器发现网站根目录并没有文件，在我用git上传成功的条件下，网站根目录并没有文件，这说明建立的裸露（bare）仓库的钩子(hooks)没有作用，这就有两个原因：</p><ol><li>写的钩子，即linux脚本没有作用，可能没有执行权限。</li><li>用户git没有博客根目录的权限。</li></ol><p>所以，我从这两个角度入手：<br>将教程中关于这两部分的步骤检查并重新进行了一遍，设置完后让服务器nginx 运行reload指令一下。之后我访问我的服务器的80端口，在失望透底之下竟然出现柳暗花明——访问成功了。</p><hr><p>最终解释：写的钩子没有运行，在服务器手动运行一下折衷。还在找解决办法！</p><hr><p>找到问题了，表示很无语。原来是那个钩子的名字必须是post-receive，当时自己可能太着急了，把文件名打错了。我错了。</p><hr><p>之后的工作就是等域名的证书验证好了配置HTTPS</p><hr><p>Ok，HTTPS配置好了，具体没有踩太大的坑。主要参考以下文章：</p><ul><li><a href="https://blog.csdn.net/Tencentfly/article/details/87990722?utm_medium=distribute.pc_relevant.none-task-blog-BlogCommendFromMachineLearnPai2-1.nonecase&depth_1-utm_source=distribute.pc_relevant.none-task-blog-BlogCommendFromMachineLearnPai2-1.nonecase">腾讯云服务器申请SSL证书, 配置Nginx, 实现HTTPS</a></li><li><a href="https://blog.csdn.net/yelin042/article/details/78584172?utm_medium=distribute.pc_relevant.none-task-blog-baidujs-1">腾讯云服务器https证书安装指引</a></li></ul>]]></content>
    
    
    <summary type="html">&lt;p&gt;最近根据相关法律法规要求：域名在哪个云服务提供商备案就必须将该域名解析到云服务提供商的服务器，这波操作秀啊。这下白嫖了两年的Github Pages服务也用不了了，为了不放弃我这个域名。😐。弱弱地买了一个弱弱的学生(qióngbi)版低配服务器，花了一天时间将博客弱弱的部署到服务器上了。在这里总结一下自己踩的坑。 方法 考虑到网上有很多写的不错的 将Hex…&lt;/p&gt;</summary>


    <category term="Web技术" scheme="https://www.lightdream.xyz/categories/Web%E6%8A%80%E6%9C%AF/"/>
    
    
    <category term="资源集合" scheme="https://www.lightdream.xyz/tags/%E8%B5%84%E6%BA%90%E9%9B%86%E5%90%88/"/>
    
    <category term="踩坑记录" scheme="https://www.lightdream.xyz/tags/%E8%B8%A9%E5%9D%91%E8%AE%B0%E5%BD%95/"/>
    
  </entry>
  
  <entry>
    <title>三省吾身，一往无前</title>
    <link href="https://www.lightdream.xyz/accelerateMyLife.html"/>
    <id>https://www.lightdream.xyz/accelerateMyLife.html</id>
    <published>2020-05-24T07:06:37.000Z</published>
    <updated>2026-08-23T04:31:01.770Z</updated>
    
    <content type="html"><![CDATA[<p>下面这篇文章我就讲述自己的大学期间的情况。一来是自己做记录，以后看的时候能笑一笑，唏嘘一下（我喜欢回忆但不沉浸回忆）。二来是供有缘人看官来乐一乐的，以期对你有所启发（星爷的喜剧正是如此）。  </p><h3 id="总述"><a href="#总述" class="headerlink" title="总述"></a>总述</h3><p>　　说说我大学四年吧。我是从大山里面一步步考出来的孩子。回家时，周围繁华的高楼大厦一一同我挥手告别，家乡寂静的群山峻岭款款向我纷至沓来。从繁华到寂静，从热闹到冷清，从高楼林立到群山环绕，心灵也从狂热归于沉寂。这巨大的落差给予了我什么？百感交集（这段话酝酿了好几年，终于写了出来）。但是我还是想描述一下：就是当你在过一种生活时，恍然间观察到另一个人的生活，这时会感叹：原来人生还可以这样过啊？🤕😅😇</p><h4 id="分述一："><a href="#分述一：" class="headerlink" title="分述一："></a>分述一：</h4><p>　　大一，在学习上我没有定什么目标（谁知道我那时怎么想的…时间再回溯一下，我初高中那会也是一样），所以更多的是受周围同学的感染以及授课老师的热情带动我认真听课、课后认真完成作业。所幸没有落下太多。周末自己也在图书馆看一些脑子灵光一动突然想看的书。结果：大部分书还是能看完的，少部分书实在是看不下去（是我的问题），我也不会勉强自己看下去。那时我也会去跑步，基本都是和军训时认识的朋友小钊一起跑的。在跑步时，我从他的身上学到的就是能够不顾一切去跑步，用一次一次的坚持去突破自己的极限。平常也会和军训时认识的一个朋友小宇一起开黑打游戏，其乐融融。体育2也在经历了一件曲折的事情后被取消考试资格了，但是那是并没有意识到事情的严重性，反而找了一些理由给自己搪塞过去了。从现在来看，那时的我和以前一样，都是那么懵懂无知。虽说用现在的眼光去评判过去是不公平的，但是我还是想评判。现在只能祈祷自己不要多做以后看来会骂自己蠢的事！</p><hr><ul><li>我想说①：<br><strong>1. 目标。凡事需要目标，否则就是无所事事。</strong><br><strong>2. 坚持。人之于事，常于几成而败之。悲哉！</strong><br><strong>3. 控制。在衡量每一件事的后果之后，会不会能更好的控制自己。</strong></li></ul><hr><h4 id="分述二"><a href="#分述二" class="headerlink" title="分述二"></a>分述二</h4><p>　　大二，产生了一个波澜。在学习上，我发现自己有时候脑子不太够用了。因为我有一个习惯，在获取知识时，我会不加整理的全部塞进大脑。我有一个<strong>妄想</strong>：当接触过多的信息而不加整理时，大脑触底会自动进行整理，这样我就省事多了（打完这些字，我差点笑出声来）。一来那会儿我可能公众号看多了，开始焦虑未来了。于是自己搭了这个博客，鼓励自己能够好好学技术。二来我对体育2被取消考试资格那件事一直念念不忘，自己仔细思考下，还是自己的问题，明明可以再争取和老师解释一下事情经过，但是自己就是不争气没去解释！（越想越气，锤自己一下解了气！）。那时也开始好好学技术了，从课程设计开始，我都会坚持用自己的最大的能力来完成每一门课设。当时眼界比较狭窄，觉得开发桌面应用程序贼6，于是当时自学了MFC和Java swing，自学过程中也有一段曲折的过程，所幸自己最终没有浅尝辄止，而是选择了风雨兼程。我依旧在操场上跑步，只是和小钊一起跑得比较少了，各种原因，两个人节奏不一致了。依旧在图书馆看了一些书，不过开始从文学类转向科幻、技术类书籍了。冥冥之中好像燃起了一些希望，弥足珍贵。</p><hr><ul><li>我想说②：</li></ul><ol><li><strong>只需要找到一个目标，向前冲！</strong></li><li><strong>考虑事情的重要性的一个重要维度就是时间维度，它对你在未来的影响。</strong></li><li><strong>如果自己真的很渴望，那就不轻言弃的去追吧。</strong></li></ol><hr><h4 id="分述三"><a href="#分述三" class="headerlink" title="分述三"></a>分述三</h4><p>　　大三，应该是最为精彩的一年吧。我在大二下时，恍然觉得自己的大学还一事未成，想着在大三拿一次奖学金。于是上半学期自己上课认真听讲，下来自己再去图书馆温习，甚至到了要压缩编程的时间的地步了。到了考试周，第一门考试早早的考完了，取得了相当不错的成绩，这似乎鼓励了我后面的考试。当考第二门组成原理时，当时状态极差，加上这门课好像完全和我的品格相逆（总是学不太明白），中午为了复习甚至没吃饭、没有午睡。下午报应就来了，当时做题时间不知怎的不够，最后两道10分大题都没时间做，想来估计是自己画图太慢了（我甚至画图时都会考虑内存片的长宽比例），然后考完心态就开始崩了，破罐就开始摔了。😭之后几门考试一手促成了我崩心态的全部过程。就让以后的我稳如老狗吧。归根到底还是因为自己没有坚持下来。在寒假时，我痛定思痛地把算法笔记刷一遍，准备开学再考一次CSP，将分数刷高一些，寒假自己也是付出了极大的努力，甚至在给自己的压力之下开始掉头发了（感觉那时候掉的头发比考研期间掉的还多），开学以后报名CSP，当时报名完了就显示审核中，我也没多想，结果考试当天早上，室友冷不丁的问我一句报名报上了吗？我的心猛地跳了一下，一种不好的预感从心底涌出来！登上网站一看，果然没有报上名，原来当时提交报名后还要再进行确认才能被审核，这是我始料未及的…也还是怪自己前几天怎么没有进去看一下审核结果。于是，当天下午，我果断地开启了我的考研生涯。中间考研的整个经历又可以写一篇了。何乐而又不为呢？</p><ul><li>我想说③：</li></ul><ol><li><strong>不要因小失大，最重要的是坚持下去、坚守初心</strong></li><li><strong>自己要对每一件自己的事负责到底，没人能够帮你。</strong></li><li><strong>当断不断，必受其患。</strong></li></ol>]]></content>
    
    
    <summary type="html">&lt;p&gt;下面这篇文章我就讲述自己的大学期间的情况。一来是自己做记录，以后看的时候能笑一笑，唏嘘一下（我喜欢回忆但不沉浸回忆）。二来是供有缘人看官来乐一乐的，以期对你有所启发（星爷的喜剧正是如此）。 总述 说说我大学四年吧。我是从大山里面一步步考出来的孩子。回家时，周围繁华的高楼大厦一一同我挥手告别，家乡寂静的群山峻岭款款向我纷至沓来。从繁华到寂静，从热闹到冷清，从高…&lt;/p&gt;</summary>


    <category term="静夜思" scheme="https://www.lightdream.xyz/categories/%E9%9D%99%E5%A4%9C%E6%80%9D/"/>
    
    
    <category term="自我省悟" scheme="https://www.lightdream.xyz/tags/%E8%87%AA%E6%88%91%E7%9C%81%E6%82%9F/"/>
    
    <category term="自我调节" scheme="https://www.lightdream.xyz/tags/%E8%87%AA%E6%88%91%E8%B0%83%E8%8A%82/"/>
    
  </entry>
  
  <entry>
    <title>一些Word操作技巧</title>
    <link href="https://www.lightdream.xyz/someWordOperationTips.html"/>
    <id>https://www.lightdream.xyz/someWordOperationTips.html</id>
    <published>2020-05-02T01:54:48.000Z</published>
    <updated>2020-05-24T22:11:22.179Z</updated>
    
    <content type="html"><![CDATA[<p>最近想吐槽一下当今的软件设计技术还是太死板。且听我举一例：我向某翻译软件上传一个word文件(.docx)（是一篇英文论文，里面图片比较多），翻译好后还是下载的Word(.docx)格式。我打开后开始对照修改，改到中间有部分内容缺失（超过那一页的边界之外），我准备打回车把那部分内容顶到下一页去，结果死活顶不下去。  </p><p>仔细一看，好家伙，原来那个翻软件给生成了一个表格，只有一个格子，它把整个翻译后的内容放进格子里，那个格子超过了Word纸张大小，只能看见一部分内容。所以你打回车是永远也顶不到下一页，只会在看不见的地方增长格子大小。明白了以后，<del>我就口吐芬芳了一句</del>，从此与这类软件做路人。虽说可以用表格来排版，但是您也要用的标准啊。这样做简直坑人于无形。下面开始本篇主题。</p><h3 id="1-关于设置页码"><a href="#1-关于设置页码" class="headerlink" title="1. 关于设置页码"></a>1. 关于设置页码</h3><p>1.1 从任意页开始设置页码<br>　　在功能区<strong>布局-页面设置-分隔符-分节符-下一页</strong>，接着在该页面<strong>插入页码</strong>，之后双击这一页的页码，在功能区<strong>设计-链接到前一节</strong>，取消<strong>链接到前一节</strong>，再删除前一页的页码即可。<br>1.2 设置奇偶页不同的页眉页脚，再添加连续的页码<br>　　其实就是分别在第一页添加<strong>从1开始的页码、第二页从2开始的页码</strong>，但是也要注意，文档内不要有多余的分节符，否则会很麻烦（Word在添加一些比较大的图片时候会自动添加分节符，有他的道理吧）。具体查看分节符的方法：<strong>功能区的文件-选项-显示-始终在屏幕上显示这些格式标记-显示所有格式标记</strong>，选中它即可。一般分节符长这样子：<br><img src="/../image/SectionBreak.png" alt="image"><br>想要删除分节符，将光标移至分节符后面，按<strong>delete</strong>即可</p><h3 id="2-关于Word输入公式"><a href="#2-关于Word输入公式" class="headerlink" title="2. 关于Word输入公式"></a>2. 关于Word输入公式</h3><p>　　按Alt 和 &#x3D; 键，即可输入Latex公式，且微软支持的很好，渲染的也很漂亮。但是却只支持.docx文件，一般学校都用的是.doc文件。不过在将.docx文件转为.doc文件时，Word会自动将Latex公式转化为图片，支持的很好。欣赏一下Word输入的公式吧。<br><img src="/../image/Formula.png" alt="Formula"></p>]]></content>
    
    
    <summary type="html">&lt;p&gt;最近想吐槽一下当今的软件设计技术还是太死板。且听我举一例：我向某翻译软件上传一个word文件(.docx)（是一篇英文论文，里面图片比较多），翻译好后还是下载的Word(.docx)格式。我打开后开始对照修改，改到中间有部分内容缺失（超过那一页的边界之外），我准备打回车把那部分内容顶到下一页去，结果死活顶不下去。 仔细一看，好家伙，原来那个翻软件给生成了一个…&lt;/p&gt;</summary>


    <category term="备忘" scheme="https://www.lightdream.xyz/categories/%E5%A4%87%E5%BF%98/"/>
    
    
    <category term="Word排版" scheme="https://www.lightdream.xyz/tags/Word%E6%8E%92%E7%89%88/"/>
    
  </entry>
  
  <entry>
    <title>基于高斯扰动的粒子群优化算法算法</title>
    <link href="https://www.lightdream.xyz/GanssianDisturbancePSO.html"/>
    <id>https://www.lightdream.xyz/GanssianDisturbancePSO.html</id>
    <published>2020-04-11T04:53:28.000Z</published>
    <updated>2020-06-22T06:18:49.965Z</updated>
    
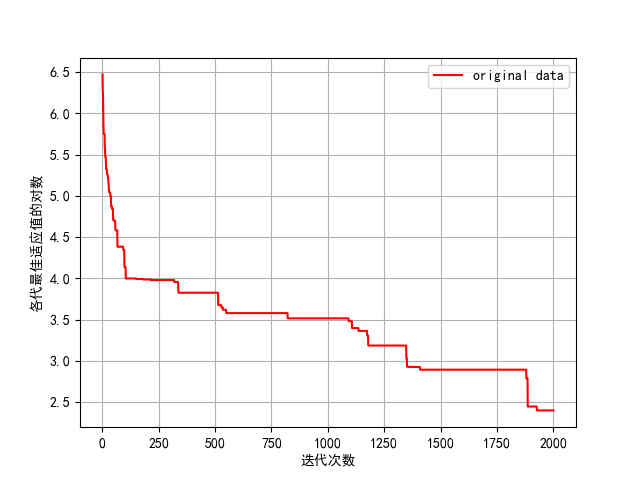
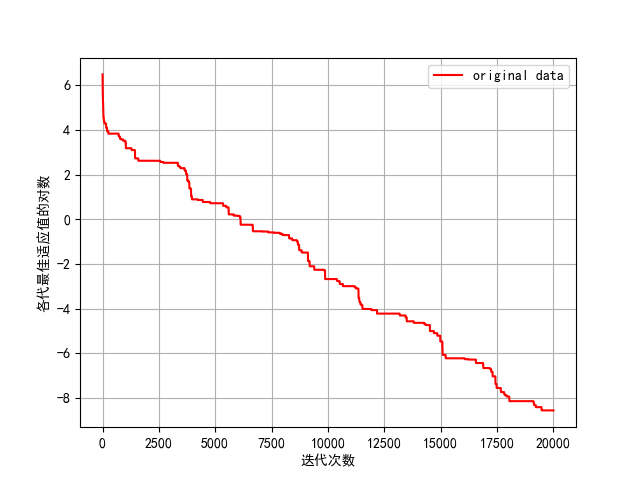
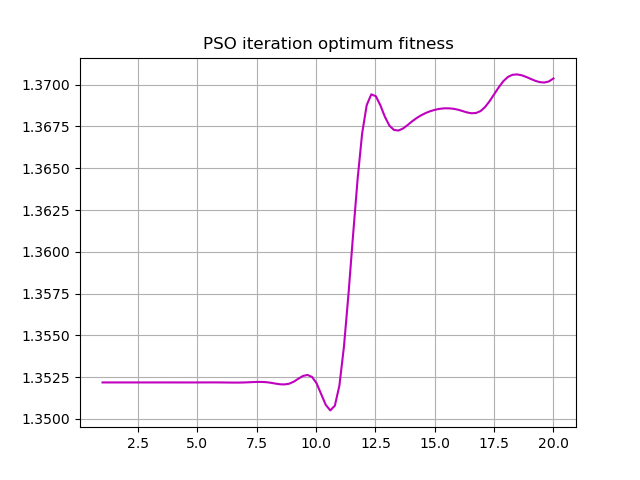
    <content type="html"><![CDATA[<p>在碎片时间被智能手机APP大肆压榨的时代，我们只能从增强自我管理开始。以上是自己最近的一些思考。欢迎一起来讨论（👉👇）。下面开始本篇主题</p><h2 id="算法介绍"><a href="#算法介绍" class="headerlink" title="算法介绍"></a>算法介绍</h2><p>基于高斯扰动的粒子群算法(Particle Swarm Optimization based on Ganssian Disturbance, GDPSO)^<a href="#fn_1">1</a> ^，其很巧妙的在标准粒子群算法速度迭代公式基础上增加一个高斯扰动，使得算法收敛速度加快，且既能帮助算法有效跳出局部最优值，又能扩大粒子搜索范围。<br>具体GDPSO速度迭代公式如下：</p><p>$$v_{id}^{(t+1)} &#x3D; \omega v_{id}^{(t)} + c_{1}r_{1}(p_{id}^{(t)} + r_{2}gauss_{id}^{(t)}-x_{id}^{(t)})\<br>    +c_{2}r_{3}(p_{gd}^{(t)}-x_{id}^{(t)})$$$$x_{id}^{(t+1)} &#x3D; x_{id}^{(t)} + v_{id}^{(t+1)}$$$$gauss_{id}^{(t)} &#x3D; r_4gaussian(\mu, \sigma ^{2})$$</p><p>其中$\mu &#x3D; 0，\sigma ^{2} &#x3D; |p_{id}|$，其它参数与标准粒子群算法一致。<br>据算法分析，令$c_1 &#x3D; c_2 &#x3D; \lambda $，当算法参数满足：</p><p>$$\left{ {| \omega | &lt; 1}\atop<br> {0 &lt; \lambda &lt; 2 + 2\omega}\right.$$</p><p>且个体极值、高斯扰动值和全局极值保持不变时，算法在$E[x]^{*}$处渐进稳定</p><h2 id="算法进化模式分析"><a href="#算法进化模式分析" class="headerlink" title="算法进化模式分析"></a>算法进化模式分析</h2><p>令$c_1 &#x3D; c_2$， $r_1 &#x3D; r_2 &#x3D; r_3 &#x3D; r$，那么种群所有粒子可分以下情况：</p><ol><li>粒子$i$当前位置为其历史最优位置，但不是全局最优位置，即$x_{id} &#x3D; p_{id}, x_{id} \not&#x3D; p_{gd}$。<br>则算法进化模式为 ： $$v_{id}^{(t+1)} &#x3D; \omega v_{id}^{(t)} + c_{1}r(p_{id}^{(t)} + rgauss_{id}^{(t)}-x_{id}^{(t)})\<br>+c_{2}r(p_{gd}^{(t)}-x_{id}^{(t)})\<br>&#x3D;  \omega v_{id}^{(t)} + c_1r^2gauss_{id}^{(t)} + c_{2}r(p_{gd}^{(t)}-x_{id}^{(t)})$$</li></ol><p>此时GDPSO速度增量比PSO更大，其全局搜索能力更强，收敛速度更快，且高斯扰动选项能帮助算法逃离局部最优。</p><ol><li>粒子$i$当前位置为其历史最优位置，同时又是全局最优位置，即$x_{id} &#x3D; p_{id} &#x3D; p_{gd}$。<br>则算法进化模式为：</li></ol><p>$$v_{id}^{(t+1)} &#x3D; \omega v_{id}^{(t)} + c_{1}r(p_{id}^{(t)} + rgauss_{id}^{(t)}-x_{id}^{(t)})\<br>+c_{2}r(p_{gd}^{(t)}-x_{id}^{(t)})\<br> &#x3D; \omega v_{id}^{(t)} + c_1r^2gauss_{id}^{(t)}$$</p><p>此时GDPSO速度项比标准PSO增加了一个高斯扰动值，有助于算法跳出当前局部最优解。</p><ol><li>粒子$i$当前位置不是其历史最优位置，同时又不是全局最优位置，但是粒子$i$的历史最优位置恰好是全局最优位置，即$x_{id} \not&#x3D; p_{id}，x_{id} \not&#x3D; p_{gd}, 且p_{id} &#x3D; p_{gd}$。<br>此时算法的进化模式为：$$v_{id}^{(t+1)} &#x3D; \omega v_{id}^{(t)} + c_{1}r(p_{id}^{(t)} + rgauss_{id}^{(t)}-x_{id}^{(t)})\<br>+c_{2}r(p_{gd}^{(t)}-x_{id}^{(t)})\<br>&#x3D;\omega v_{id}^{(t)} + 2c_1r(p_{gd}^{(t)} - x_{id}^{(t)} + \frac{1}{2}rgauss_{id}^{(t)})$$</li></ol><p>此时，对于PSO，种群中粒子完全向当前全局最优值移动，很容易陷入局部最优值。而GDPSO一方面保证其收敛速度比PSO更快，另一方面由于增加了高斯扰动项，很好的避免了算法陷入局部最优值。</p><ol><li>粒子 $i$当前位置不是其历史最优位置，同时又不是全局最优位置，且粒子$i$的历史最优位置不是当前种群全局最优位置，即<br>$x_{id} \not&#x3D; p_{id}，x_{id} \not&#x3D; p_{gd}，且 p_{id} \not&#x3D; p_{gd}$ 。算法的进化模式为：</li></ol><p>$$v_{id}^{(t+1)} &#x3D; \omega v_{id}^{(t)} + c_{1}r(p_{id}^{(t)} + rgauss_{id}^{(t)}-x_{id}^{(t)})\<br>+c_{2}r(p_{gd}^{(t)}-x_{id}^{(t)})\<br>&#x3D; \omega v_{id}^{(t)} + c_{1}r(p_{id}^{(t)}-x_{id}^{(t)})+c_{2}r(p_{gd}^{(t)}-x_{id}^{(t)})\<br>+c_1r^2gauss_{id}^{(t)}$$</p><p>此时相比于PSO的速度项，GDPSO增加了一个高斯扰动项，其可以帮助粒子扩大搜索范围，增强全局寻优能力，且提高了算法收敛速度。</p><h2 id="算法实现"><a href="#算法实现" class="headerlink" title="算法实现"></a>算法实现</h2><ol><li>选择测试函数<br>$Griewank$函数(取值范围为$[一600，600]$，理论最优值为0)：$$f(x) &#x3D; \frac{1}{4000}\sum_{i&#x3D;1}^{D}x_i^2 - \prod_{i&#x3D;1}^{D}cos(\frac{x_i}{\sqrt{i}}) + 1$$</li><li>环境<br>JetBrains PyCharm + Python3.7</li><li>参数设置</li></ol><pre><code class="lang-python">W = 0.6  # 惯性权重，根据论文会随着迭代次数改变C1 = 2.0  # 认知C2 = 2.0  # 社会P = []  # 第i个粒子搜索到的历史最优位值Pifitness = []  # 记录第i个粒子搜索到的历史最优值Pg = []  # 整个粒子群搜索到的最优位值Pgfitness = float(&#39;inf&#39;)  # 记录整个粒子群搜索到的最优值PgfitnessRecord = []intervalMin = -600  # 种群搜索区间下限intervalMax = 600  # 种群搜索区间上限Vmin = -120  # 粒子的速度下限Vmax = 120  # 粒子的速度上限N = 10  # 粒子个数T = 2000  # 迭代次数D = 30  # 粒子的维度</code></pre><ol><li>实验结果</li></ol><p><img src="/../image/GDPSO_2000.png" alt="GDPSO_2000"></p><blockquote><p>GDPSO算法迭代2000次</p></blockquote><p><img src="/../image/GDPSO_20000.png" alt="GDPSO_20000"></p><blockquote><p>GDPSO算法迭代20000次</p></blockquote><p>完整实验代码见我的<a href="https://github.com/lightingmoon/BlogResourceCode/tree/master/GDPSO">Github</a></p><blockquote><p>^1^. 通讯作者：孙辉，邮箱: <a href="mailto:&#x73;&#x75;&#110;&#x68;&#x75;&#105;&#x40;&#x6e;&#x69;&#x74;&#46;&#x65;&#100;&#117;&#46;&#x63;&#x6e;">&#x73;&#x75;&#110;&#x68;&#x75;&#105;&#x40;&#x6e;&#x69;&#x74;&#46;&#x65;&#100;&#117;&#46;&#x63;&#x6e;</a> <a href="#reffn_1" title="Jump back to footnote [1] in the text.">↩</a></p></blockquote>]]></content>
    
    
    <summary type="html">&lt;p&gt;在碎片时间被智能手机APP大肆压榨的时代，我们只能从增强自我管理开始。以上是自己最近的一些思考。欢迎一起来讨论（👉👇）。下面开始本篇主题 算法介绍 基于高斯扰动的粒子群算法(Particle Swarm Optimization based on Ganssian Disturbance, GDPSO)^ 1 ^，其很巧妙的在标准粒子群算法速度迭代公式基…&lt;/p&gt;</summary>


    <category term="优化算法" scheme="https://www.lightdream.xyz/categories/%E4%BC%98%E5%8C%96%E7%AE%97%E6%B3%95/"/>
    
    
    <category term="PSO" scheme="https://www.lightdream.xyz/tags/PSO/"/>
    
    <category term="高斯扰动学习策略" scheme="https://www.lightdream.xyz/tags/%E9%AB%98%E6%96%AF%E6%89%B0%E5%8A%A8%E5%AD%A6%E4%B9%A0%E7%AD%96%E7%95%A5/"/>
    
  </entry>
  
  <entry>
    <title>Python append()方法与深、浅拷贝</title>
    <link href="https://www.lightdream.xyz/Python-list.html"/>
    <id>https://www.lightdream.xyz/Python-list.html</id>
    <published>2020-03-15T04:01:55.000Z</published>
    <updated>2020-05-24T22:11:18.645Z</updated>
    
    <content type="html"><![CDATA[<p>最近在用Python实现粒子群算法时，我要用列表记录粒子群算法迭代时种群的情况，但是却发生了一些问题。调试浪费了一些时间，故在此记录下来。  </p><h3 id="背景"><a href="#背景" class="headerlink" title="背景"></a>背景</h3><p>这段Python代码:</p><pre><code class="lang-python">&gt;&gt;&gt; list1 = []&gt;&gt;&gt; list2 = [1,2,3]&gt;&gt;&gt; list1.append(list2) # 将list2追加到list1尾部&gt;&gt;&gt; print(list1)[[1, 2, 3]]&gt;&gt;&gt; list2[1] = 0        # 改变list2第二个值&gt;&gt;&gt; print(list1)[[1, 0, 3]]</code></pre><p>　　问题是：我将list2加入到list1后面，再去改变list2第2个元素值，结果list1中对应索引位置元素也发生改变。想想粒子群算法迭代30次寻到最优值后，但种群却一直没变，诡异至极。</p><h3 id="深入剖析"><a href="#深入剖析" class="headerlink" title="深入剖析"></a>深入剖析</h3><p>继续看这段代码：</p><pre><code class="lang-python">&gt;&gt;&gt; id(list2) == id(list1[0])True</code></pre><p>　　这表明list2在内存中的起始位置与list1[0]在内存中的位置是一样的。实际上列表list1的append()方法是将list2进行浅拷贝，把list2引用直接赋值给list1[0], list2直接作为一个对象追加到list1[0]上。这样改变list2也会改变list1[0]，这就很危险了。</p><h3 id="解决方案"><a href="#解决方案" class="headerlink" title="解决方案"></a>解决方案</h3><p>　　导入copy模块，对list2进行深拷贝再追加到list1尾部即可：</p><pre><code class="lang-python">&gt;&gt;&gt; import copy&gt;&gt;&gt; list1 = []&gt;&gt;&gt; list2 = [1,2,3]&gt;&gt;&gt; list1.append(copy.deepcopy(list2))&gt;&gt;&gt; list1[[1, 2, 3]]&gt;&gt;&gt; list2[0] = 0&gt;&gt;&gt; list1[[1, 2, 3]]&gt;&gt;&gt; list2[0, 2, 3]</code></pre><p>　　深拷贝即是为list2创建一个副本再追加到list1尾部，这样list2与list1[0]就不再是同一个引用了。</p>]]></content>
    
    
    <summary type="html">&lt;p&gt;最近在用Python实现粒子群算法时，我要用列表记录粒子群算法迭代时种群的情况，但是却发生了一些问题。调试浪费了一些时间，故在此记录下来。 背景 这段Python代码: &amp;gt;&amp;gt;&amp;gt; list1 = [] &amp;gt;&amp;gt;&amp;gt; list2 = [1,2,3] &amp;gt;&amp;gt;&amp;gt; list1.append(list2) # 将list2追…&lt;/p&gt;</summary>


    <category term="Python" scheme="https://www.lightdream.xyz/categories/Python/"/>
    
    
    <category term="Python" scheme="https://www.lightdream.xyz/tags/Python/"/>
    
    <category term="list" scheme="https://www.lightdream.xyz/tags/list/"/>
    
    <category term="列表" scheme="https://www.lightdream.xyz/tags/%E5%88%97%E8%A1%A8/"/>
    
  </entry>
  
  <entry>
    <title>关于网易云音乐外链播放器的一些问题</title>
    <link href="https://www.lightdream.xyz/NeteaseMusicOutchainPlayer.html"/>
    <id>https://www.lightdream.xyz/NeteaseMusicOutchainPlayer.html</id>
    <published>2020-03-09T03:55:45.000Z</published>
    <updated>2020-05-24T22:11:08.032Z</updated>
    
    <content type="html"><![CDATA[<p>最近想更新一下博客sidebar里面音乐插件的歌单，遇到一些问题，在以前遇到过，但是却忘了。故以防以后再忘，写下博客以记录。  </p><h3 id="1-关于如何创建网易云音乐歌单外链播放器"><a href="#1-关于如何创建网易云音乐歌单外链播放器" class="headerlink" title="1.关于如何创建网易云音乐歌单外链播放器"></a>1.关于如何创建网易云音乐歌单外链播放器</h3><ol><li>打开网页版<a href="https://music.163.com/">网易云音乐</a>，登上自己账号，并找到自己想要制作外链播放器的歌单，按以下流程来：<br><img src="/image/netease1.png">{width&#x3D;”auto” height&#x3D;”auto”}</li></ol><hr><p><img src="/image/netease2.png">{width&#x3D;”auto” height&#x3D;”auto”}</p><hr><p><img src="/image/netease3.png">{width&#x3D;”auto” height&#x3D;”auto”}</p><hr><p><img src="/image/netease4.png">{width&#x3D;”auto” height&#x3D;”auto”}</p><hr><p><img src="/image/netease5.png">{width&#x3D;”auto” height&#x3D;”auto”}</p><hr><p>单曲外链播放器也类似。进入制作外链播放器后就按照官方教程走即可。</p><h3 id="2-其中最需谨记的就是歌单里面的歌曲必须有版权可以用来制作外链播放器，如果忽视了这个，那么会产生以下两个问题："><a href="#2-其中最需谨记的就是歌单里面的歌曲必须有版权可以用来制作外链播放器，如果忽视了这个，那么会产生以下两个问题：" class="headerlink" title="2. 其中最需谨记的就是歌单里面的歌曲必须有版权可以用来制作外链播放器，如果忽视了这个，那么会产生以下两个问题："></a>2. <strong>其中最需谨记的就是歌单里面的歌曲必须有版权可以用来制作外链播放器，如果忽视了这个，那么会产生以下两个问题：</strong></h3><ul><li>不能制作外链播放器，提示没有版权。</li><li>就算制作成功了，但不能进行播放。最难受的就是你点击播放时，播放器不会进行提示。百思不得其解之时，忽然想起以前遇到这个问题。但是也浪费了好多时间。</li></ul>]]></content>
    
    
    <summary type="html">&lt;p&gt;最近想更新一下博客sidebar里面音乐插件的歌单，遇到一些问题，在以前遇到过，但是却忘了。故以防以后再忘，写下博客以记录。 1.关于如何创建网易云音乐歌单外链播放器 打开网页版 网易云音乐 ，登上自己账号，并找到自己想要制作外链播放器的歌单，按以下流程来： {width&amp;#x3D;”auto” height&amp;#x3D;”auto”} {width&amp;#x3D…&lt;/p&gt;</summary>


    <category term="备忘" scheme="https://www.lightdream.xyz/categories/%E5%A4%87%E5%BF%98/"/>
    
    
    <category term="备忘" scheme="https://www.lightdream.xyz/tags/%E5%A4%87%E5%BF%98/"/>
    
    <category term="工具" scheme="https://www.lightdream.xyz/tags/%E5%B7%A5%E5%85%B7/"/>
    
  </entry>
  
  <entry>
    <title>致敬：高山流水</title>
    <link href="https://www.lightdream.xyz/ToHailBosomFriends.html"/>
    <id>https://www.lightdream.xyz/ToHailBosomFriends.html</id>
    <published>2020-03-04T08:27:07.000Z</published>
    <updated>2020-05-24T22:11:41.199Z</updated>
    
    <content type="html"><![CDATA[<p>《执子与通子》</p><blockquote><p>艾子游于郊外，弟子通、执二子从焉，渴甚，使执子乞浆于田舍。有老父映门观书，执子揖而请，老父指卷中”真”字问曰：”识此字，馈汝浆。”执子曰：”‘真’字也。”父怒不与，执子反以告。<br>艾子曰：”执也未达，通也当往。”通子见父，父如前示之。通子曰：”此’直’’八’两字也。”父喜，出家酿之美者与之，艾子饮而甘之，曰：”通也智哉！使复如执之认真，一勺水吾将不得吞矣。”</p></blockquote><p>　　</p><p>今日在读一本书时忽的想起了这篇故事，故事即是启迪人们智慧的。而我当时读书心有所感，在这番境地下，再忆起这个故事竟然对生而为人充满了悲哀。每个人从出生到长大都经历了迥然而异而又如许多的故事，这千千万万的故事又造就了每个人不同的内心。我们总是苦于怎样才能将内心真实的想法情感表达出来，而又限于语言这一有限工具。到现在才真是体会到了”高山流水”这一千古绝唱。还记得刘慈欣在《乡村教师》中这样描述地球交流方式：</p><blockquote><p>“他们基本特征是什么？”舰队统帅问。</p><p>“您想知道哪些方面？”蓝84210号上的值勤军官问。</p><p>“比如，这个行星上生命体记忆遗传的等级是多少？”</p><p>“他们没有记忆遗传，所有记忆都是后天取得的。”</p><p>“那么，他们的个体相互之间的信息交流方式是什么？”</p><p>“极其原始，也十分罕见。他们身体内有一种很薄的器官，这种器官在这个行星以氧氮为主的大气中振动时可产生声波，同时把要传输的信息调制到声波之中，接收方也用一种薄膜器官从声波中接收信息。”</p><p>“这种方式信息传输的速率是多大？”</p><p>“大约每秒1至10比特。”</p><p>“什么？！”旗舰上听到这话的所有人都大笑起来。</p><p>“真的是每秒1至10比特，我们开始也不相信，但反复核实过。”</p><p>“上尉，你是个白痴吗？！”舰队统帅大怒，”你是想告诉我们，一种没有记忆遗传，相互间用声波进行信息交流，并且是以令人难以置信的每秒1至10比特的速率进行交流的物种，能创造出5B级文明？！而且这种文明是在没有任何外部高级文明培植的情况下自行进化的？！”<br>……　　　　</p></blockquote><p>　　作者也在感叹人类的交流效率如此之低。尽管人类为了解决这个问题做了很多努力，比如发明了数学——这种充满理性与逻辑的语言，精妙而准确，从中甚至能抽象出一个人，乃至整个宇宙。但是到了什么时候数学也能准确地表达人类的情感呢？或许这是永远也达不到的白月光。这又凸显了心有灵犀的弥足珍贵。当能有一个人与你产生共鸣时，你就能体会到当年”伯牙绝弦”的一半决绝。我们皆感叹”落花有意，流水无情”，倒不如在心里默数十秒，为他人展现一片耐心，也让自己能更多感受对方的处境。这也是我希望自己能做到的，坚冰既融，温暖何穷？</p><p>　　又或许正是这样，我们才有了爱恨情仇呢？进化路上的风景精彩纷呈，每一帧图像都会让人流连忘返。你我又能贡献出怎样的故事呢？</p>]]></content>
    
    
    <summary type="html">&lt;p&gt;《执子与通子》 艾子游于郊外，弟子通、执二子从焉，渴甚，使执子乞浆于田舍。有老父映门观书，执子揖而请，老父指卷中”真”字问曰：”识此字，馈汝浆。”执子曰：”‘真’字也。”父怒不与，执子反以告。 艾子曰：”执也未达，通也当往。”通子见父，父如前示之。通子曰：”此’直’’八’两字也。”父喜，出家酿之美者与之，艾子饮而甘之，曰：”通也智哉！使复如执之认真，一勺水吾…&lt;/p&gt;</summary>


    <category term="静夜思" scheme="https://www.lightdream.xyz/categories/%E9%9D%99%E5%A4%9C%E6%80%9D/"/>
    
    
    <category term="所感" scheme="https://www.lightdream.xyz/tags/%E6%89%80%E6%84%9F/"/>
    
  </entry>
  
  <entry>
    <title>粒子群算法研究(2)</title>
    <link href="https://www.lightdream.xyz/ParticleSwamOptimizaton1.html"/>
    <id>https://www.lightdream.xyz/ParticleSwamOptimizaton1.html</id>
    <published>2020-02-26T00:38:31.000Z</published>
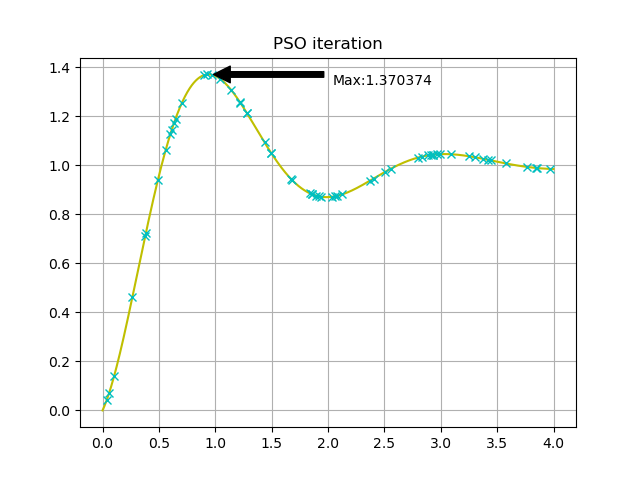
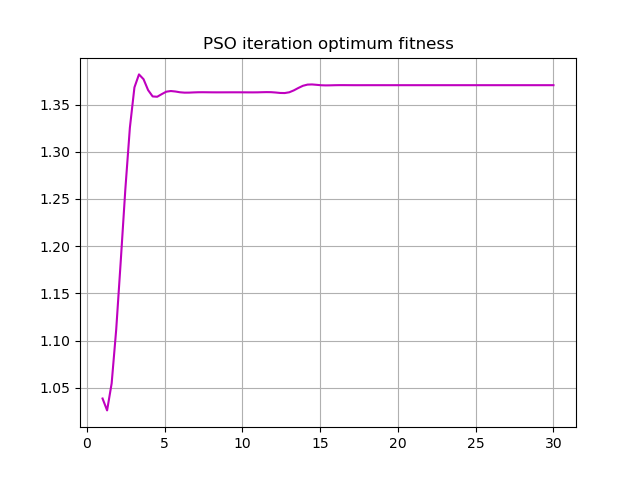
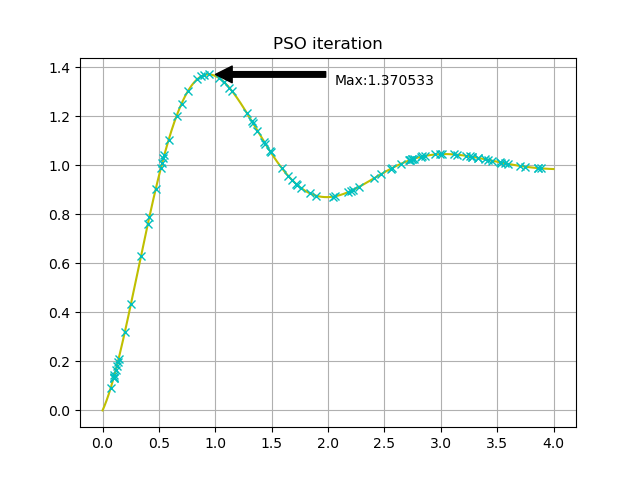
    <updated>2020-05-24T22:11:45.623Z</updated>
    
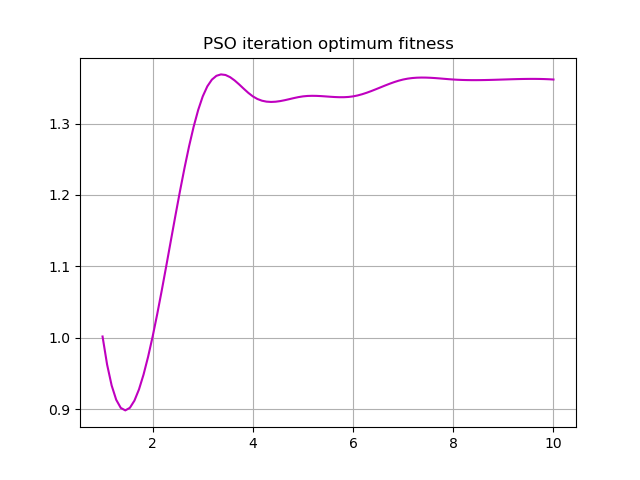
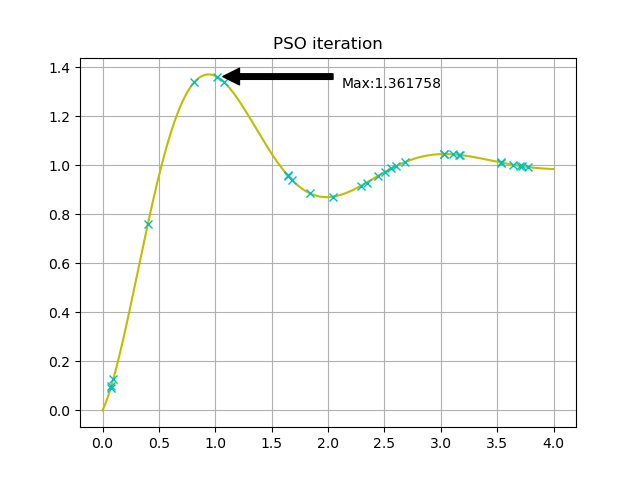
    <content type="html"><![CDATA[<p>接上一篇问题，运用标准粒子群算法进行求解分析:</p><blockquote><p>求函数$y&#x3D;1-cos(3x)e^{-x}$在$[0,4]$上的最大值</p></blockquote><p>下面是算法的参数与需要的数据结构：</p><pre><code class="lang-python"># 标准粒子群算法参数W = 1               # 惯性权重C1 = 2.8            # 认知C2 = 1.3            # 社会Pi = []             # 第i个粒子搜索到的历史最优位值Pifitness = []      # 记录第i个粒子搜索到的历史最优值Pg = 0              # 整个粒子群搜索到的最优位值Pgfitness = 0       # 记录整个粒子群搜索到的最优值intervalMin = 0     # 种群搜索区间下限intervalMax = 4     # 种群搜索区间上限Vmin = -0.001       # 粒子的速度下限Vmax = 0.001        # 粒子的速度上限swam = []           # 种群ParFitness = []     # 种群适应值ParVelocity = []    # 记录粒子i速度N = 3               # 粒子个数T = 30              # 迭代次数record = []         # 记录粒子群每一代粒子群table = []          # 记录每一代粒子群最优适应值</code></pre><p>用三个一维粒子进行迭代，若粒子位置或速度超过边界，则对其重新进行初始化。下面对结果进行分析：</p><h4 id="迭代10次"><a href="#迭代10次" class="headerlink" title="迭代10次"></a>迭代10次</h4><hr><p><img src="/image/PSO_10.png">{width&#x3D;”auto” height&#x3D;”auto” border&#x3D;”0&#x2F;“}</p><p>1.1 粒子群最优值随迭代次数变化情况</p><hr><p><img src="/image/PSO_iteration_10.png">{width&#x3D;”auto” height&#x3D;”auto” border&#x3D;”0&#x2F;“}</p><p>1.2 3个粒子迭代10次分布情况</p><hr><p>　　可见迭代10次，局部搜索还未能进一步发现最优值，增加迭代次数看看。</p><h4 id="迭代20次"><a href="#迭代20次" class="headerlink" title="迭代20次"></a>迭代20次</h4><hr><p><img src="/image/PSO_20.png">{width&#x3D;”auto” height&#x3D;”auto” border&#x3D;”0&#x2F;“}</p><p>2.1 粒子群最优值随迭代次数变化情况</p><hr><p><img src="/image/PSO_iteration_20.png">{width&#x3D;”auto” height&#x3D;”auto” border&#x3D;”0&#x2F;“}</p><p>2.2 3个粒子迭代20次分布情况</p><hr><p>　　迭代20次粒子对局部最优进一步挖掘，得到了更好的解。</p><h4 id="迭代30次"><a href="#迭代30次" class="headerlink" title="迭代30次"></a>迭代30次</h4><hr><p><img src="/image/PSO_30.png">{width&#x3D;”auto” height&#x3D;”auto” border&#x3D;”0&#x2F;“}</p><p>3.1 粒子群最优值随迭代次数变化情况</p><hr><p><img src="/image/PSO_iteration_30.png">{width&#x3D;”auto” height&#x3D;”auto” border&#x3D;”0&#x2F;“}</p><p>3.2 3个粒子迭代30次分布情况</p><hr><p>　　效果对比迭代20次并没有多大提升。当然由于目标函数太过简单，所以粒子个数及粒子的维数并不大，算法复杂度也不高。其实这样也很好，初学时从简单一点的问题着手，一点一点在解决问题中深化认识。</p><h4 id="总结"><a href="#总结" class="headerlink" title="总结"></a>总结</h4><p>在编程过程中对算法理解加深了一个层次，对优化算法而言，在设计实现时要按照以下流程来：</p><ol><li>确定算法需要的参数及其数值</li><li>确定算法所用的数据结构以及输出</li><li>设计实现算法时需要的接口</li><li>算法主程序</li><li>调参</li><li>分析结果</li></ol><hr><p>　　在这里分析还是做的不是多么好，但是因为问题比较简单，没有分析价值，所以只将结果进行对比即可。整个实现的Python代码见我的<a href="https://github.com/lightingmoon/BlogResourceCode/tree/master/StandardPSOExperiment">GitHub</a></p>]]></content>
    
    
    <summary type="html">&lt;p&gt;接上一篇问题，运用标准粒子群算法进行求解分析: 求函数$y&amp;#x3D;1-cos(3x)e^{-x}$在$[0,4]$上的最大值 下面是算法的参数与需要的数据结构： # 标准粒子群算法参数 W = 1 # 惯性权重 C1 = 2.8 # 认知 C2 = 1.3 # 社会 Pi = [] # 第i个粒子搜索到的历史最优位值 Pifitness = [] # 记…&lt;/p&gt;</summary>


    <category term="优化算法" scheme="https://www.lightdream.xyz/categories/%E4%BC%98%E5%8C%96%E7%AE%97%E6%B3%95/"/>
    
    
    <category term="PSO" scheme="https://www.lightdream.xyz/tags/PSO/"/>
    
    <category term="粒子群优化算法" scheme="https://www.lightdream.xyz/tags/%E7%B2%92%E5%AD%90%E7%BE%A4%E4%BC%98%E5%8C%96%E7%AE%97%E6%B3%95/"/>
    
  </entry>
  
  <entry>
    <title>奇怪的梦</title>
    <link href="https://www.lightdream.xyz/StrangeDream1.html"/>
    <id>https://www.lightdream.xyz/StrangeDream1.html</id>
    <published>2020-02-19T18:17:01.000Z</published>
    <updated>2026-08-23T04:31:01.604Z</updated>
    
    <content type="html"><![CDATA[<p>昨夜做了一个很离奇的梦，离奇到多年来从未回忆起昨夜的梦的我醒来后对此梦仍记忆犹新。  </p><p>　　梦的内容如下：和一个朋友出去玩，这个朋友长相现在回忆是模糊的。我们到了一个神奇的地方，具体地方忘了，只记得这个地方有一个奇怪的<em>椭圆形</em>(大概)花坛，里面一纵一横陈列着奇怪的装饰：从当时我梦里的方位看，一纵是两列平行的电线杆，中间距离应该有两米左右；一横忘了。其余地方填充着绿植。至于为什么对这个花坛印象深刻还请看下文。</p><p>我和朋友当时在逛着，忽然远处一道闪电劈下来，劈中了一个人，他迅速倒下了。我们迅速跑过去，朋友立马去对他实施”人工呼吸”（奇怪的是为什么要对他做人工呼吸…），我当时心里的第一个念头是我不会做人工呼吸，以前没做过呀！我立马拿起手机就拔打了110（奇怪为什么不拨打120？）。我给警察说这里有个人被闪电劈死了，警察说在哪里？(这么离奇警察竟然信了)，我当时就懵了，我说我和朋友出来玩，不知道这是什么地方，我转念立马打开百度地图进行定位，定位到好像是陕西省那个地方，忘了。我给警察说了这个地址，警察说有没有什么明显的标志建筑物？我就给警察描述了之前那个花坛，正当紧急的描述着花坛里面的一横时，我的肩膀被拍一下，回头我发现是警察，而另两个警察拿了个毯子把之前被雷劈的那个人裹在里面扔到了一个货运车厢上。</p><p>中间还有一件事，我忘了是什么时候发生的。当时我好像还在打着电话，朋友向我走来，<em>我说：怎么样？朋友摇了摇头</em>（这个回应是脑补的，具体我忘了），我说：你做心脏按压之后进行人工呼吸了吗？朋友应该回答的是没有，我当时心情特别懊丧。<br>　　后来我回家了，是和一个玩滑板的女孩子一起回家的（不知道怎么来了这一段）。当时是住在一个破旧的平板房里，类似于四合院聚居，当我走进家门时我发现门已经被破坏，走进家时，里面一个门被破坏了，但是被补上了一点，门里面放着做木工的工具，我忽然向右后方抬头，房梁上悬着一个人（是吊着），我顿时心中一阵悸动，眼眶开始模糊，泪水如洪流一般涌出，大哭了起来…然后我忽然惊醒，拿起手机看时间，已九点矣。</p>]]></content>
    
    
    <summary type="html">&lt;p&gt;昨夜做了一个很离奇的梦，离奇到多年来从未回忆起昨夜的梦的我醒来后对此梦仍记忆犹新。 梦的内容如下：和一个朋友出去玩，这个朋友长相现在回忆是模糊的。我们到了一个神奇的地方，具体地方忘了，只记得这个地方有一个奇怪的 椭圆形 (大概)花坛，里面一纵一横陈列着奇怪的装饰：从当时我梦里的方位看，一纵是两列平行的电线杆，中间距离应该有两米左右；一横忘了。其余地方填充着绿…&lt;/p&gt;</summary>


    <category term="述梦" scheme="https://www.lightdream.xyz/categories/%E8%BF%B0%E6%A2%A6/"/>
    
    
    <category term="梦的救赎" scheme="https://www.lightdream.xyz/tags/%E6%A2%A6%E7%9A%84%E6%95%91%E8%B5%8E/"/>
    
  </entry>
  
  <entry>
    <title>粒子群算法研究(1)</title>
    <link href="https://www.lightdream.xyz/ParticleSwamOptimization.html"/>
    <id>https://www.lightdream.xyz/ParticleSwamOptimization.html</id>
    <published>2020-02-17T18:29:34.000Z</published>
    <updated>2020-04-27T05:20:41.672Z</updated>
    
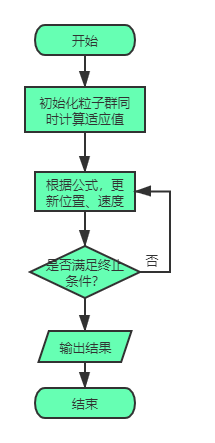
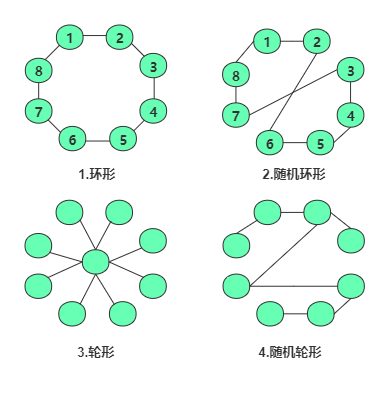
    <content type="html"><![CDATA[<p>粒子群算法（ Particle Swarm Optimization, PSO）是由Eberhart和Kennedy于1995年提出，它的基本概念源于对鸟群觅食行为的研究。设想这样一个场景:一群鸟在随机搜寻食物，在这个区域里只有一块食物，所有的鸟都不知道食物在哪里，但是它们知道当前的位置离食物还有多远。那么找到食物的最优策略是什么呢?最简单有效的就是搜寻目前离食物最近的鸟的周围区域。  </p><p>　　PSO算法就从这种生物种群行为特性中得到启发并用于求解优化问题。在PSO中，每个优化问题的潜在解都可以想象成d维搜索空间上的一个点，我们称之为”粒子”（Particle），所有的粒子都有一个被目标函数决定的适应值(Fitness Value )，每个粒子还有一个速度决定他们飞翔的方向和距离，然后粒子们就追随当前的最优粒子在解空间中搜索。随着位置更新（迭代次数）增加，粒子最终在搜索空间上收敛于最优值（理想状态下）。</p><h3 id="标准粒子群算法（全局版本）"><a href="#标准粒子群算法（全局版本）" class="headerlink" title="标准粒子群算法（全局版本）"></a>标准粒子群算法（全局版本）</h3><p>　　例如，求函数$y&#x3D;1-cos(3x)e^{-x}$在$[0,4]$上的最大值，并在[0,4]之间放置了两个随机的点，假设为$x_1&#x3D;1.5,x_2&#x3D;2.5$，则$x_1,x_2$为标量。对于高维情况，比如二维，求$z&#x3D;2x_1+{x_2}^{2}$，此时每个粒子都是二维的，记</p><p>$$P_1&#x3D;(x_{11},x_{12}),P_2&#x3D;(x_{21},x_{22}),…,\<br>P_n&#x3D;(x_{n1},x_{n2})$$</p><p>这里$n$为粒子群群体规模，也是粒子个数，每个粒子维数为2。更一般的粒子维数为q，则这个种群中有n个粒子，每个粒子为q维。<br>　　对由n个粒子组成的Q维空间进行搜索，第i个粒子表示$x_i&#x3D;(x_{i1},x_{i2},…,x_{iq}), i&#x3D;1,2,…,n$，其在各个维度上速度表示为$v_i&#x3D;(v_{i1},v_{i2},…,v_{iq})$，每个粒子在搜索时考虑以下两个因素：</p><ol><li>自己搜索到的历史最优值$p_i, p_i&#x3D;(p_{i1},p_{i2},…,p_{iq}),i&#x3D;1,2,…,n$</li><li>全部粒子搜索到的最优值$p_g, p_g&#x3D;(p_{g1},p_{g2},…,p_{gn}), i&#x3D;1,2…,n$<br>下面是粒子在搜索时位置速度更新公式：$$v_{id}^{k+1}&#x3D;\omega v_{id}^{k}+c_1(p_{id}^{k}-x_{id}^{k})\<br>　　+c_2(p_{gd}^{k}-x_{id}^{k})$$$$x_{id}^{k+1}&#x3D;x_{id}^k+rv_{id}^{k+1}$$其中的参数：</li></ol><ul><li>$w$为保持原来速度的系数，即惯性权重，其值非负。当值较大时，全局寻优能力强，局部寻优也就弱了；其值较小时，局部寻优能力强，全局寻优能力弱。</li><li>$c_1$是跟踪自己历史最优值的权重系数，表示粒子自身的认识，所以叫”认知”，通常设置为2</li><li>$c_2$是粒子跟踪群体最优值的权重系数，表示粒子对整个群体知识的认识，叫”社会知识”，经常叫做”社会”，通常设置为2</li><li>r 是对位置更新的时候在速度前面加的一个系数，这个系数被称为约束因子，通常设置为1<br>　　这就是一个标准的粒子群算法  <center><img src="image/PSO.png" width="217" height="414"/></center>  其中<strong>终止条件</strong>可以为适应值到达一定数值或循环一定的次数。因这里的粒子同时跟踪自己的历史最优值和群体最优值来改变自己的位置预速度，所以又叫做<strong>全局版本的标准粒子群</strong>优化算法。</li></ul><h3 id="标准粒子群算法（局部版本）"><a href="#标准粒子群算法（局部版本）" class="headerlink" title="标准粒子群算法（局部版本）"></a>标准粒子群算法（局部版本）</h3><p>如果改变全局版本的速度更新公式，让每个粒子位置速度更新根据：</p><ul><li><p>粒子自己搜索到的历史最优值$p_i$</p></li><li><p>粒子邻域内搜索搜索到的最佳值$pn_{k}$<br>其余保持不变，则就成了<strong>局部版本的粒子群算法</strong>。<br>　　一般一个粒子$p_i$的邻域随着迭代次数增加，第一次迭代时，其邻域为0，随着迭代次数邻域线性变大，最后扩展到整个粒子群，这时就变成了全局版本的粒子群算法了。实践证明：<br><strong>全局版本的粒子群算法收敛速度较快，但容易陷入局部最优解；而局部版本的收敛速度慢，但是不容易陷入局部最优。故现在粒子群优化算法大都在<em>收敛速度</em>与<em>摆脱局部最优</em>之间做权衡。</strong></p></li></ul><h3 id="静态邻域："><a href="#静态邻域：" class="headerlink" title="静态邻域："></a>静态邻域：</h3><p>  按照粒子的编号取粒子的邻域</p><ul><li><p>环形</p></li><li><p>随机环形</p></li><li><p>轮形</p></li><li><p>随机轮形  </p><center><img src="image/PSONeiborhood.png" width="388" height="394"/></center></li></ul><!-- --><ul><li><p>环形取法如上<strong>图1</strong>中:<br>　　对编号为1的粒子来说，当粒子邻域个数k为0时，则邻域是其本身；粒子邻域个数k为1时，则其邻域为{2,8};粒子邻域个数k为2时，其邻域为{2,8,7,3}…当邻域个数为4时，粒子的邻域就为整个粒子群了。</p></li><li><p>轮形取法如上<strong>图3</strong><br>　　对于指定粒子i，其位于邻域中心，其它粒子以一定规则与粒子i相连。只有中心粒子与其它相连粒子进行信息交换，中心粒子通过比较邻域中所有粒子携带信息而向其中最优粒子靠近。同时，邻域内最优信息通过中心粒子的性能改善而传播到种群的其它粒子。因此，中心个体令较好信息在种群中的传播速度变慢而增大了全局搜索能力，不至于早收敛。</p></li></ul><h3 id="动态邻域"><a href="#动态邻域" class="headerlink" title="动态邻域"></a>动态邻域</h3><!-- --><ul><li>按照粒子的欧式距离取粒子的邻域<br>　　记录任何两个粒子间最大距离为$d_m$,对每一粒子按照$\frac{||x_a - x_b||}{d_m}$,其中$||x_a-x_b||$为粒子a与粒子b的欧氏距离。而选择阈值$frac$根据迭代次数而变化，当另一粒子b满足$\frac{||x_a-x_b||}{d_m} &lt; frac$，认为b是当前粒子的邻域内。由于要计算所有粒子之间的距离，计算量大且需要很多额外的存储空间，所以该方法不常用。<br>参考文献：</li><li>[1]李丽,牛奔.[M]粒子群优化算法.北京:冶金工业出版社,2009</li><li>感谢这位前辈13年前的博客<a href="https://blog.csdn.net/niuyongjie/category_294976.html">niuyongjie</a>引我入门。</li></ul>]]></content>
    
    
    <summary type="html">&lt;p&gt;粒子群算法（ Particle Swarm Optimization, PSO）是由Eberhart和Kennedy于1995年提出，它的基本概念源于对鸟群觅食行为的研究。设想这样一个场景:一群鸟在随机搜寻食物，在这个区域里只有一块食物，所有的鸟都不知道食物在哪里，但是它们知道当前的位置离食物还有多远。那么找到食物的最优策略是什么呢?最简单有效的就是搜寻目前…&lt;/p&gt;</summary>


    <category term="优化算法" scheme="https://www.lightdream.xyz/categories/%E4%BC%98%E5%8C%96%E7%AE%97%E6%B3%95/"/>
    
    
    <category term="PSO" scheme="https://www.lightdream.xyz/tags/PSO/"/>
    
    <category term="优化算法" scheme="https://www.lightdream.xyz/tags/%E4%BC%98%E5%8C%96%E7%AE%97%E6%B3%95/"/>
    
  </entry>
  
  <entry>
    <title>1003 Emergency😏</title>
    <link href="https://www.lightdream.xyz/1003-Emergency.html"/>
    <id>https://www.lightdream.xyz/1003-Emergency.html</id>
    <published>2020-01-17T00:22:20.000Z</published>
    <updated>2020-05-27T01:05:10.389Z</updated>
    
    <content type="html"><![CDATA[<p>DFS活络思维一下。  </p><p>As an emergency rescue team leader of a city, you are given a special map of your country.<br>The map shows several scattered cities connected by some roads.<br>Amount of rescue teams in each city and the length of each road between any pair of cities<br>are marked on the map. When there is an emergency call to you from some other city,<br>your job is to lead your men to the place as quickly as possible, and at the mean time, call up as many hands on the way as possible.</p><pre><code>Input Specification:Each input file contains one test case.For each test case, the first line contains 4 positive integers:N (≤500) - the number of cities (and the cities are numbered from 0 to N−1),M - the number of roads, C1 and C2- the cities that you are currently in and that you must save,respectively. The next line contains N integers, where the i-th integer is the number of rescue teams in the i-th city.Then M lines follow, each describes a road with three integers c1, c2 and L,which are the pair of cities connected by a road and the length of that road, respectively.It is guaranteed that there exists at least one path from C1 to C2.Output Specification:For each test case, print in one line two numbers:the number of different shortest paths between C1 and C2,and the maximum amount of rescue teams you can possibly gather.All the numbers in a line must be separated by exactly one space, and there is no extra space allowed at the end of a line.Sample Input:5 6 0 21 2 1 5 30 1 10 2 20 3 11 2 12 4 13 4 1   Sample Output:2 4  作者: CHEN, Yue单位: 浙江大学时间限制: 400 ms内存限制: 64 MB</code></pre><p>思路提点:<br>　　考虑DFS，从指定城市$c_1$出发，依次访问邻接城市，直到目标城市$c_2$。用$LL$记录到达目标城市最短路径长度，$L$记录当前长度；$gather$记录最短路径最多的援救队，$gt$记录当前路径援救队，shortest记录最短路径条数。每次访问到目标城市就对$LL,gather,shortest$进行更新。之后进行回溯继续搜索。C++代码如下：</p><pre><code class="lang-C++">#include&lt;iostream&gt;#include&lt;array&gt;using namespace std;const int INF=0x3fffffff;array&lt;array&lt;int,507&gt;,507&gt; pic;array&lt;int,503&gt; team;array&lt;int, 507&gt; vis;// 结果int shortest,gather=0;// DFS信息int LL=INF;    //int L=0;int gt;void DFS(int v, int d, int n)&#123;    if(v == d)    &#123;        if(L &lt; LL)        // 找到比之前路径更短路径，最短路径条数置1，更新最短路径长度        &#123;                // 更新最多搜救队数目            shortest = 1;            LL = L;            gather = gt;        &#125;        else if(L == LL)    // 不止一条最短路径，更新最多搜救队数目        &#123;            shortest++;            gather=max(gather, gt);        &#125;        return;                // 返回    &#125;    vis[v]=1;   //置访问标记    for(int i=0; i&lt;n; ++i)    &#123;        if(pic[v][i]!=INF &amp;&amp; vis[i] == 0)        &#123;            L += pic[v][i];            gt += team[i];            DFS(i, d, n);            gt -= team[i];            L -= pic[v][i];        &#125;    &#125;    vis[v]=0;   // 回溯取消标记&#125;int main()&#123;    ios::sync_with_stdio(0);    int n, m, c1, c2;    cin&gt;&gt;n&gt;&gt;m&gt;&gt;c1&gt;&gt;c2;    for(int i=0; i&lt;n; ++i)        cin&gt;&gt;team[i];    for(int i=0; i&lt;n; ++i)        pic[i].fill(INF);    int t1,t2,s;    for(int i=0; i&lt;m; ++i)    &#123;        cin&gt;&gt;t1&gt;&gt;t2&gt;&gt;s;        pic[t1][t2]=pic[t2][t1]=s;    // 无向图！    &#125;    vis.fill(0);    gt = team[c1];            // 源城市援救队数目    DFS(c1,c2,n);    cout&lt;&lt;shortest&lt;&lt;&#39; &#39;&lt;&lt;gather&lt;&lt;endl;    return 0 ;&#125;</code></pre>]]></content>
    
    
    <summary type="html">&lt;p&gt;DFS活络思维一下。 As an emergency rescue team leader of a city, you are given a special map of your country. The map shows several scattered cities connected by some roads. Amount of resc…&lt;/p&gt;</summary>


    <category term="PAT" scheme="https://www.lightdream.xyz/categories/PAT/"/>
    
    
    <category term="DFS" scheme="https://www.lightdream.xyz/tags/DFS/"/>
    
  </entry>
  
  <entry>
    <title>回望</title>
    <link href="https://www.lightdream.xyz/Lookbacktothepast.html"/>
    <id>https://www.lightdream.xyz/Lookbacktothepast.html</id>
    <published>2019-12-29T07:09:05.000Z</published>
    <updated>2020-04-06T23:12:06.090Z</updated>
    
    <content type="html"><![CDATA[<p>20190317-20191222，一段历程，一点感动。新近读了刘慈欣的《球状闪电》，里面提到了一种人生观，让我衷心的赞同。人这一生有一种活法，就是从始至终对某种事物着迷，也就是这种东西值得自己一生为之付出而不求有所收获。我应当是寻找到了。只需要再具体一些，将之化成无数的计划和目标。<br>　　辩证唯物主义告诉我们，要有目的有计划的活着，才能在这个<strong>客观世界</strong>活得游刃有余。  </p><p>　　在过去的308天里，在我的认识里，我应该是全身心的投入到了这件事中，不管结果如何，这只是自己应得的(deserve it)。下面的总结分为两部分，一部分是知识，一部分是认识。对应学与思。</p><h2 id="学"><a href="#学" class="headerlink" title="学"></a><strong>学</strong></h2><p>​总结也就是”背目录”了，但是背目录也不仅仅是背目录，而是无限的回忆目录项下的知识细节，形成体系。古语”将一本书学薄”即是此道理。但是还是<strong>实践</strong>出真知。</p><h4 id="高数部分"><a href="#高数部分" class="headerlink" title="高数部分"></a>高数部分</h4><ol><li>高等数学<ul><li>函数（初等函数，性质（定义域，值域，对应法则.映射，周期，奇偶） 极限（无穷小，无穷大，等价、同阶、高阶无穷小，单调有界、夹逼定理） 连续定义（间断点第一类、第二类）</li><li>一元函数微分学（导数和微分关系，$\Delta y&#x3D;f^\prime(x)\Delta x+o(\Delta (x))$，常用函数微分，高阶导）</li><li>一元函数积分学（积分定义，不定积分，定积分，牛-莱公式，积分上限函数，多重积分，几种坐标系（极坐标系，柱面坐标系，球面坐标系））</li><li>空间解析几何（向量，向量内积、外积，混合积，空间直线、平面及其表示方式，旋转曲面）</li><li>多元函数微分学（多重极限，微分形式不变性，隐函数存在定理，梯度，多元函数极值（AC-$B^2$），条件极值（拉格朗日函数，在SVM公式推导中有运用）)</li><li>正项级数（正项级数，阿贝尔定理，级数判敛(级数收敛的必要条件)，正负交错级数(莱布尼茨定理)，将函数展开成幂级数，求正项级数和函数，傅里叶级数，狄利克雷定理）</li><li>微分方程（一阶线性微分方程，齐次方程，贝努利微分方程，欧拉微分方程，高阶微分方程）</li></ul></li><li>线性代数<ul><li>行列式（行列式性质六条，行列式求值，克拉默法则）</li><li>矩阵与向量(组)（矩阵性质、运算，初等变换，分块矩阵，矩阵的伴随，矩阵的逆，向量组线性无关相关，极大无关组，向量组的秩，向量组等价，矩阵秩，矩阵等价）</li><li>线性方程组（齐次方程组及其解的结构，非齐次方程组及其解的结构，同解方程，方程的公共解，方程的解空间，解空间的基，正交基）</li><li>特征值与特征向量（$AP &#x3D; \lambda P$，正交变换，矩阵相似及相似对角化，矩阵相似的四个必要条件，实对称矩阵，向量的坐标及过渡矩阵）</li><li>二次型（二次型概念(令二次型系数矩阵为A，令$\vec x &#x3D; (x_1,x_2,x_3,…,x_n)^T,f(x)&#x3D;\vec x^TA\vec x$)，正负惯性指数，二次型合同，二次型正定的充分条件）</li></ul></li><li>概率论与数理统计<ul><li>古典概型，全概率公式(先验)，贝叶斯公式(后验)</li><li>随机变量函数（随机变量函数性质，离散型常用随机变量函数(两点分布，二项分布，几何分布，超几何分布，泊松分布)，连续型常用随机变量函数(均匀分布 ，指数分布，正态分布)，多位随机变量函数）</li><li>数理统计基础（数字变量的基本特征(期望、方差、协方差、相关系数$\rho$)，n阶中心矩，n阶原点矩）</li><li>参数估计（矩估计，最大似然估计，区间估计(1-$\alpha$置信区间)）</li><li>假设检验(弃真，纳伪假设)</li></ul></li></ol><h4 id="专业课部分"><a href="#专业课部分" class="headerlink" title="专业课部分"></a>专业课部分</h4><ol><li>数据结构{逻辑结构{线性结构，非线性结构}，存储结构{顺序，链式，索引，散列存储结构}}<ul><li><em>线性表</em>(分别只有一个前驱和后继，对应的存储结构就是顺序表和链表，对顺序表和链表的操作，以及对应时、空间复杂度)</li><li><em>栈和队列</em>（其是一种逻辑结构，其中栈对元素的添加和删除仅能在一端进行，队列是只能在一端进另一端出。其存储结构可以用顺序表和链表实现）</li><li><em>串</em>(主要是KMP算法)（其本质就是线性表，但是其每一个元素都是字符，对串的各种操作，以及串的模式匹配）</li><li><em>树</em>（一个前驱，多个后继，树的性质，树的存储结构-顺序表、二叉链表，主要是二叉树，二叉树的遍历{递归，非递归}，线索树(将树线索化，可以对树逻辑上进行线性结构的访问元素)，哈夫曼树）</li><li><em>图</em>（有多个前驱，多个后继，图的性质，图的存储结构-邻接矩阵、邻接表，对图的遍历，图的最小生成树{Prim算法(加点、适合稠密图)、Kruskal算法(加边、适合稀疏图)}，最短路径算法(Dijkstral算法，Floyd算法)）</li><li><em>排序</em>（算法基本性质{确定性&amp;可行性&amp;有穷性&amp;输入&amp;输出}，时空复杂度，插入类{插入排序，希尔排序}，交换类{冒泡排序、快速排序}，选择类{选择排序、堆排序}，归并排序，基数排序，外排序(最小归并树，败者树)）</li><li><em>查找</em>(二叉查找树，二叉平衡树{LL,RR,LR,RL旋转}，哈希查找{建表、冲突避免(线性探测法&#x2F;平方探测法&#x2F;二次散列法&#x2F;链地址法)}，B树(k叉平衡树))</li></ul></li><li>操作系统<ul><li><em>操作系统的更迭</em>{单道批处理-&gt;多道批处理-&gt;分时操作系统-&gt;实时操作系统-&gt;分布式操作系统{重在协作解决问题，负载均衡}-&gt;网络操作系统{重在资源共享}}</li><li><em>处理机管理</em>{进程定义，PCB，状态转换图，三级调度{高级调度&#x2F;作业调度、中级调度&#x2F;进程对换、低级调度&#x2F;进程调度}、线程{CPU调度的最小单位&#x2F;共享进程空间}、多线程模型{用户级线程、内核级线程}}</li><li><em>内存管理</em>{内存管理意义、<strong>局部性原理</strong>{贯穿计算机科学始终，分为空间局部和时间局部}，程序的编译执行过程{源代码编译-&gt;链接-&gt;装入(程序逻辑地址形成)-&gt;运行}，内存分配方式{①连续和②非连续}，①(单一连续分配{效率低，仅支持单进程系统}，固定分区分配，动态分区分配)，②(分页式分配，分段式分配，段页式分配)，虚拟存储器{逻辑上扩充内存空间，配合请求分页式内存管理}（对换性，多次性，虚拟性），页置换算法{最佳置换算法，FIFO算法，LRU算法，CLOCK算法，内存块分配策略{固定分配局部置换，可变分配全局置换，可变分配局部置换}，页工作集(驻留集){为在某一段时间间隔内，进程要访问的页面集合}}</li><li><em>文件管理</em>{文件的逻辑结构(顺序文件，索引文件，索引顺序文件)，文件目录(一级目录、二级目录、树形目录)，文件共享方式{索引节点(硬链接)}，文件物理结构(连续文件，链接文件，索引文件)，文件访问控制{基于角色模型访问控制}，文件管理系统{分层}，磁盘管理{磁盘调度算法}，}</li><li><em>设备管理</em>{功能{用户层，设备无关层，驱动层，硬件层}，I&#x2F;O缓冲技术{单缓冲，双缓冲，循环缓冲}，I&#x2F;O子系统{总线型，通道型，控制器型}，虚拟设备{其就是在独占型设备与进程之间增加一个共享型设备作为过渡。即进程在占用CPU时尽可能减少等待I&#x2F;O的时间。SPOOLing系统{对虚拟设备技术的应用，在磁盘开辟一个独立空间暂存数据，等设备空闲再将数据送给设备。输入设备-&gt;假脱机输入程序-&gt;输入井(管理程序)-&gt;逻辑设备管理-&gt;用户进程-&gt;逻辑设备管理模块-&gt;输出井(管理程序)-&gt;假脱机输出程序-&gt;通道-&gt;输出设备}}}</li></ul></li><li>计算机网络<ul><li><em>OSI参考模型、TCP&#x2F;IP参考模型</em>{计算机网络基本功能-数据通信、资源共享，服务，协议，接口定义以及之间关系，OSI自顶向下{应用层-&gt;表示层-&gt;会话层-&gt;传输层-&gt;网络层-&gt;数据链路层-&gt;物理层}，TCP&#x2F;IP{应用层-&gt;传输层-&gt;网际层-&gt;数据链路层}，分层既明确了分工，又简化了协议设计。各层通过访问下一层的SAP获得下一层的服务。}</li><li><em>物理层</em>{与传输介质无关，该层为设备之间数据通信提供传输媒体与互连设备，为数据链路层提供一条稳定的传输比特流线路。其接口特性是机械的(接口形状尺寸)、电气的(接口电缆电压范围)，功能的(对应电平的电压的意义)，规程的(不同功能的可能事件的时序)，物理层设备{放大器，hub(一个冲突域)}}</li><li><em>数据链路层</em>{访问物理层的服务为网络层提供服务，定义数据如何传输，功能:帧定界{字节计数，字符&#x2F;比特填充首尾定界符，违规编码法}，差错控制{奇偶校验，循环冗余，海明码}，流量控制{因为发送时接收方处理速度和缓冲区有限，若发送方发送过快会而接收方不能以同样速度接收，则不能正确的传输数据，所以要进行流量控制，即控制发送速度。滑动窗口协议(停-等协议、后退N帧、选择重传)}，链路管理{为面向连接的服务提供链路管理}，局域网{网络拓扑逻辑上是总线型结构，其代表即是以太网的应用}，LLC子层和MAC子层{主要是MAC子层，在传输介质时涉及对传输介质的访问，以避免产生冲突。ALOHA协议，纯ALOHA协议，时隙ALOHA，CSMA协议，CSMA&#x2F;CD(应用有线网)，CSMA&#x2F;CA(应用于无线网)，二进制指数退避算法}，数据链路层协议有PPP协议、HDLC协议，以太网协议等。数据链路层设备{透明网桥、源路由网桥，交换机}，数据链路层设备仅能分割冲突域}</li><li><em>网络层</em>{网络层提供主机到主机服务，异构网络，自治系统，IPV4&#x2F;IPV6，网络前缀&#x2F;路由聚合，子网划分，路由转发原理，动态路由算法{距离向量算法(RIP协议，BGP协议)，链路状态路由算法(OSPF协议)}，网络层协议{IP，ARP&#x2F;RARP，ICMP}，网络层设备{路由器，分为存储转发式和直通式}，网络层设备可以分割冲突域和广播域}</li><li><em>传输层</em>{传输层提供端到端服务，其功能主要有分用和复用。复用{在发送端多个应用可共用传输层服务}，分用{在接收端，传输层会根据端口号将数据分给不同应用}，UDP协议{面向无连接，所以其提供的服务是不可靠的，传输单位是报文，其中头部开销为8字节，数据不会进行拆分和合并}，TCP协议{面向连接，其头部至少20字节，提供可靠交付服务，其是面向字节流的，狭义上其为数据包中每个字节编号。提供全双工通信}，TCP拥塞控制{慢开始算法，拥塞避免算法，快重传算法{接收方收到失序报文段就立即向发送方发送一个ACK，告诉发送方自己收到一个失序报文并告诉对方自己需要接收的sep}，快恢复算法{连续收到同一分组的3个确认应答}}，}</li><li><em>应用层</em>{其直接为应用程序提供常见的网络应用服务，DNS{提供域名解析成IP地址服务，递归解析，迭代解析}，FTP{在传输层TCP上，在主动模式下，用熟知端口20作为数据端口，端口21作为控制端口，这样将数据和控制分开可以简化协议的设计}，SMTP{简单邮件传输协议，通过Push操作使用SMTP将邮件发送至邮件服务器，邮件服务器解析接收方邮件服务器地址，再通过SMTP将邮件发送至对方邮件服务器地址，接收方再通过Pull操作使用POP协议获取邮件}，HTTP{基于传输层TCP，其是一个简单的、无状态的、面向对象的请求-响应协议，请求方式主要有GET和POST,消息头部都由ASCII形式给出}}</li></ul></li></ol><h2 id="思"><a href="#思" class="headerlink" title="思"></a><strong>思</strong></h2><p>　　在我沉浸在早出晚归这段日子里，唯孤单作陪，幸有音乐为伴。总是以为自己在想象之中，却不知世事总是发展至意料之外。我以为自己能一天精力高度集中学习14h+，以为自己在对知识宏观把握之后能无限推导细节，以为逻辑推导能代替死记硬背…大错特错。</p><ol><li>应试教育里，你不仅要对这个知识点熟练到无以复加，其中的一些推导也必须要烂熟于心，而不是考试现场推导，在考场短短几小时里，已经不允许自己去推导回忆知识点。此错误一。</li><li>我总是疏于对细节知识的熟练掌握，总是想在宏观层次掌握，企图总结一条更加抽象的逻辑贯穿其中。殊不知宏观的认识是建立在对细节知识掌握之后的，类似于无限风光在险峰。在半山腰是永远也无法领略到山顶的风光的。</li><li>总是给自己找借口说服自己，妥协。久而久之就习惯了。有些事可以找理由说服自己，有些则不然。关键是认识到不到位。</li><li>不要低估自己，也更不要高估自己。</li></ol>]]></content>
    
    
    <summary type="html">&lt;p&gt;20190317-20191222，一段历程，一点感动。新近读了刘慈欣的《球状闪电》，里面提到了一种人生观，让我衷心的赞同。人这一生有一种活法，就是从始至终对某种事物着迷，也就是这种东西值得自己一生为之付出而不求有所收获。我应当是寻找到了。只需要再具体一些，将之化成无数的计划和目标。 辩证唯物主义告诉我们，要有目的有计划的活着，才能在这个 客观世界 活得游刃…&lt;/p&gt;</summary>


    <category term="静夜思" scheme="https://www.lightdream.xyz/categories/%E9%9D%99%E5%A4%9C%E6%80%9D/"/>
    
    
    <category term="反思" scheme="https://www.lightdream.xyz/tags/%E5%8F%8D%E6%80%9D/"/>
    
    <category term="总结" scheme="https://www.lightdream.xyz/tags/%E6%80%BB%E7%BB%93/"/>
    
  </entry>
  
  <entry>
    <title>预处理和词法分析器</title>
    <link href="https://www.lightdream.xyz/CompilerPrinciple-preProcessAndLexAnalysis.html"/>
    <id>https://www.lightdream.xyz/CompilerPrinciple-preProcessAndLexAnalysis.html</id>
    <published>2019-05-21T05:51:20.000Z</published>
    <updated>2020-05-24T22:10:55.286Z</updated>
    
    <content type="html"><![CDATA[<p>结合课程实验和课程设计，时间跨度为一个月，完成预处理，词法分析器。(词法分析器已作为JavaSwing项目上传至<a href="https://github.com/lightingmoon/My-project">GitHub</a>。)  </p><h3 id="预处理程序"><a href="#预处理程序" class="headerlink" title="预处理程序"></a>预处理程序</h3><pre><code>#include&lt;cstdio&gt;#include&lt;iostream&gt;#include&lt;fstream&gt;using namespace std;void processSpace(ifstream &amp;fin, const char);    // 处理空格void processMargin(ifstream &amp;fin, const char);    // 处理注释void processCrLf(ifstream &amp;fin, const char);    // 处理回车换行int main()&#123;    ifstream fin(&quot;F:\\CompilerPrinciple\\Test1\\demo.cpp&quot;, ios::in);    // 预处理源代码文件    freopen(&quot;F:\\CompilerPrinciple\\Test1\\out.cpp&quot;,&quot;w&quot;,stdout);    // 输出结果文件    char now, last;    fin.get(last);    while(!fin.eof() &amp;&amp; isspace(last))    // 一个字符测试空文件        fin.get(last);    fin.unget();    while(!fin.eof())    &#123;        fin.get(now);        switch(now)        &#123;        case &#39; &#39;:            processSpace(fin, last);            fin.unget();    // 超前搜索回退            break;        case &#39;/&#39;:            processMargin(fin, last);            break;        case &#39;\n&#39;:          // 只存在Mac和windows下\r\n,\r            processCrLf(fin, last);            last = &#39;\n&#39;;            break;        case &#39;\t&#39;: break;        default:            putchar(now);        &#125;        last = now;    &#125;    return 0;&#125;void processSpace(ifstream &amp;fin, const char st)&#123;    /*         一.去多余空格:    *            1.判定当前字符，是空格则转第二步；否则输出    *            2.判定记录的上一个字符，如果是换行符，则是行首空格，不输出；    *                   如果是赋值号，则是多余空格，不输出    *                   继续判定下一个字符，如果是斜线，则是行末与注释间的空格，不输出    *                   如果是分号，则是行末多余字符，不输出。    *                   如果是空格，则是多余空格，不输出    */    char next;    fin.get(next);    while(!fin.eof() &amp;&amp; isspace(next))  // 去多个连续空格        fin.get(next);    if(st != &#39;\n&#39; &amp;&amp; st != &#39;=&#39;        &amp;&amp; next != &#39;/&#39; &amp;&amp; next != &#39;;&#39; &amp;&amp; next != &#39;=&#39;)        putchar(&#39; &#39;);&#125;void processCrLf(ifstream &amp;fin, const char st)&#123;    /* 二. 去回车换行    *    1.超前搜索：如果下一个字符不是换行符，为Mac下源文件，回退文件指针，输出一个空格。否则    *      不回退，输出一个空格    *   考虑到兼容性，windows下\r\n，unix下 \n ，Mac下是 \r，过滤    */    char next;    if(!fin.eof())    &#123;        fin.get(next);        if(next != &#39;\n&#39;)            fin.unget();        putchar(&#39; &#39;);    &#125;&#125;void processMargin(ifstream &amp;fin, const char st)&#123;    /*          三. 去注释    *             1.判定当前字符是否为  / ，是则进入第2步；否则输出    *             2.超前搜索下一个字符是否为  / ，是则为单行注释，直接结束本行；否则转第3步    *             3.超前搜索下一个字符是否为  * ，进入下一次循环，转第4步    *             4.判定当前字符是否为  *  ，是则进入第5步；否则放弃当前字符，进入下一次循环    *             5.超前搜索下一个字符是否为 &#39;/&#39;，是则结束循环退出子程序；    *               否则进入下一次循环，转第4步    */    char next, now;    fin.get(next);    if(!fin.eof())    &#123;        if(next == &#39;/&#39;)     // 单行注释        &#123;            while(!fin.eof())            &#123;                fin.get(now);                if(now == &#39;\r&#39; || now == &#39;\n&#39;)                    break;            &#125;            if(now == &#39;\n&#39;)     // 不是回车换行符，回退                fin.unget();        &#125;        else if(next == &#39;*&#39;)    //多行注释        &#123;            while(!fin.eof())            &#123;                fin.get(next);                if(next == &#39;*&#39;)                &#123;                    fin.get(next);                    if(next == &#39;/&#39;)                        break;                &#125;            &#125;        &#125;    &#125;&#125;</code></pre>]]></content>
    
    
    <summary type="html">&lt;p&gt;结合课程实验和课程设计，时间跨度为一个月，完成预处理，词法分析器。(词法分析器已作为JavaSwing项目上传至 GitHub 。) 预处理程序 #include&amp;lt;cstdio&amp;gt; #include&amp;lt;iostream&amp;gt; #include&amp;lt;fstream&amp;gt; using namespace std; void processSp…&lt;/p&gt;</summary>


    <category term="编译原理" scheme="https://www.lightdream.xyz/categories/%E7%BC%96%E8%AF%91%E5%8E%9F%E7%90%86/"/>
    
    
    <category term="编译原理" scheme="https://www.lightdream.xyz/tags/%E7%BC%96%E8%AF%91%E5%8E%9F%E7%90%86/"/>
    
    <category term="词法分析" scheme="https://www.lightdream.xyz/tags/%E8%AF%8D%E6%B3%95%E5%88%86%E6%9E%90/"/>
    
    <category term="预处理" scheme="https://www.lightdream.xyz/tags/%E9%A2%84%E5%A4%84%E7%90%86/"/>
    
  </entry>
  
  <entry>
    <title>汇编语言实现冒泡排序算法</title>
    <link href="https://www.lightdream.xyz/AssemblyLanguage-SwapSort.html"/>
    <id>https://www.lightdream.xyz/AssemblyLanguage-SwapSort.html</id>
    <published>2019-04-22T08:12:19.000Z</published>
    <updated>2020-05-24T22:11:27.998Z</updated>
    
    <content type="html"><![CDATA[<p>初学汇编语言，自己便许下了用汇编实现冒泡排序算法的”宏愿”，现在也终于实现了一部分。用高级编程语言的思想指导低级编程语言来实现算法，在过去算奢侈，现在可能是一种妥协。我会随着课程的深入来改正这个程序。在这里记录历程。  </p><h3 id="版本1"><a href="#版本1" class="headerlink" title="版本1"></a>版本1</h3><pre><code class="lang-assembly">include vcIO.inc; 过程功能：冒泡排序.data; set data segmentarr dd 10,2,3,2,5,21,32,12,43,12,33,43,54,66,87,89,00,4,2,6; 待排序数组len1 byte ? ; 数组长度len2 byte ? ;内层循环边界fmt byte &#39;%d &#39;,0.codemain proc    mov len1,lengthof arr    mov ebx,offset arr    mov al,0h    ;外层循环变量    ;外层循环体lp:    cmp al,len1    jnb done; 结束循环    ; 内层循环体    mov ah, 1h; 内层循环变量inner:    ;内层循环判断索引部分    mov cl,len1    mov len2,cl    sub len2,al    cmp ah,len2    jnb last    movsx esi,ah    ;得到待比较的两个元素索引    mov bl,ah    sub bl,1    movsx edi,bl    mov ecx, arr[(type arr)*esi]    mov edx, arr[(type arr)*edi]    cmp ecx,edx    jnb follow        ;交换元素    mov edx,arr[(type arr)*esi]    xchg edx,arr[(type arr)*edi]    xchg edx,arr[(type arr)*esi]follow:    inc ah        ;内层循环更新    jmp innerlast:    inc al        ;外层变量更新    jmp lpdone:    xor ecx,ecx    mov al,len1prt:    movsx ebx,al    cmp ecx,ebx    jnb fina    mov edx, arr[(type arr)*ecx]    pushad        invoke printf,offset fmt,edx    popad    inc ecx    jmp prtfina:    ret        ; return to windowsmain endp    ; (insert additional procedures here)end  main    ; end of assembly</code></pre><h3 id="版本2-子程序版"><a href="#版本2-子程序版" class="headerlink" title="版本2(子程序版)"></a>版本2(子程序版)</h3><p>　　知道和运用之间总是隔着一个三维宇宙😁，这次更新带比例的的相对基址变址寻址，这样就不用单纯的通过改变索引（还是高级语言编程的习惯）来访问数组元素了。</p><pre><code class="lang-assembly">include vcIO.inc;过程功能;主程序验证 ，子程序冒泡排序，通过堆栈传递参数.dataarr dword 10, 2, 3, 2, 5, 21, 32, 12, 43, 12, 33, 43, 54, 66, 87, 89, 00, 4, 2, 6; 待排序数组fmt byte &#39;%d &#39;,0.codemain proc    push lengthof arr ;数组长度压栈    push offset arr      ;数组首地址压栈    call bubbleSort    add esp,8    ;堆栈平衡    ; 打印结果    mov ecx,lengthof arr    mov ebx,offset arr    xor esi,esiagain:    mov eax,[ebx+4*esi]    pushad        invoke printf,offset fmt,eax    popad    inc esi    loop againbubbleSort proc    push ebp    ;保护ebp内容    mov ebp,esp ;取得最低地址堆栈指针    push eax    push ebx    push ecx    push edx    push edi    push esi    mov ebx,[ebp + 8]    ;取出数组偏移地址    mov ecx,[ebp + 12] ; 取出数组长度    xor esi,esi    ;外层循环变量outer:    cmp esi,ecx    jnb done    ;排序结束跳转    push ecx    sub ecx,esi    ;内层循环边界    mov eax,ecx    pop ecx    xor edi,edi    ;内层循环变量    inc edi        ;内层从1开始，比较arr[i]和arr[i-1]inner:    cmp edi,eax    jnb next    ;内层循环结束    push ecx    ; 交换准备    ;待修改块    ;带比例的基址变址寻址    ;mov edx, [ebx + 4 * edi]    ;dec edi    ;mov ecx, [ebx + 4 * edi]    ;inc edi    ;带比例的相对基址变址寻址    mov edx, [ebx + 4 * edi]    mov ecx, [ebx + 4 * edi - 4]    cmp edx, ecx    jnb beyond    ; 交换数据(待修改块)    ;dec edi    ;xchg edx, [ebx + 4 * edi]    ;inc edi    ;xchg edx, [ebx + 4 * edi]    ;带比例的相对基址变址寻址    xchg edx, [ebx + 4 * edi - 4]    xchg edx, [ebx + 4 * edi]beyond:    pop ecx    inc edi    jmp innernext:    inc esi    jmp outerdone:    pop esi    pop edi    pop edx    pop ecx    pop ebx    pop eax    pop ebp    retbubbleSort endp    retmain endpend main</code></pre>]]></content>
    
    
    <summary type="html">&lt;p&gt;初学汇编语言，自己便许下了用汇编实现冒泡排序算法的”宏愿”，现在也终于实现了一部分。用高级编程语言的思想指导低级编程语言来实现算法，在过去算奢侈，现在可能是一种妥协。我会随着课程的深入来改正这个程序。在这里记录历程。 版本1 include vcIO.inc ; 过程功能：冒泡排序 .data; set data segment arr dd 10,2,3,…&lt;/p&gt;</summary>


    <category term="汇编语言" scheme="https://www.lightdream.xyz/categories/%E6%B1%87%E7%BC%96%E8%AF%AD%E8%A8%80/"/>
    
    
    <category term="AssemblyLanguage" scheme="https://www.lightdream.xyz/tags/AssemblyLanguage/"/>
    
    <category term="汇编语言" scheme="https://www.lightdream.xyz/tags/%E6%B1%87%E7%BC%96%E8%AF%AD%E8%A8%80/"/>
    
  </entry>
  
  <entry>
    <title>那迷人的欧拉公式</title>
    <link href="https://www.lightdream.xyz/EulerFormula.html"/>
    <id>https://www.lightdream.xyz/EulerFormula.html</id>
    <published>2019-03-26T07:16:10.000Z</published>
    <updated>2020-04-30T20:25:44.232Z</updated>
    
    <content type="html"><![CDATA[<p>数学的确是人们从感性认知世界到理性度量世界的巨大的转变，既然历史已经走到了这里，那我们可以称它为是一种进步。So，我在这里观叹”上帝创造”的公式——<strong>欧拉公式</strong>（又称为欧拉恒等式）。  </p><h1 id="e-pi-i-1-0"><a href="#e-pi-i-1-0" class="headerlink" title="$e^{\pi i}+1&#x3D;0$"></a>$e^{\pi i}+1&#x3D;0$</h1><p>这个公式将复数单位——i，圆周率——$\pi$，自然对数的底数——e，整数的单位——1以及人类最伟大的发明——0，联系在了一起，并由此产生了无限的可能。比如，我们可以解出类似于$x^{2}&#x3D;-1$方程的解（$i^2&#x3D;-1$)。也可以将对数函数的定义域扩展到全体实数（扩展这个词是借鉴复数将实数所在的一维数轴扩展成具有实轴和虚轴的二维复平面），例如</p><p>$$ln(-5)&#x3D;ln(5e^{\pi i})$$$$&#x3D;ln5+ln(e^{\pi i})&#x3D;ln5+\pi i$$</p><p>是不是打开了新世界的大门？本来在实数集上，$y&#x3D;lnx$的定义域为$D_{f}&#x3D;{x|x\gt 0}$，而当扩展到了复数集时，ln(-5)就有意义了。再多说一点，既然复数能扩展到二维复平面，那么它还能不能扩展到更多的维度呢？答案是可以的，比如<a href="https://www.zhihu.com/question/23005815">四元组</a>。<br>下面我以证明欧拉公式为目的，从泰勒公式开始总结：</p><h4 id="泰勒公式"><a href="#泰勒公式" class="headerlink" title="泰勒公式"></a>泰勒公式</h4><p>　　我们知道当$x→0$时，会存在一些等价无穷小，例如$sin(x)$<del>$x,tan(x)$</del>$x$。而采用等价无穷小后，会方便我们对一些函数的性态做研究。一方面，我们令$P(n)$为$f(x)$在$x_{0}$处的等价的多项式，它与$f(x)$之间相差一个无穷小。</p><p>$$P(x)&#x3D;a_{0}+a_{1}(x-x_{0})+a_{2}(x-x_{0})^{2}+$$$$…+a_{n}(x-x_{0})^{n}　(*)$$</p><p>可以想象一下我们拟合曲线时的操作，尽量让拟合的曲线的走势与被拟合的函数一致，说到曲线的趋势，我们必会提到导数。所以，设</p><p>$$P(x_0)&#x3D;f(x_0), P’(x_0)&#x3D;f’(x_0)$$$$P’’(x_0)&#x3D;f’’(x_0),…, P^{(n)}(x_0)&#x3D;f^{(n)}(x_0)$$</p><p>即是</p><p>$$a_0&#x3D;f(x_0), a_1&#x3D;f’(x_0)$$$$2!a_2&#x3D;f’’(x_0),…,n!a_n&#x3D;f^{(n)}(x_0)$$</p><p>所以多项式对应的系数已求出，将之代入(*)式，得到$f(x)$的在$x&#x3D;x_0$处的泰勒展开式：</p><p>$$f(x)&#x3D;f(x_0)+f’(x_0)(x-x_0)+$$$$\frac{f’’(x_0)}{2!}(x-x_0)+…+\frac{f^{(n)}(x_0)}{n!}(x-x_0)$$</p><p>因为本文目的是证明欧拉公式，所以这里就不讨论误差。<br>下面是用Octave画出y&#x3D;sinx在x&#x3D;0处展开3，5阶麦克劳林公式并与y&#x3D;sinx对比的图像，</p><center><img src="image/curve.png" width="450" height="300"/></center>  <p>可以看出泰勒展开的阶数越高，曲线拟合效果越好。</p><h4 id="欧拉公式"><a href="#欧拉公式" class="headerlink" title="欧拉公式"></a>欧拉公式</h4><p>由上面定义，我们可以得到三个关键函数在$x&#x3D;0$处的省略余项的麦克劳林公式:</p><p>$$e^{x}&#x3D;1+x+\frac{x^{2}}{2!}+\frac{x^{3}}{3!}+…+\frac{x^{n}}{n!}$$$$sinx&#x3D;x-\frac{x^{3}}{3!}+…+(-1)^{(n-1)}\frac{x^{2n-1}}{(2n-1)!}$$$$cosx&#x3D;1-\frac{x^2}{2!}+…+(-1)^n\frac{x^{2n}}{(2n)!}$$</p><p>正式开始证明欧拉公式：<br>在$e^{x}$的展开式中把$x$换成$±ix$，</p><p>$$(±i)^2&#x3D;-1,(±i)^{3}&#x3D;∓i,(±i)^{4}&#x3D;1,…$$$$e^{±ix}&#x3D;1±\frac{ix}{1!}-\frac{x^2}{2!}∓\frac{ix^3}{3!}+\frac{x^4}{4!}$$$$&#x3D;(1-\frac{x^2}{2!}+…)±i(x-\frac{x^3}{3!}…)$$</p><p>所以</p><p>$$e^{±ix}&#x3D;cosx±isinx$$</p><p>分开写得到：</p><p>$$e^{ix}&#x3D;cosx+isinx　　(1)$$$$e^{-ix}&#x3D;cosx-isinx　 (2)$$</p><p>(1)-(2)得到:</p><p>$$sinx&#x3D;\frac{e^{ix}-e^{-ix}}{2i}　(3)$$</p><p>(1)+(2)得到：</p><p>$$cosx&#x3D;\frac{e^{ix}+e^{-ix}}{2}　 (4)$$</p><p>上两式也称为欧拉公式。<br>对于（1）式，取$x&#x3D;\pi$，得到欧拉公式：</p><h1 id="e-pi-i-1-0-1"><a href="#e-pi-i-1-0-1" class="headerlink" title="$e^{\pi i}+1&#x3D;0$"></a>$e^{\pi i}+1&#x3D;0$</h1>]]></content>
    
    
    <summary type="html">&lt;p&gt;数学的确是人们从感性认知世界到理性度量世界的巨大的转变，既然历史已经走到了这里，那我们可以称它为是一种进步。So，我在这里观叹”上帝创造”的公式—— 欧拉公式 （又称为欧拉恒等式）。 $e^{&#92;pi i}+1&amp;#x3D;0$ 这个公式将复数单位——i，圆周率——$&#92;pi$，自然对数的底数——e，整数的单位——1以及人类最伟大的发明——0，联系在了一起，并由此…&lt;/p&gt;</summary>


    <category term="迷人数学" scheme="https://www.lightdream.xyz/categories/%E8%BF%B7%E4%BA%BA%E6%95%B0%E5%AD%A6/"/>
    
    
    <category term="数学" scheme="https://www.lightdream.xyz/tags/%E6%95%B0%E5%AD%A6/"/>
    
    <category term="欧拉公式" scheme="https://www.lightdream.xyz/tags/%E6%AC%A7%E6%8B%89%E5%85%AC%E5%BC%8F/"/>
    
    <category term="泰勒公式" scheme="https://www.lightdream.xyz/tags/%E6%B3%B0%E5%8B%92%E5%85%AC%E5%BC%8F/"/>
    
  </entry>
  
  <entry>
    <title>浅谈动态规划算法</title>
    <link href="https://www.lightdream.xyz/SummaryofDynamicPaogramming.html"/>
    <id>https://www.lightdream.xyz/SummaryofDynamicPaogramming.html</id>
    <published>2019-02-28T00:37:48.000Z</published>
    <updated>2020-05-24T22:11:32.711Z</updated>
    
    <content type="html"><![CDATA[<p>关于动态规划(Dynamic Programming)算法，我在算法设计课上理解得并不是多么深刻。所以自己还是下来查找资料，多方对比学习，以期有所获。在这里谈一下心路历程与总结。  </p><p>　　动态规划是运筹学中求解决策过程中的<strong>最优化</strong>数学方法。在计算机科学中，它也是一种程序算法设计技术。这就是基础科学在计算机科学中的一种应用。在这里我们只关注它作为算法设计技术的特性。</p><h3 id="LV1-初识"><a href="#LV1-初识" class="headerlink" title="LV1-初识"></a>LV1-初识</h3><p>　　一开始，课本上就扔出几个术语，最优子结构、重叠子问题，对于初学者来说的确是高深莫测，只有真的勇士才敢逆流而上，去一步一步剖析这些特性，最终能够领略它的独特风光。这里我们就逐个击破这些术语，揭开DP的面纱…</p><h4 id="最优子结构"><a href="#最优子结构" class="headerlink" title="最优子结构"></a>最优子结构</h4><p>下面我们直接看经典的<a href="http://acm.wust.edu.cn/problem.php?cid=1316&pid=5">数塔问题</a>:</p><blockquote><p>从数塔顶部开始往下走，每次往下走只能选一个节点，一直到最底层，使走过的所有节点的数字之和最大，求这个最大和。假设顶部为第一层，以此类推。<br>数组$number[i][j]$表示数塔第i层左起第j个元素。</p></blockquote><center><img src="image/numberTower.png" width="400" height="300"/></center>  我们假定:  $dp\[i\]\[j\]$表示从位置$(i,j)$到达数塔的最底层所经过路径的最大值。  我们要得到该最大值，就必须得到分别从位置$(i+1,j+1)$和$(i,j+1)$这两个节点出发，到达最底层时，所经过的数字的最大值。  此时，它们的关系为:<pre><code>dp[i][j]=max(dp[i][j+1],dp[i+1][j+1])+number[i][j]</code></pre><p>例如对于图中节点<strong>数字9</strong></p><pre><code>dp[1][1]=max(dp[2][1],dp[2][2])+9</code></pre><p>这样我们得到的一般的等式就称为状态转移方程。</p><ul><li><p>其中$dp[i][j]$表示一个状态，它的值总是来自于从子问题：$dp[i+1][j]$与$dp[i+1][j+1]$中选取一个较大值与当前节点数字相加，<br>之后对于节点$dp[i+1][j]$，它的值来自$dp[i+2][j]$与dp$[i+2][j+1]$中较大值与当前节点$number[i][j]$的和；$dp[i+1][j+1]$亦然。<br><strong>这就是最优子结构性质</strong>，每一个问题都划分为两个子问题，然后在两个子问题中选择最优的(也就是所经过的数字之和最大)，得到母问题的最优解(当然是最优的)。</p></li><li><p>最终到了数塔最底层，此时已没有子问题，所以<br>假设数塔有n层，第n层有m个元素，<br>则$dp[n][j]&#x3D;number[n][j]（1\leq j \leq m）$，这就称为递推边界。<br>从递推边界开始，根据状态转移方程，最终得到最优解$dp[1][1]$。<br>下面是C++代码:</p><pre><code class="lang-C++">#include&lt;iostream&gt;#include&lt;array&gt;#define ROW 4#define COL 4using namespace std;int main()&#123;  array&lt;array&lt;int, ROW+1&gt;, COL+1&gt; tower;  array&lt;array&lt;int, ROW+1&gt;, COL+1&gt; dp;  for(int i = 0; i &lt; ROW; i++)      tower[i].fill(0);  for(int i = 1; i &lt;= ROW; i++)      for(int j = 1; j &lt;= i; j++)          cin &gt;&gt; tower[i][j];  for(int i = 1; i &lt;= ROW; i++)         // 递推边界      dp[ROW][i] = tower[ROW][i];  for(int i = ROW - 1; i &gt;= 1; i--)  &#123;      for(int j = 1; j &lt;= i; j++)      &#123;          dp[i][j] = max(dp[i + 1][j], dp[i +  1][j + 1]) + tower[i][j];  // 状态转移方程递推      &#125;  &#125;  cout &lt;&lt; dp[1][1] &lt;&lt; endl;  return 0;&#125;</code></pre></li></ul><h4 id="总结分析过程"><a href="#总结分析过程" class="headerlink" title="总结分析过程"></a>总结分析过程</h4><ol><li>我们一开始提出用$dp[i][j]$表示从u数塔位置$(i,j)$到最底层，这就是它的意义所在，我们需要找到一个递推关系，也就是动态转移方程。所以我们在使用动态规划算法设计程序时，首先要明确$dp[i][j]$这个状态的意义。当然，这肯定是一个艰难的过程。</li><li>在我们明白这个$dp[i][j]$所表示的意义时，就要通过正推或者逆推得到状态转移方程。步骤1、2我这里分开是便于叙述，在思考时是万万不能分开的。要根据问题，怎样设计出合理的$dp[i][j]$表示的状态，得到状态转移方程。</li><li>最后，在前两步完成的情况下，思考出递推边界情况，可以通过正推状态转移方程也可以逆推状态转移方程得出边界。</li></ol><h3 id="上面的数塔问题包含最优子结构性质，下面再解析重叠子问题。"><a href="#上面的数塔问题包含最优子结构性质，下面再解析重叠子问题。" class="headerlink" title="上面的数塔问题包含最优子结构性质，下面再解析重叠子问题。"></a>上面的数塔问题包含最优子结构性质，下面再解析重叠子问题。</h3><p>经典问题</p><blockquote><p>求解斐波那契数列的第n项。</p></blockquote><p>我们很容易写出递归式:</p><pre><code class="lang-c++">int f(int n)&#123;    if(n &lt; 0)        return -1;    if(n == 1 || n == 2)        return 1;    return f(n-1) + f(n-2);&#125;</code></pre><p>对于该递归我们可以得到一棵二叉树:  </p><center><img src="image/recursion.png" width="500" height="300"/></center>  图中，我们在对$f(5)$递归求解时调用了两次$f(3)$，我们明明可以只用求解一次然后将答案记录下来，再用时直接访问答案就可以了。这就是重叠子问题。  这里就要提一下备忘录方法了，这其实是动态规划的变形，并且它将计算过的子问题都会保存到数组中，下一次遇见相同的子问题直接调用即可。<ul><li><p>我们用$dp[n]$表示第$n$项斐波那契数列，不难得到其动态转移方程为</p><pre><code class="lang-c++">dp[n]=dp[n-1]+dp[n-2]</code></pre></li><li><p>其递归边界dp[1]&#x3D;1,dp[2]&#x3D;1，所以我们可以写出使用自顶向下的备忘录方法求解斐波那契数列</p><pre><code class="lang-c++">array &lt; int, 100&gt; dp = &#123;0&#125;;int f(int n)&#123;  if(n &lt; 0)      return -1;  if(dp[n])      return dp[n];  if(n == 1 || n == 2)      return dp[1] = dp[2] = 1;  return dp[n] = f(n - 1) + f(n - 2);&#125;</code></pre><p>当然我们也可以写成动态规划形式，假设求第$n$项斐波那契数列:</p><pre><code class="lang-c++">array &lt; int, 47&gt; dp = &#123;0&#125;;        // 整形范围内，第47项斐波那契数列溢出dp[1]=dp[2]=1;for(int i=3;i&lt;=n;i++)&#123;  dp[i]=dp[i-1]+dp[i-2];&#125;</code></pre><p>可以观察到在求解$dp[n]$的过程中，只有$dp[n-1]$和$dp[n-2]$有效，比如$dp[3]&#x3D;dp[2]+dp[1]，dp[4]&#x3D;dp[3]+dp[2]$，而$dp[1]$已经没有用处了。所以我们完全可以不用数组，只用两个变量$a,b$：</p><pre><code class="lang-c++">int f(int n)&#123;  if(n &lt; 0)      return -1;  if(n == 1 || n == 2)      return 1;  int a = 1, b = 1, ans = 0;  for(int i = 3; i &lt;= n; i++)  &#123;      ans = a + b;      a = b;      b = ans;  &#125;  return ans;&#125;</code></pre><p>空间复杂度由$O(n)$下降到$O(1)$，不得不说这是一个巨大的飞跃。所以根据动态规划的递推式，我们可以通过观察来一定程度优化空间复杂度，这都是后话了。</p></li></ul><h3 id="综述"><a href="#综述" class="headerlink" title="综述"></a>综述</h3><p>  　　关于动态规划算法，我这里展示的只是冰山一角。每个人都会有其独特的理解，有人认为它是在填矩阵，有人认为它是一种拓扑排序（想来的确如此），如《哈姆雷特》一般。<br>  对于我们普通人来说，不可能一次就完完全全的领悟。需要一段时间的沉淀，需要不断地总结、练习，以更上一层楼。<br>  推荐阅读：<br>  <a href="https://mp.weixin.qq.com/s/3h9iqU4rdH3EIy5m6AzXsg">https://mp.weixin.qq.com/s/3h9iqU4rdH3EIy5m6AzXsg</a></p>]]></content>
    
    
    <summary type="html">&lt;p&gt;关于动态规划(Dynamic Programming)算法，我在算法设计课上理解得并不是多么深刻。所以自己还是下来查找资料，多方对比学习，以期有所获。在这里谈一下心路历程与总结。 动态规划是运筹学中求解决策过程中的 最优化 数学方法。在计算机科学中，它也是一种程序算法设计技术。这就是基础科学在计算机科学中的一种应用。在这里我们只关注它作为算法设计技术的特性。…&lt;/p&gt;</summary>


    <category term="算法与数据结构" scheme="https://www.lightdream.xyz/categories/%E7%AE%97%E6%B3%95%E4%B8%8E%E6%95%B0%E6%8D%AE%E7%BB%93%E6%9E%84/"/>
    
    
    <category term="dp" scheme="https://www.lightdream.xyz/tags/dp/"/>
    
    <category term="动态规划" scheme="https://www.lightdream.xyz/tags/%E5%8A%A8%E6%80%81%E8%A7%84%E5%88%92/"/>
    
  </entry>
  
  <entry>
    <title>7-36 复数四则运算 （15 分）</title>
    <link href="https://www.lightdream.xyz/complexCalc.html"/>
    <id>https://www.lightdream.xyz/complexCalc.html</id>
    <published>2019-02-22T05:49:10.000Z</published>
    <updated>2020-05-24T22:10:58.379Z</updated>
    
    <content type="html"><![CDATA[<p>亲爱的您既然来看这道题的题解，那么您很有可能落入了一个题目的陷阱，在这里，我建议亲再<strong>仔仔细细的</strong>回去读一下题目呢，也好给自己留一个深刻的教训。  </p><p>这是<a href="https://pintia.cn/problem-sets/14/problems/816">题链接</a>，</p><ul><li><p>注意到题面</p><pre><code>如果结果的实部或者虚部为0，则不输出。如果结果为0，则输出0.0。</code></pre><p>注意一个词，<strong>结果</strong>！也就是打印时，等号左边和右边不是一个规则：</p></li><li><p><strong>对于结果，实部或者虚部为0，则不输出；然而，对于算式也就是等式右边，实部或者虚部为0，则 还 是 需 要 进 行 输 出</strong></p></li><li><p>哈哈哈😆😆555😭😭~</p></li></ul><h2 id="深刻的反思"><a href="#深刻的反思" class="headerlink" title="深刻的反思"></a><strong>深刻的反思</strong></h2><p>  由于我过早的考虑代码复用，就把等式左右两边打印复数用了同一套规则，结果一时错，一时爽；一直错，一直爽…被折磨了两小时。<br>  一开始打印部分我是这样写的:</p><pre><code>  void printExp(double a, double b, bool flag)  &#123;    if(abs(a) &lt; 0.05 &amp;&amp; abs(b) &lt; 0.05)    &#123;        printf(&quot;0.0&quot;);    &#125;    else    &#123;        if(flag)            printf(&quot;(&quot;);        // 实部        if(abs(a) &gt;= 0.05)        &#123;            printf(&quot;%.1lf&quot;, a);        &#125;        // 虚部        if(abs(b) &gt;= 0.05)        &#123;            // 虚部的 + 符号            if(b &gt; 0 &amp;&amp; abs(a) &gt;= 0.05)                printf(&quot;+&quot;);            printf(&quot;%.1lfi&quot;, b);        &#125;        if(flag)            printf(&quot;)&quot;);    &#125;  &#125;  void printExpTotal(double a1, double b1, double a2, double b2, char x)  &#123;    printExp(a1, b1, 1);    printf(&quot; %c &quot;, x);    printExp(a2, b2, 1);    printf(&quot; = &quot;);  &#125;</code></pre><p>  后来我是这样写的:</p><pre><code>  void printExp(double a, double b)  &#123;    if(abs(a) &lt; 0.05 &amp;&amp; abs(b) &lt; 0.05)    &#123;        printf(&quot;0.0&quot;);    &#125;    else    &#123;        // 实部        if(abs(a) &gt;= 0.05)        &#123;            printf(&quot;%.1lf&quot;, a);        &#125;        // 虚部        if(abs(b) &gt;= 0.05)        &#123;            // 虚部的 + 符号            if(b &gt; 0 &amp;&amp; abs(a) &gt;= 0.05)                printf(&quot;+&quot;);            printf(&quot;%.1lfi&quot;, b);        &#125;    &#125;  &#125;  void printExpTotal(double a1, double b1, double a2, double b2, char x)  &#123;    printf(&quot;(%.1lf&quot;, a1);    if(b1 &gt;= 0)        printf(&quot;+&quot;);    printf(&quot;%.1lfi)&quot;, b1);    printf(&quot; %c &quot;, x);    printf(&quot;(%.1lf&quot;, a2);    if(b2 &gt;= 0)        printf(&quot;+&quot;);    printf(&quot;%.1lfi)&quot;, b2);    printf(&quot; = &quot;);  &#125;</code></pre><p>  果断捧回AC<br>  完整代码见我的<a href="https://github.com/lightingmoon/BlogResourceCode/blob/master/%E5%A4%8D%E6%95%B0%E5%9B%9B%E5%88%99%E8%BF%90%E7%AE%97/complexCalc.cpp">Github</a><br>  <strong>过早优化是万恶之源，不<em>看清、想清题目要求</em>就想着优化则是万恶源之源</strong>！</p>]]></content>
    
    
    <summary type="html">&lt;p&gt;亲爱的您既然来看这道题的题解，那么您很有可能落入了一个题目的陷阱，在这里，我建议亲再 仔仔细细的 回去读一下题目呢，也好给自己留一个深刻的教训。 这是 题链接 ， 注意到题面 如果结果的实部或者虚部为0，则不输出。如果结果为0，则输出0.0。 注意一个词， 结果 ！也就是打印时，等号左边和右边不是一个规则： 对于结果，实部或者虚部为0，则不输出；然而，对于算…&lt;/p&gt;</summary>


    <category term="PAT" scheme="https://www.lightdream.xyz/categories/PAT/"/>
    
    
    <category term="PAT" scheme="https://www.lightdream.xyz/tags/PAT/"/>
    
    <category term="反思" scheme="https://www.lightdream.xyz/tags/%E5%8F%8D%E6%80%9D/"/>
    
  </entry>
  
  <entry>
    <title>7-23 币值转换 （20 分）</title>
    <link href="https://www.lightdream.xyz/num2Chinese.html"/>
    <id>https://www.lightdream.xyz/num2Chinese.html</id>
    <published>2019-02-21T01:20:49.000Z</published>
    <updated>2020-05-24T22:11:12.866Z</updated>
    
    <content type="html"><![CDATA[<p>这是一道比较麻烦的模拟题，思路和方式决定着代码量😏。<a href="https://pintia.cn/problem-sets/14/problems/803">原题链接</a>，可以先去做一下😀。  </p><p>　　经历了一些小挫折以后还是AC了，题面就不搬了，开始分析:</p><ol><li><p>可以用一个数组保存相应位的单位，这样就不用分心考虑单位了，而只考虑各个位数字之间的关系。<br><strong>为了相应的下标与其单位保持一致，整体后移一位。</strong></p><pre><code class="lang-C++">array&lt;char, 10&gt; base = &#123;0, &#39;S&#39;, &#39;B&#39;, &#39;Q&#39;, &#39;W&#39;, &#39;S&#39;, &#39;B&#39;, &#39;Q&#39;, &#39;Y&#39;&#125;;</code></pre></li><li><p>接下来讨论数字之间的关系。</p></li></ol><ul><li><p>可以将数字拆开放进一个数组，这样就完成了单位的映射。</p><pre><code class="lang-C++">int total=0;while(n)&#123;  s[total++] = n % 10;  n /= 10;&#125;</code></pre></li><li><p>最高位一定不是0，用pre记录前一位数字。<br>1). 如果当前位为0，且pre也为0，结束本次循环；<strong>特别的，当数字的万位也就是当前索引是4时，在前面的条件下，要输出一个W。</strong><br>2). 如果当前位不为0，但pre为0，这就是中间的0了，只用输出一次0，然后再输出本位数字和单位，例如100010。<br>3). 如果末尾全是0，则不用进行输出，在之前非0的那一位已经输出了。<br>下面是C++代码:</p></li></ul><pre><code class="lang-C++">#include&lt;bits/stdc++.h&gt;using namespace std;typedef long long LL;int main()&#123;    array&lt;int, 9&gt; s = &#123;-1&#125;;    array&lt;char, 10&gt; num;    array&lt;char, 10&gt; base = &#123;0, &#39;S&#39;, &#39;B&#39;, &#39;Q&#39;, &#39;W&#39;, &#39;S&#39;, &#39;B&#39;, &#39;Q&#39;, &#39;Y&#39;&#125;;    int n, total = 0;    for(int i = 0; i &lt; 10; i++)        // 数字与小写字母的映射        num[i] = &#39;a&#39;+ i;    cin &gt;&gt; n;    if(n == 0)        // 单独处理0        cout &lt;&lt; num[0];    else    &#123;        while(n)        &#123;            s[total++] = n % 10;    // 将数字拆出来            n /= 10;        &#125;        int pre = -1;        for(int i = total - 1; i &gt;= 0 ; i--)    // 从高到低位        &#123;            if(s[i])            &#123;                if(pre == 0)                    cout &lt;&lt; num[0];        // 中间的0，只输出一次                cout &lt;&lt; num[s[i]] &lt;&lt; base[i];    // 输出数字与单位            &#125;            else            &#123;                if(i == 4)                    cout &lt;&lt; base[4];    // 中间的0里面有万位，另外输出                if(pre == 0)    // 中间0，跳过处理                    continue;            &#125;            pre = s[i];        &#125;    &#125;    cout &lt;&lt; &#39;\n&#39;;    return 0;&#125;</code></pre><p>反思:<br><strong>在做比较麻烦的模拟题时，千万不要顺着思路去模拟，要时常跳出思维，要自己制定规则，<br>怎么方便怎么来。有时候顺着写，枚举特例，不仅大大增加了代码量，而且枚举时可能会漏掉某些条件，最终功败垂成。</strong></p>]]></content>
    
    
    <summary type="html">&lt;p&gt;这是一道比较麻烦的模拟题，思路和方式决定着代码量😏。 原题链接 ，可以先去做一下😀。 经历了一些小挫折以后还是AC了，题面就不搬了，开始分析: 可以用一个数组保存相应位的单位，这样就不用分心考虑单位了，而只考虑各个位数字之间的关系。 为了相应的下标与其单位保持一致，整体后移一位。 array&amp;lt;char, 10&amp;gt; base = &amp;#123;0,…&lt;/p&gt;</summary>


    <category term="PAT" scheme="https://www.lightdream.xyz/categories/PAT/"/>
    
    
    <category term="PAT" scheme="https://www.lightdream.xyz/tags/PAT/"/>
    
  </entry>
  
  <entry>
    <title>机器学习之线性回归</title>
    <link href="https://www.lightdream.xyz/MachineLearning-LinerRegression.html"/>
    <id>https://www.lightdream.xyz/MachineLearning-LinerRegression.html</id>
    <published>2019-02-20T00:41:06.000Z</published>
    <updated>2020-04-04T07:24:56.400Z</updated>
    
    <content type="html"><![CDATA[<p>自己早已对机器学习观望已久，现在不入门，更待何时？在找到<a href="https://www.coursera.org/learn/machine-learning">Coursera</a>时，发现教学方法很对胃口，于是开始ML之旅…现在在这里总结一下机器学习之线性回归。  </p><p>　　机器学习有很多种方式，比如监督学习，半监督学习，无监督学习等。它们区别于训练集的种类，比如监督学习的训练集其每一个训练样本都有正确的答案，而无监督学习则没有，只能通过算法自动分类。而半监督学习，顾名思义，一部分是监督学习，一部分是无监督学习。</p><h3 id="监督学习"><a href="#监督学习" class="headerlink" title="监督学习"></a>监督学习</h3><p>　　监督学习又分为聚类和回归。其中聚类是预测连续值，回归是预测离散值。例如垃圾邮件识别，网页类别划分等是聚类。预测房价、股票涨跌等是回归。<br>下面总结一下线性回归。</p><h3 id="线性回归"><a href="#线性回归" class="headerlink" title="线性回归"></a>线性回归</h3><p>线性回归模型</p><blockquote><p>截取自Coursera课程课件</p></blockquote><center><img src="image/LinerRgressionModel.png" width="450" height="300"/></center>  <p>假设有房价数据集如下:</p><table><thead><tr><th>房子面积&#x2F;$m_{2}$(x)</th><th>价格&#x2F;w(y)</th></tr></thead><tbody><tr><td>80</td><td>40</td></tr><tr><td>90</td><td>60</td></tr><tr><td>100</td><td>80</td></tr><tr><td>…</td><td>…</td></tr></tbody></table><p><strong>数据集1</strong><br>以下为一些字母的含义：</p><hr><table><thead><tr><th>字母</th><th>含义</th></tr></thead><tbody><tr><td>$m$</td><td>表示训练样本数量</td></tr><tr><td>$x$</td><td>表示输入特征(特征量)</td></tr><tr><td>$y$</td><td>表示输出变量(目标量)</td></tr><tr><td>$(x,y)$</td><td>表示一个训练样本</td></tr><tr><td>$(x^{(i)},y^{(i)})$</td><td>表示第i个训练样本</td></tr></tbody></table><hr><p>对应于线性回归的**假设函数(hypothesis function)**为</p><p>$$h_{\theta}(x)&#x3D;\theta_{0}+\theta_{1}x$$</p><p>其中$\theta$为参数<br>对应的<strong>代价函数(cost function)</strong>(其图像为一个凹函数)为</p><p>$$J(\theta_{0},\theta_{1})&#x3D;\frac{1}{2m}\sum_{i&#x3D;1}^{m}(h_{\theta}(x^{(i)})-y^{(i)})^2$$</p><p>这个方程有什么<strong>意义</strong>呢？<br>下面是一个散点图:</p><center><img src="image/linerRegression.png" width="450" height="300"/></center>  <p>由图片e表示假设函数结果与训练样本之间的误差。</p><p>$$e_{0}&#x3D;h_{\theta}(1)-y_{0}$$$$e_{1}&#x3D;h_{\theta}(2)-y_{1}$$$$e_{2}&#x3D;h_{\theta}(3)-y_{2}$$$$…$$</p><p>所有误差的和即为</p><p>$$\sum_{i&#x3D;1}^{m}(h_{\theta}(x^{(i)})-y^{(i)})$$</p><p>要想得到拟合最好的效果，我们必须要让误差和最小。但是通常我们都用平均每个训练样本的误差的一半来表示。也即代价函数：</p><p>$$J(\theta_{0},\theta_{1})&#x3D;\frac{1}{2m}\sum_{i&#x3D;1}^{m}(h_{\theta}(x^{(i)})-y^{(i)})^2$$</p><p>此时得到的参数$\theta_{0},\theta_{1}$为最合适的参数。</p><hr><h3 id="梯度下降算法-Gradient-Descent-Algorithm"><a href="#梯度下降算法-Gradient-Descent-Algorithm" class="headerlink" title="梯度下降算法(Gradient Descent Algorithm)"></a>梯度下降算法(Gradient Descent Algorithm)</h3><p>$$\theta_{j}&#x3D;\theta_{j}-\alpha\frac{\partial{J(\theta_{0},\theta_{1})}}{\partial{j}}$$</p><p>其中$\theta$表示参数，$\alpha(\geq0)$表示学习效率，后面表示$\theta_{j}$的偏导。<br>为了叙述方便，下面令$\theta_{0}&#x3D;0$，此时$J({\theta_{1}})$只有一个参数$\theta_{1}$，令$J(\theta)$最小值对应于$\theta_{min}$</p><ul><li>假如$\theta_{1}&gt;\theta_{min}$，则该点切线斜率大于等于0，即$\frac{dJ(\theta_{1})}{d\theta_{1}}\geq 0$(因为只有一个参数，所以退化为求微分)，所以$\theta_{1}&#x3D;\theta_{1}-\alpha\frac{dJ(\theta_{1})}{d\theta_{1}}$，$\theta_{1}$减去一个正数，$\theta_{1}$减小，则$\theta_{1}$更靠近$\theta_{min}$</li><li>$\theta_{1}&lt;\theta_{min}$分析方法类似</li></ul><h3 id="梯度下降算法在线性回归中的应用"><a href="#梯度下降算法在线性回归中的应用" class="headerlink" title="梯度下降算法在线性回归中的应用"></a>梯度下降算法在线性回归中的应用</h3><p>　　将之前的代价函数带入梯度下降算法里，得到(其实就是复合函数求导，可以手动算一下):</p><p>$$\theta_{0}&#x3D;\theta_{0}-\alpha\frac{1}{m}\sum_{i&#x3D;1}^{m}(h_{\theta}(x^{(i)})-y^{(i)})$$$$\theta_{1}&#x3D;\theta_{1}-\alpha\frac{1}{m}\sum_{i&#x3D;1}^{m}(h_{\theta}(x^{(i)})-y^{(i)})*x_{1}$$</p><h2 id="多元线性回归"><a href="#多元线性回归" class="headerlink" title="多元线性回归"></a>多元线性回归</h2><p>有数据集如下:</p><table><thead><tr><th>$x_{0}$</th><th>房子面积&#x2F;$m_{2}(x_{1})$</th><th>卧室数量$(x_{2})$</th><th>层数$(x_{3})$</th><th>房子寿命$(x_{4})$</th><th>价格&#x2F;w(y)</th></tr></thead><tbody><tr><td>1</td><td>80</td><td>1</td><td>1</td><td>50</td><td>50</td></tr><tr><td>1</td><td>90</td><td>2</td><td>2</td><td>60</td><td>60</td></tr><tr><td>1</td><td>100</td><td>3</td><td>3</td><td>70</td><td>60</td></tr><tr><td>…</td><td>…</td><td>…</td><td>…</td><td>…</td><td>…</td></tr></tbody></table><p><strong>数据集2</strong><br><strong>PS:为了$\theta_{i}$与$x_{j}$下标一致，所以多加一列，其所有值都为1</strong></p><p>补充字母含义:</p><table><thead><tr><th>字母</th><th>含义</th></tr></thead><tbody><tr><td>n</td><td>特征数量</td></tr><tr><td>$x^{(i)}$</td><td>第i个训练样本</td></tr><tr><td>$x^{(i)}_{j}$</td><td>$i^{th}$训练样本$j^{th}$特征值</td></tr></tbody></table><p>此时,假设函数为:</p><p>$$h_{\theta}(x)&#x3D;\theta_{0}x_{0}+\theta_{1}x_{1}+\theta_{2}x_{2}+…+\theta_{n}x_{n}$$</p><p>代价函数:</p><p>$$J(\theta)&#x3D;\frac{1}{2m}\sum_{i&#x3D;1}^{m}(\theta^{T}x^{(i)}-y^{(i)})^2$$</p><p>也等价于</p><p>$$J(\theta)&#x3D;\frac{1}{2m}\sum_{i&#x3D;1}^{m}((\sum_{j&#x3D;0}^{n}\theta_{j}x_{j}^{(i)})-y^{(i)})^2$$</p><p>则梯度下降算法对应的偏导为:</p><p>$$\theta_{j}&#x3D;\theta_{j}-\alpha\frac{1}{m}\sum_{i&#x3D;1}^{m}(h_{\theta}(x^{(i)})-y^{(i)})*x_{j}^{(i)}$$</p><h3 id="加快梯度下降算法收敛方法"><a href="#加快梯度下降算法收敛方法" class="headerlink" title="加快梯度下降算法收敛方法"></a>加快梯度下降算法收敛方法</h3><ol><li>特征缩放(feature scaling)<br>　保证每个特征量范围都在$-1\geq x_{i}\geq 1$，每个特征值除以该特征范围。</li><li>均值归一化(mean normalization)<br>　保证特征变量在$-0.5\geq x_{i} \geq 0.5$，令$$x_{i}&#x3D;\frac{x_{i}-\mu_{i}}{s_{i}}$$其中，$\mu_{i}$表示$i^{th}$特征的均值，$s_{i}$表示表示$i^{th}$特征的范围或标准差。</li><li>调整学习效率$\alpha$<br>　$\alpha$必须足够小，且$J(\theta)$必须在每一次迭代后减小，可以以每次为原来的3倍来调整$\alpha$。<ul><li>当$\alpha$太小，算法收敛过慢。</li><li>当$\alpha$太大，$J(\theta)$可能在迭代若干次后开始增加，最终算法不能收敛。</li></ul></li></ol><h2 id="多项式线性回归"><a href="#多项式线性回归" class="headerlink" title="多项式线性回归"></a>多项式线性回归</h2><p>　当假设函数不再是线性时，可以通过平方，立方，开平方来进行多项式拟合。<br>e.g<br>$h_{\theta}(x)&#x3D;\theta_{0}+\theta_{1}x_{1}$<br>对于<strong>数据集1</strong>，可以令</p><ol><li>$h_{\theta}(x)&#x3D;\theta_{0}+\theta_{1}x_{1}^{2}$<br>此函数为二次函数，根据实际情况，房价不可能随面积增大而减小。</li><li>$h_{\theta}(x)&#x3D;\theta_{0}+\theta_{1}x+\theta_{1}x_{1}^{2}+\theta_{2}x_{1}^{3}$<br>此函数中，令$x_{2}&#x3D;x_{1}^{2}，x_{3}&#x3D;x^{3}_{1}$，此时，三个特征范围相差过大，对于特征值归一化有不利影响。</li><li>$h_{\theta}(x)&#x3D;\theta_{0}+\theta_{1}x_{1}+\theta_{2}\surd{x_{1}}$<br>此时较符合模型。运用此方法 ，特征缩放很重要，而且特征之间关联程度要小。</li></ol><h2 id="正规方程-Normal-Equation"><a href="#正规方程-Normal-Equation" class="headerlink" title="正规方程(Normal Equation)"></a>正规方程(Normal Equation)</h2><p>　对于训练样本数为m，特征数为n，<br>令矩阵</p><p>$$X&#x3D;\left[   \begin{matrix} x_0^{i} &amp; x_1^{i} &amp; x_2^{i} &amp; x_3^{i} &amp;…\end{matrix}   \right]^{T}$$</p><p>其中$(1\leq i \leq m)$，X为m*(n+1)阶矩阵。</p><p>$$y&#x3D;\left[ \begin{matrix} y^{(1)} \<br>            y^{(2)} \<br>            … \<br>            y^{(m)} \end{matrix} \right]$$</p><p>有正规方程，在数学上可证明其正确性:</p><p>$$\theta&#x3D;(X^{T}X)^{-1}X^{T}y$$</p><p>最终$\theta$为1*(n+1)阶矩阵</p><h3 id="梯度下降算法与正规方程比较"><a href="#梯度下降算法与正规方程比较" class="headerlink" title="梯度下降算法与正规方程比较"></a>梯度下降算法与正规方程比较</h3><table><thead><tr><th>梯度下降算法</th><th>正规方程</th></tr></thead><tbody><tr><td>需要选择$\alpha$</td><td>不需要选择$\alpha$</td></tr><tr><td>需要多次迭代</td><td>不需要迭代</td></tr><tr><td>时间复杂度为$O(kn^{2}$)</td><td>$O(n^{3}$)，主要在矩阵求逆</td></tr><tr><td>当n很大时，能运行得不错</td><td>当n很大时，因为矩阵求逆而速度很慢</td></tr></tbody></table><p><strong>注: 当n大于10000时，考虑用梯度下降算法</strong></p><h3 id="正规方程不可逆"><a href="#正规方程不可逆" class="headerlink" title="正规方程不可逆"></a>正规方程不可逆</h3><ol><li>存在多余的特征，即存在关联程度很大的特征，此时可以分析特征，删去关联程度大的特征中一个。</li><li>特征值太多，例如$m&lt;n$。此时可以删去存在关联的特征，或进行正则化。</li></ol><p>夜已深，就总结到这里，接下来准备做一个小项目。晚安~</p>]]></content>
    
    
    <summary type="html">&lt;p&gt;自己早已对机器学习观望已久，现在不入门，更待何时？在找到 Coursera 时，发现教学方法很对胃口，于是开始ML之旅…现在在这里总结一下机器学习之线性回归。 机器学习有很多种方式，比如监督学习，半监督学习，无监督学习等。它们区别于训练集的种类，比如监督学习的训练集其每一个训练样本都有正确的答案，而无监督学习则没有，只能通过算法自动分类。而半监督学习，顾名思…&lt;/p&gt;</summary>


    <category term="机器学习" scheme="https://www.lightdream.xyz/categories/%E6%9C%BA%E5%99%A8%E5%AD%A6%E4%B9%A0/"/>
    
    
    <category term="ML" scheme="https://www.lightdream.xyz/tags/ML/"/>
    
    <category term="梯度下降算法" scheme="https://www.lightdream.xyz/tags/%E6%A2%AF%E5%BA%A6%E4%B8%8B%E9%99%8D%E7%AE%97%E6%B3%95/"/>
    
    <category term="正规方程" scheme="https://www.lightdream.xyz/tags/%E6%AD%A3%E8%A7%84%E6%96%B9%E7%A8%8B/"/>
    
    <category term="监督学习" scheme="https://www.lightdream.xyz/tags/%E7%9B%91%E7%9D%A3%E5%AD%A6%E4%B9%A0/"/>
    
    <category term="线性回归" scheme="https://www.lightdream.xyz/tags/%E7%BA%BF%E6%80%A7%E5%9B%9E%E5%BD%92/"/>
    
  </entry>
  
  <entry>
    <title>二分算法总结</title>
    <link href="https://www.lightdream.xyz/BinaryPractice.html"/>
    <id>https://www.lightdream.xyz/BinaryPractice.html</id>
    <published>2019-02-12T00:42:21.000Z</published>
    <updated>2019-02-17T00:23:21.394Z</updated>
    
    <content type="html"><![CDATA[<p>关于二分算法想必大家也是耳熟能详,但是在实施算法时，往往在细节方面由于没有考虑周全而抓耳挠腮，百思不得其解。这很正常。因为当年在学术界，第一个正确的二分算法写出来就花了<strong>20</strong>年；又不正常。现在，对于二分算法无论是理论研究还是实际运用都已经很纯熟了，我们既然可以站在巨人的肩膀上，那又何乐而不为呢？  </p><p>　　这里总结一下一些常用的二分算法的写法。</p><h3 id="一、二分查找"><a href="#一、二分查找" class="headerlink" title="一、二分查找"></a>一、二分查找</h3><p>　　查找序列为<strong>严格递增序列</strong>，元素所在区间为[0,n-1]。当元素存在重复时，它不保证返回序列中第一个该元素的索引，故待查找序列不应存在重复元素。</p><pre><code>int binarySearch(int l, int r, int x)&#123;    int mid;    while(l &lt;= r)            /* 若此时l==r，还要进行一次查找*/    &#123;                        /* 当l&gt;r时，查找失败，退出循环*/        mid = (l + r) / 2;    /* 备注1 */        if(s[mid] == x)        /* 返回元素所在序列的索引*/            return mid;        if(s[mid] &gt; x)            r = mid - 1;    /* 此时目标元素x存在区间为[l,mid - 1]*/        else            l = mid + 1;    /* 此时目标元素x存在区间为[mid + 1,r]*/    &#125;    return -1;                /* 没有找到，返回-1*/&#125;</code></pre><p><strong>备注1：此处可能存在 l + r 溢出int范围，所以可以用 l + (r-l)&#x2F;2避免溢出</strong></p><h3 id="二、解析STL中lower-bound和upper-bound"><a href="#二、解析STL中lower-bound和upper-bound" class="headerlink" title="二、解析STL中lower_bound和upper_bound"></a>二、解析<a href="https://baike.baidu.com/item/STL/70103">STL</a>中lower_bound和upper_bound</h3><h5 id="lower-bound-求序列中第一个大于等于目标元素x的索引"><a href="#lower-bound-求序列中第一个大于等于目标元素x的索引" class="headerlink" title="lower_bound(求序列中第一个大于等于目标元素x的索引)"></a>lower_bound(求序列中第一个大于等于目标元素x的索引)</h5><p>　　查找序列为非递减序列，初始区间为[1,n]——(因为x可能大于序列中所有的元素，此时满足条件的元素就是其本身，此时返回值为n)，</p><pre><code>int lower_bound(int l, int r, int x)&#123;    int mid;    while(l &lt; r)            /* 当l==r时，该位置唯一，循环结束*/    &#123;        mid = l + (r - l) / 2;        if(s[mid] &gt;= x)        /* 第一个大于等于x的索引在[l, mid]里 */            r = mid;        else            l = mid + 1;    /* 第一个大于等于x的索引在[mid+1, r]里 */    &#125;    return l;&#125;</code></pre><h5 id="upper-bound-求序列中第一个大于目标元素x的索引"><a href="#upper-bound-求序列中第一个大于目标元素x的索引" class="headerlink" title="upper_bound(求序列中第一个大于目标元素x的索引)"></a>upper_bound(求序列中第一个大于目标元素x的索引)</h5><p>　　查找序列为非递减序列，代码与与上面类似。</p><pre><code>int lower_bound(int l, int r, int x)&#123;    int mid;    while(l &lt; r)            /* 当l==r时，该位置唯一，即是目标位置，循环结束*/    &#123;        mid = l + (r - l) / 2;        if(s[mid] &gt; x)        /* 第一个大于x的索引在[l, mid]里 */            r = mid;        else            l = mid + 1;    /* 第一个大于x的索引在[mid+1, r]里 */    &#125;    return l;&#125;</code></pre><h3 id="三、二分思想运用"><a href="#三、二分思想运用" class="headerlink" title="三、二分思想运用"></a>三、二分思想运用</h3><p>看一道经典题:</p><blockquote><p>给出N个线段长度，试将它们头尾相接组合成一个凸多边形，使凸多边形的外接圆（多边形每个顶点都在圆上）的半径最大，求该最大半径。其中N&lt;&#x3D;10^5，线段长度均不超过100，要求算法中不涉及坐标的计算。</p></blockquote><h4 id="分析"><a href="#分析" class="headerlink" title="分析:"></a>分析:</h4><h5 id="思路1"><a href="#思路1" class="headerlink" title="思路1"></a>思路1</h5><p>首先，因为圆心不确定，想涉及坐标计算也无能为力啊😂。<br>其次，考验数学时候来啦。我们可以确定当圆是凸多边形外接圆时，该多边形内角和为$π*(n-2)$，对于每一条弦（题中线段），与两条半径组成等腰三角形，解该等腰三角形其底角为</p><p>$$α_{i}&#x3D;arccos(\frac{s_{i}&#x2F;2}{r})$$</p><p>则凸多边形内角和为$\sum_{i&#x3D;0}^{n-1}α_{i}$。此时则可以二分$r$，当内角和小于误差限时，即得到最大半径。</p><h5 id="思路2"><a href="#思路2" class="headerlink" title="思路2"></a>思路2</h5><p>换一个角度，一条线段(弦)对应的圆心角为</p><p>$$α_{i}&#x3D;arcsin(\frac{s_{i}&#x2F;2}{r})$$</p><p>而当r确定，所有的弦对应的圆心角和$\sum_{i&#x3D;0}^{n-1}α_{i}&#x3D;2π$，此时可以二分$r$，当内角和小于误差限时，即得到最大半径。<br>思路1和2，C++代码链接：<a href="https://github.com/lightingmoon/BlogResourceCode/blob/master/%E4%BA%8C%E5%88%86%E7%AE%97%E6%B3%95%E6%80%BB%E7%BB%93/findMaxRadius.cpp">二分思想题解</a></p>]]></content>
    
    
    <summary type="html">&lt;p&gt;关于二分算法想必大家也是耳熟能详,但是在实施算法时，往往在细节方面由于没有考虑周全而抓耳挠腮，百思不得其解。这很正常。因为当年在学术界，第一个正确的二分算法写出来就花了 20 年；又不正常。现在，对于二分算法无论是理论研究还是实际运用都已经很纯熟了，我们既然可以站在巨人的肩膀上，那又何乐而不为呢？ 这里总结一下一些常用的二分算法的写法。 一、二分查找 查找序…&lt;/p&gt;</summary>


    <category term="算法与数据结构" scheme="https://www.lightdream.xyz/categories/%E7%AE%97%E6%B3%95%E4%B8%8E%E6%95%B0%E6%8D%AE%E7%BB%93%E6%9E%84/"/>
    
    
    <category term="二分应用拓展" scheme="https://www.lightdream.xyz/tags/%E4%BA%8C%E5%88%86%E5%BA%94%E7%94%A8%E6%8B%93%E5%B1%95/"/>
    
    <category term="二分查找" scheme="https://www.lightdream.xyz/tags/%E4%BA%8C%E5%88%86%E6%9F%A5%E6%89%BE/"/>
    
  </entry>
  
  <entry>
    <title>6-11 求自定类型元素序列的中位数</title>
    <link href="https://www.lightdream.xyz/FindMiddleNumber.html"/>
    <id>https://www.lightdream.xyz/FindMiddleNumber.html</id>
    <published>2019-01-21T17:33:16.000Z</published>
    <updated>2020-02-28T01:11:04.275Z</updated>
    
    <content type="html"><![CDATA[<p>一道题把排序算法复习了个遍😂，最终复习到了堆排序。快到碗里来👇。  </p><h3 id="题面"><a href="#题面" class="headerlink" title="题面"></a>题面</h3><p><a href="https://pintia.cn/problem-sets/14/problems/743">原题链接</a>(要不先去做一下？😏)，题面如下，</p><blockquote><p>本题要求实现一个函数，求N个集合元素A[]的中位数，即序列中第⌊N&#x2F;2+1⌋大的元素。其中集合元素的类型为自定义的ElementType。<br>函数接口定义：<br>ElementType Median( ElementType A[], int N );<br>其中给定集合元素存放在数组A[]中，正整数N是数组元素个数。该函数须返回N个A[]元素的中位数，其值也必须是ElementType类型。<br>裁判测试程序样例：</p><pre><code>#include &lt;stdio.h&gt;#define MAXN 10typedef float ElementType;ElementType Median( ElementType A[], int N );int main ()&#123;    ElementType A[MAXN];    int N, i;    scanf(&quot;%d&quot;, &amp;N);    for ( i=0; i&lt;N; i++ )        scanf(&quot;%f&quot;, &amp;A[i]);    printf(&quot;%.2f\n&quot;, Median(A, N));    return 0;&#125;/* 你的代码将被嵌在这里 */输入样例：312.3 34 -5输出样例：12.30</code></pre></blockquote><h3 id="分析"><a href="#分析" class="headerlink" title="分析"></a>分析</h3><p>　　首先，因为题目给定中位数位置为<strong>序列中第⌊N&#x2F;2+1⌋大</strong>，所以不用考虑序列长度为奇为偶。<br>　　其次，因为涉及到排序，而又不能直接调用库里面的排序算法，so,就自己手写排序代码。</p><ul><li><p>第一次尝试冒泡排序😀，最后一组数据，大N超时🤔  </p><center><img src="image/buddy.png" width="545" height="200"/></center><blockquote><p>(PS:强迫症表示很难受。)</p></blockquote></li><li><p>第二次快速排序，结果如上上上，给的数据是反快速排序的😓</p></li><li><p>第三次堆排序，AC😉😆<br>**具体代码请转移至我的<a href="https://github.com/lightingmoon/BlogResourceCode/tree/master/%E6%B1%82%E8%87%AA%E5%AE%9A%E7%B1%BB%E5%9E%8B%E5%85%83%E7%B4%A0%E5%BA%8F%E5%88%97%E7%9A%84%E4%B8%AD%E4%BD%8D%E6%95%B0">Github</a>**。</p></li></ul><hr><h3 id="下面复习-反正review和preview有个p的区别😏-一下堆排序"><a href="#下面复习-反正review和preview有个p的区别😏-一下堆排序" class="headerlink" title="下面复习(反正review和preview有个p的区别😏)一下堆排序"></a>下面复习(反正review和preview有个p的区别😏)一下堆排序</h3><p>　　堆是一种数据结构，它是一颗<a href="https://baike.baidu.com/item/%E5%AE%8C%E5%85%A8%E4%BA%8C%E5%8F%89%E6%A0%91/7773232?fr=aladdin">完全二叉树</a>，并且具备以下性质:</p><ul><li>每个节点的值都大于或等于其左右子节点，称为大顶堆;</li><li>每个节点的值都小于或等于其左右子节点，称为小顶堆。</li></ul><hr><h4 id="比如小顶堆"><a href="#比如小顶堆" class="headerlink" title="比如小顶堆"></a>比如小顶堆</h4><center><img src="image/lessHeap.svg" width="400" height="320"/></center>  <p>将之映射成数组V，有如下:</p><center><img src="image/mapVector.svg" width="400" height="100"/></center>  <p>则对于数组有，索引为i的节点：<br>$ V[i]\leq V[2 \ast i+1]且 V[i] \leq V[2 \ast i+2]$ <strong>(1)</strong>(对于小顶堆)</p><hr><p>堆排序算法描述如下:</p><ol><li>将无序序列构造成小顶堆(最终数组为非严格降序排列，大顶堆反之)，如上图。<ul><li>具体构造过程如下:</li><li>对每个根节点进行判定，如果其不满足小顶堆定义，则交换元素，直至满足**$(1)$**</li></ul></li><li>将第一个元素与最后一个元素交换，将最小元素下沉到数组最后，调整堆结构，使其满足定义。</li><li>反复执行2过程，直到数组有序。</li></ol><h4 id="代码实现"><a href="#代码实现" class="headerlink" title="代码实现"></a>代码实现</h4><p>C++代码实现：</p><pre><code>void HeapAdjust(ElementType A[], int x, int len)&#123;    ElementType temp = A[x];        // 保存根节点x    // 从x节点的左子节点开始    for(int j = 2 * x + 1; j &lt; len; j = 2 * j + 1)        &#123;        if(j + 1 &lt; len &amp;&amp; A[j] &gt; A[j + 1])    // ，滑向值小的节点            j++;        if(temp &lt; A[j])            // 如果当前根节点小于子节点，则跳出循环            break;        A[x] = A[j];            // 子节点覆盖根节点        x = j;                    // 此时子节点j变成根节点    &#125;    A[x] = temp;                // 将x节点放在最终位置&#125;ElementType HeapSort( ElementType A[], int N )&#123;    // 构建初始堆，从第一个非叶子节点自底向上调整堆    for(int i = N / 2 - 1; i &gt;= 0; i--)    &#123;        HeapAdjust(A, i, N);    &#125;    // 堆调整、交换元素    for(int i = N - 1; i &gt; 0; i--)    &#123;        // 元素下沉操作            ElementType temp = A[0];        A[0] = A[i];        A[i] = temp;        // 调整整个堆        HeapAdjust(A, 0, i);    &#125;&#125;</code></pre><h4 id="时间复杂度"><a href="#时间复杂度" class="headerlink" title="时间复杂度"></a>时间复杂度</h4><h5 id="初始化堆"><a href="#初始化堆" class="headerlink" title="初始化堆"></a>初始化堆</h5><p>　　因为初始化堆是自底向上的，从最后一个非叶子节点开始调整堆(叶子节点不用调整😅)。可证明完全二叉树的最后一个非叶子节点的编号为$n&#x2F;2-1$（$n$表示堆的元素总数量），这样从下至上，从右至左调整堆。<br>假设在第i层，二叉树高度为K,该层的节点数为**$2^{i-1}$<strong>,调整该层需要的比较次数为</strong>$k-i$**,<br>最后一个非叶子节点所在层数为$k-1$,则i的区间为$[1,k-1]$,每一层的比较次数:</p><p>$$s&#x3D;2^{i-1}*(k-i)$$</p><p>所以初始化堆总的比较次数为：</p><p>$$　①　 S &#x3D; \sum_{i&#x3D;1}^{k-1}2^{i-1}\ast(k-i)$$</p><p>该等式两边$\ast$2，得：</p><p>$$　②　 2*S &#x3D; \sum_{i&#x3D;1}^{k-1}2^{i}\ast(k-i)$$</p><p>上两式$②　　-　①$ 得：</p><p>$$S &#x3D; \sum_{i&#x3D;1}^{k-1}2^{i} - (k-1)$$</p><p>由等比数列公式$\frac{a_{1}(q^{n}-1)}{q-1}$得</p><p>$$S &#x3D; 2^{k}-k-1$$</p><p>k为二叉树的高度，$k&#x3D;logn,2^{k}&#x3D;2^{logn}&#x3D;n$(对数恒等式),得到$S&#x3D;n-logn-1$，所以初始化堆的时间复杂度为**$O(n)$**</p><h5 id="调整堆"><a href="#调整堆" class="headerlink" title="调整堆"></a>调整堆</h5><p>　　下沉元素时，每一次调整堆都是从根节点调整的，也就是从第1层到k-1层，比较次数$log(i)$,而一共要进行n-1次，所以总的比较次数$(n-1)logn$(可以参考一下<a href="https://www.programiz.com/dsa/heap-sort">https://www.programiz.com/dsa/heap-sort</a>)，即$nlogn-logn$。所以调整堆的时间复杂度为**$O(nlogn)$**</p><h4 id="空间复杂度"><a href="#空间复杂度" class="headerlink" title="空间复杂度"></a>空间复杂度</h4><p>　　作为原地排序(原地排序指在排序过程中不申请多余的存储空间，只利用原来存储待排数据的存储空间进行比较和交换的数据排序)的一员，其空间复杂度为$O(1)$。</p>]]></content>
    
    
    <summary type="html">&lt;p&gt;一道题把排序算法复习了个遍😂，最终复习到了堆排序。快到碗里来👇。 题面 原题链接 (要不先去做一下？😏)，题面如下， 本题要求实现一个函数，求N个集合元素A[]的中位数，即序列中第⌊N&amp;#x2F;2+1⌋大的元素。其中集合元素的类型为自定义的ElementType。 函数接口定义： ElementType Median( ElementType A[]…&lt;/p&gt;</summary>


    <category term="PAT" scheme="https://www.lightdream.xyz/categories/PAT/"/>
    
    
    <category term="PAT" scheme="https://www.lightdream.xyz/tags/PAT/"/>
    
    <category term="堆排序" scheme="https://www.lightdream.xyz/tags/%E5%A0%86%E6%8E%92%E5%BA%8F/"/>
    
    <category term="算法与数据结构" scheme="https://www.lightdream.xyz/tags/%E7%AE%97%E6%B3%95%E4%B8%8E%E6%95%B0%E6%8D%AE%E7%BB%93%E6%9E%84/"/>
    
  </entry>
  
  <entry>
    <title>用遗传算法解决一个简单问题</title>
    <link href="https://www.lightdream.xyz/GeneticAlgorithm.html"/>
    <id>https://www.lightdream.xyz/GeneticAlgorithm.html</id>
    <published>2019-01-10T20:33:08.000Z</published>
    <updated>2020-06-22T06:20:32.506Z</updated>
    
    <content type="html"><![CDATA[<p>学习算法，就我看来，其实就是学习解决问题的一种思想或者方法，应该是一种体验过程的学习，在过程中感悟与升华，最终把它吸收转化成自己的独特的思想；在学习中感受与惊叹先贤的解决问题的思想，未尝不是一种乐趣?这不也昭示了学习本身就是快乐的过程吗？如果连学习都体验不到快乐，那还有什么能体验到快乐呢？<br>　　本文是可以作为遗传算法介绍性文章，是关于一次简单、浅显的利用遗传算法来解决函数优化问题的介绍性文章。  </p><h1 id="要解决的问题"><a href="#要解决的问题" class="headerlink" title="要解决的问题"></a>要解决的问题</h1><blockquote><p>求解函数 $f(x)&#x3D;x*sin(10\pi +x)+1.0$ 在区间$[-1，2]$的最大值。</p></blockquote><h1 id="知识准备"><a href="#知识准备" class="headerlink" title="知识准备"></a>知识准备</h1><p>　　首先列举一下遗传算法的构成要素</p><h3 id="1-染色体的编码以及编码方法"><a href="#1-染色体的编码以及编码方法" class="headerlink" title="1.染色体的编码以及编码方法"></a>1.染色体的编码以及编码方法</h3><p>　　我们要把问题的解空间进行编码，以便于遗传算法能进行操作。编码方式主要有二进制编码，浮点数编码，格雷码等。</p><h5 id="二进制编码"><a href="#二进制编码" class="headerlink" title="二进制编码"></a>二进制编码</h5><p>　　假设参数范围为$[A,B] (A&lt;B)$,我们有长度为a的二进制串来编码，则共有$2^a$种不同编码，可以将$[A,B]$分成$2^a-1$份，等分长度为$α$，</p><hr><center><img src="image/example.png" width="300" height="200"/></center><hr><p>因为当二进制串长度过长时会影响遗传算法的运行效率，所以这类问题就要重新考虑编码方式了。</p><h5 id="浮点数编码"><a href="#浮点数编码" class="headerlink" title="浮点数编码"></a>浮点数编码</h5><p>　　对于函数优化问题，例如本题，浮点数编码则更合适了。浮点数编码就是用在一定范围内的浮点数表示每个个体的染色体。</p><h5 id="格雷码"><a href="#格雷码" class="headerlink" title="格雷码"></a>格雷码</h5><p>　　其是一种绝对编码的格式，是具有反射特性和循环特性的单步自补码。这些特性保证了它不会出现重大错误。因为它的每次变化都只有相邻两位发生变化，即每次变化与上一次都只有一位不相同。而自然二进制串在向高位进位时却<strong>至少有$1$位不同</strong>。相比于改变多位，明显格雷码的改变一位更稳定些，且出错几率也更小些。其构造方法：</p><hr><p>以二进制$0$为第$0$项，第$1$项改变最右边的位，第二项改变右起第一位非$0$的位的左边那一位，第三项改变最右边的位…如此反复，即可得到$n$位的Gray code.</p><hr><h3 id="2-群体初始化以及计算个体适应度"><a href="#2-群体初始化以及计算个体适应度" class="headerlink" title="2.群体初始化以及计算个体适应度"></a>2.群体初始化以及计算个体适应度</h3><p>　　适应度函数是评估个体的适应性的唯一标准，也是后面选择个体阶段的唯一标准。对于很多问题可以直接将目标函数作为适应度函数。遗传算法的目标函数不受连续可微的约束且定义域可以是任意集合。但对适应度函数有一个要求：针对输入可以计算出的、能加以比较的结果，必须是非负的。</p><h3 id="3-遗传算子-操作算子"><a href="#3-遗传算子-操作算子" class="headerlink" title="3.遗传算子(操作算子)"></a>3.遗传算子(操作算子)</h3><h5 id="选择"><a href="#选择" class="headerlink" title="选择"></a>选择</h5><p>　　根据个体的适应度选择进入下一代的个体，个体的适应度越大，则其越有可能被选入下一代。选择机制有轮盘赌方法，最佳个体保存法、期望值方法、排序选择方法、联赛选择方法、排挤方法等。一般都采用轮盘赌方法。下面描述一下轮盘赌算法：</p><hr><p>1.设种群数量为n，先计算出种群内所有个体适应度$f(x_{i})$，<br>再计算出种群总适应度$sum&#x3D;\sum\limits_{i&#x3D;0}^{n-1}f(x_{i})$，<br>个体适应度与种群总适应度的比值得到个体选择概率$\large p(x_{i})&#x3D;\frac{f(x_{i})}{sum}$。<br>积累概率$q_{i}&#x3D;\sum\limits_{j&#x3D;0}^{n-1}p(x_{i})$表示从第一个个体的选择概率累加，累加到某项即为相应染色体的积累概率。<br>2.生成一个随机数$r$，若$r\leq q_{0}$,则选中$0$号染色体;<br>3.若$q_{i-1}&lt;r\le q_{i}(1\leq i&lt;n)$，则$i$号染色体被选中。<br>对于积累概率，如下图先给出个体选中概率:</p><center><img src="image/selectionProb.png" width="300" height="200"/></center>  <p>由图得积累概率:<br>$q(x_{0})&#x3D;0.2$<br>$q(x_{1})&#x3D;0.3$<br>$q(x_{2})&#x3D;0.7$<br>$q(x_{3})&#x3D;1$<br><strong>染色体的选择概率越大，在上面饼图占的比例也就越大，被选入下一代可能性也就越大</strong><br>轮盘赌选择算子在个体较少时，可能会出现不正确的反映个体适应度的选择过程，即适应的高的个体可能被淘汰了。此时就要考虑其他的选择算子。</p><hr><h5 id="交叉"><a href="#交叉" class="headerlink" title="交叉"></a>交叉</h5><p>　　交叉算子即把两个亲代个体的部分结构进行替换重组而生成新子代个体的操作。其两个特点：</p><ul><li>设计的交叉算子必须保证亲代的优良性状能在子代个体中得到遗传和继承。</li><li>交叉算子的设计与问题的编码是相互协调的，即编码-交叉设计。</li><li>对于二进制串编码，交叉算子主要有一点交叉，两点交叉，多点交叉，一致交叉。其中一点交叉的操作如下：</li></ul><table><thead><tr><th>个体</th><th>对应编码</th></tr></thead><tbody><tr><td>$P_{1}$</td><td>01010010</td></tr><tr><td>$P_{2}$</td><td>00101110</td></tr></tbody></table><hr><p>假设从左起第$5$位开始进行一点交叉，得到</p><table><thead><tr><th>个体</th><th>取出的二进制串</th></tr></thead><tbody><tr><td>$P_{1}$</td><td>0010</td></tr><tr><td>$P_{2}$</td><td>1110</td></tr></tbody></table><hr><p>进行一点交叉后得到两个新个体，</p><table><thead><tr><th>个体</th><th>对应编码</th></tr></thead><tbody><tr><td>$P_{1}’$</td><td>00101110</td></tr><tr><td>$P_{2}’$</td><td>01010010</td></tr></tbody></table><p>这样就完成了一次一点交叉运算。</p><ul><li>对于实数编码，主要采用算术交叉算子。假设存在个体$P_{1}$、$P_{2}$，对于它们进行算术交叉后得到新个体$P_{1}’$、$P_{2}’$的运算如下,其中伪随机数$\lambda$$\in$[0,1]：</li></ul><hr><p>$\large P_{1}’&#x3D;\lambda P_{1}+(1-\lambda) P_{2}$<br>$\large P_{2}’&#x3D;(1-\lambda) P_{1}+\lambda P_{2}$</p><hr><h5 id="变异"><a href="#变异" class="headerlink" title="变异"></a>变异</h5><p>引入变异算子有两个目的：</p><ul><li>使遗传算法具备局部搜索能力。当遗传算子通过交叉算子接近最优解领域时，变异算子可以使遗传算法快速向最优解收敛。在这种情况下，变异概率应取较小的值。</li><li>使种群具备较好的群体多样性，防止遗传算法出现未成熟收敛情况。此时，比那一概率应取较大的值。</li></ul><hr><p>1.对于二进制编码，其变异方式为随机的选择某些基因位，对这些基因位进行概率性的翻转变异，即$0$变为$1$,$1$变为$0$。<br>2.对于实数编码，其变异方式为随机变异。使变异个体变量分量加上一个伪随机数，该随机数为均匀分布或高斯分布。<br>变异方式还有逆转变异算子，自适应变异算子等。</p><h5 id="遗传算子的性质"><a href="#遗传算子的性质" class="headerlink" title="遗传算子的性质"></a>遗传算子的性质</h5><p>　　交叉算子具备良好的全局搜索能力，是遗传算法的主要操作算子；变异算子具备局部搜索能力，是遗传算法的辅助操作算子。交叉和变异使遗传算法具备均衡的全局搜索能力和局部搜索能力。</p><h3 id="回到上面的问题，"><a href="#回到上面的问题，" class="headerlink" title="回到上面的问题，"></a>回到上面的问题，</h3><p>　　对于这个问题，我采取浮点数编码，下面是遗传算法的运行参数：</p><pre><code>const double PI = 3.1415927;                 // π#define N 50                                  // 群体规模#define T 100                               // 进化代数#define PC  0.75                              // 参加交配概率#define PM 0.0875                            // 变异概率</code></pre><p><strong>完整实现代码请移至我的<a href="https://github.com/lightingmoon/BlogResourceCode/tree/master/GeneticAlgorithm">Github</a></strong></p><hr><p>　　说一下感想，对于解决问题的范式，无外乎就是从所有可能解决问题的方法中将这个方法找出来，也即搜索。最开始我们有广度搜索和深度搜索，它们都可能在有限时间内搜索到问题的解决方法。但是，它们是盲目搜索，在今天的计算机条件下，一来计算机能表示的状态空间有限，二来其运行速度对一些状态空间稍微大一些的问题，往往要花大量的时间去计算。所以睿智的前人就发明了启发式搜索，通过预先设置一些方法，引导搜索的方向，使它能更快速的进行搜索，得到更满意的答案。根据达尔文进化论，物竞天择，适者生存，不适者淘汰。我们有一种思想叫做类比，既然大自然能淘汰掉不适合生存其中的物种，保留适合的物种，那我们是否可以借鉴这种方式，淘汰掉不合适的搜索路径，留下适合的搜索路径，这样最后得到的就是最佳解决路径了。这就是遗传算法的本质了。这里只是见到了它的冰山一角而已。就当做领略风光了。</p><hr><h4 id="另外，在这里总结一下c语言获取伪随机数方法"><a href="#另外，在这里总结一下c语言获取伪随机数方法" class="headerlink" title="另外，在这里总结一下c语言获取伪随机数方法"></a>另外，在这里总结一下c语言获取伪随机数方法</h4><p>1.先设置伪随机数种子</p><pre><code>srand((int)time(0));</code></pre><p>2.其次，获取随机数，假如要在子函数里生成随机数，则只能在主函数里设置随机数种子。也就是只用在主函数最开始设置一次种子就可以了。<br>下面是获取伪随机数的一般形式：</p><pre><code>rand()%y + x</code></pre><p>表示生成$[x,y+x)$的伪随机整数。<br>如果需要闭区间$[x,y+x]$的话，可以再给y加个1，即</p><pre><code>rand()%(y+1) + x</code></pre>]]></content>
    
    
    <summary type="html">&lt;p&gt;学习算法，就我看来，其实就是学习解决问题的一种思想或者方法，应该是一种体验过程的学习，在过程中感悟与升华，最终把它吸收转化成自己的独特的思想；在学习中感受与惊叹先贤的解决问题的思想，未尝不是一种乐趣?这不也昭示了学习本身就是快乐的过程吗？如果连学习都体验不到快乐，那还有什么能体验到快乐呢？ 本文是可以作为遗传算法介绍性文章，是关于一次简单、浅显的利用遗传算法…&lt;/p&gt;</summary>


    <category term="优化算法" scheme="https://www.lightdream.xyz/categories/%E4%BC%98%E5%8C%96%E7%AE%97%E6%B3%95/"/>
    
    
    <category term="遗传算法" scheme="https://www.lightdream.xyz/tags/%E9%81%97%E4%BC%A0%E7%AE%97%E6%B3%95/"/>
    
  </entry>
  
  <entry>
    <title>页置换算法之LRU(最近最久未使用)</title>
    <link href="https://www.lightdream.xyz/LRUalgorithm.html"/>
    <id>https://www.lightdream.xyz/LRUalgorithm.html</id>
    <published>2018-12-04T05:51:16.000Z</published>
    <updated>2020-04-04T07:22:20.259Z</updated>
    
    <content type="html"><![CDATA[<p>最近在做操作系统上机实验。有一个关于页置换算法的实验，实验所给的代码是先进先出调页算法，一时手痒就想着自己模拟一下LRU调页算法，就作为一个小开始吧。  </p><h3 id="1-关于LRU算法"><a href="#1-关于LRU算法" class="headerlink" title="1.关于LRU算法"></a>1.关于LRU算法</h3><p>　　算法步骤描述如下:</p><ol><li>为所有的页添加一个计数器并置0。</li><li>若系统访问的页存在于内存中，为该页的计数器加一，并对内存中所有的页按计数器大小降序排列；否则执行第三步。</li><li>判断系统内存页数是否已满，是则将内存中排序最后一页置换为系统访问的页，并为该页初始化计数器；否则将系统访问的页加入内存，并初始化计数器。</li></ol><h3 id="2-关于数据结构"><a href="#2-关于数据结构" class="headerlink" title="2.关于数据结构"></a>2.关于数据结构</h3><p>　　1. 页类型可用如下结构体表示</p><pre><code class="lang-C++">struct page&#123;    int pageNum = -1;    // 系统访问页码,默认-1为空    int time = 0;       // 系统在内存访问总次数，默认为0次    page() &#123;&#125;                                       // 空无参构造    page(const int p): pageNum(p) &#123;&#125;                // 构造函数    friend bool operator&lt;(page &amp;p1, page &amp;p2)       // 排序比较器    &#123;        return p1.time &lt; p2.time;    &#125;&#125;;</code></pre><p>　　2. 可用一个最大空间为3的vector模拟内存</p><pre><code class="lang-C++">#define CAPACITY 3std::vector&lt;pageNode&gt; mainMem;</code></pre><h3 id="3-调页函数"><a href="#3-调页函数" class="headerlink" title="3.调页函数"></a>3.调页函数</h3><pre><code class="lang-c++">void foldPage(int page, std::vector&lt;pageNode&gt; &amp;mainMem)&#123;    if(CAPACITY == mainMem.size())              /* 内存存放的页满,置换最后一页*/    &#123;        mainMem.back().pageNum = page;        mainMem.back().time = 0;    &#125;    else    &#123;        mainMem.emplace_back(page);             /* emplace_back()直接调用其构造函数，并加在vector最后。*/    &#125;&#125;</code></pre><h3 id="测试结果"><a href="#测试结果" class="headerlink" title="测试结果"></a>测试结果</h3><pre><code class="lang-html">模拟访问页面走向4, 3, 2, 1, 4, 3, 5, 4, 3, 2, 1, 5, 1, 4, 3-------------------------------------时间  访问页   内存状态  缺页中断 调入页0        1       4        4           +      42       3        4 3         +      33       2        4 3 2       +      24       1        4 3 1       +      15       4        4 3 16       3        4 3 17       5        4 3 5       +      58       4        4 3 59       3        4 3 510      2        4 3 2       +      211      1        4 3 1       +      112      5        4 3 5       +      513      1        4 3 1       +      114      4        4 3 115      3        4 3 1缺页中断次数为9缺页率9/15=60.00%%</code></pre><h3 id="完整测试代码见我的Github。"><a href="#完整测试代码见我的Github。" class="headerlink" title="完整测试代码见我的Github。"></a>完整测试代码见我的<a href="https://github.com/lightingmoon">Github</a>。</h3><p>————————————————————————————————————————————————我是分割线——————————————————————————-<br><strong>更新于2020.2.28</strong></p><h2 id="上面的构想还是学生时代初期的构想，太过于理想化，只考虑到了模拟，其它一概不考虑。真是一颗傲娇的心。"><a href="#上面的构想还是学生时代初期的构想，太过于理想化，只考虑到了模拟，其它一概不考虑。真是一颗傲娇的心。" class="headerlink" title="上面的构想还是学生时代初期的构想，太过于理想化，只考虑到了模拟，其它一概不考虑。真是一颗傲娇的心。"></a>上面的构想还是学生时代初期的构想，太过于理想化，只考虑到了模拟，其它一概不考虑。真是一颗傲娇的心。</h2><p>最近在<a href="https://leetcode-cn.com/problems/lru-cache/solution/lru-ce-lue-xiang-jie-he-shi-xian-by-labuladong/">LeetCode</a>上刷题，遇到了一道关于设计实现LRU算法的题，才发现当年写的LRU算法真是只有当年才能写出来。<br>　　真正在页置换算法应用实现中是根本不会为页设置访问次数属性并由该属性进行排序的，这效率低且浪费内存。光时间复杂度就高达O(nlogn)，更别提空间复杂度了。<br>下面开始分析优化：<br>　　在页置换算法中，没有必要对工作集内的页进行按访问次数排序，从而得到最近最少访问次数。而是因为我们只要求得到最近最少访问的页，只用<strong>将经常访问的页放到页表首部</strong>，则每次都能以O(1)的时间复杂度访问；而当调入新的页时，若OS为进程分配的页帧已用完，采用LRU算法，应删除最近最少访问的页，也就是页表尾部页；若页帧没有用完，则直接将新页加入到页表首部。这里这样描述是因为这个LRU算法实现基本就是这个思想。<br><strong>由以上，要以O(1)删除尾部元素，以O(1)插入元素到表首，以O(1)查找某元素(hash)，且有顺序(list)。综上分析，形成了新的数据结构——哈希链表。</strong><br>　　当时在LeetCode上接触这道题时，感觉思维被打乱了，甚至没读懂题意。后来看了题解才恍然大悟。也触摸到了分析这种题的一些诀窍。下面是cpp代码：</p><pre><code class="lang-c++">#include&lt;iostream&gt;#include&lt;list&gt;#include&lt;unordered_map&gt;using namespace std;// 哈希链表class LRUCache&#123;public:    LRUCache(int capacity):_capacity(capacity) &#123;&#125;    int get(int key)    &#123;        auto it = mp.find(key);                 // C++11中迭代器类似于指针        if(it == mp.end())            return -1;        int val = it-&gt;second-&gt;second;           // 取出key对应的value        cache.erase(it-&gt;second);                //从cache中删除k-v        cache.push_front(make_pair(key,val));   // 重新构造k-v放入cache头        mp[key] = cache.begin();                // 更新该key hash映射的迭代器        return val;    &#125;    void put(int key, int value)    &#123;        auto it = mp.find(key);        if(mp.end() == it)                      // k-v不存在        &#123;            if(cache.size() == _capacity)       // cache 已满，删除尾部，清理出空间            &#123;                auto temp = cache.back();                cache.pop_back();                mp.erase(temp.first);           // 删除尾部的key在hash中对应的结点            &#125;        &#125;        else   cache.erase(mp[key]);            // k-v存在,更新value,并放入cache头        cache.push_front(make_pair(key,value)); // 将结点直接加入头部        mp[key] = cache.begin();                // 更新该key对应的迭代器    &#125;private:    unsigned int _capacity;    list&lt;pair&lt;int,int&gt;&gt; cache;                  // 模拟cache双链表    unordered_map&lt;int,list&lt;pair&lt;int,int&gt;&gt;::iterator&gt; mp;    // hash表&#125;;int main()&#123;    LRUCache cache(2);    cache.put(1, 1);    cache.put(2, 2);    cout&lt;&lt;cache.get(1)&lt;&lt;endl;       // 返回  1    cache.put(3, 3);    // 该操作会使得密钥 2 作废    cout&lt;&lt;cache.get(2)&lt;&lt;endl;       // 返回 -1 (未找到)    cache.put(4, 4);    // 该操作会使得密钥 1 作废    cout&lt;&lt;cache.get(1)&lt;&lt;endl;       // 返回 -1 (未找到)    cout&lt;&lt;cache.get(3)&lt;&lt;endl;       // 返回  3    cout&lt;&lt;cache.get(4)&lt;&lt;endl;       // 返回  4    return 0;&#125;</code></pre>]]></content>
    
    
    <summary type="html">&lt;p&gt;最近在做操作系统上机实验。有一个关于页置换算法的实验，实验所给的代码是先进先出调页算法，一时手痒就想着自己模拟一下LRU调页算法，就作为一个小开始吧。 1.关于LRU算法 算法步骤描述如下: 为所有的页添加一个计数器并置0。 若系统访问的页存在于内存中，为该页的计数器加一，并对内存中所有的页按计数器大小降序排列；否则执行第三步。 判断系统内存页数是否已满，是…&lt;/p&gt;</summary>


    <category term="操作系统" scheme="https://www.lightdream.xyz/categories/%E6%93%8D%E4%BD%9C%E7%B3%BB%E7%BB%9F/"/>
    
    
    <category term="LRU" scheme="https://www.lightdream.xyz/tags/LRU/"/>
    
    <category term="页置换算法" scheme="https://www.lightdream.xyz/tags/%E9%A1%B5%E7%BD%AE%E6%8D%A2%E7%AE%97%E6%B3%95/"/>
    
  </entry>
  
  <entry>
    <title>致你我</title>
    <link href="https://www.lightdream.xyz/BehaveMyself.html"/>
    <id>https://www.lightdream.xyz/BehaveMyself.html</id>
    <published>2018-11-20T07:23:23.000Z</published>
    <updated>2026-08-23T02:58:55.231Z</updated>
    
    <content type="html"><![CDATA[<p>这是一篇加密文章，内容只适合一个人的时候自己看😃，想要一起看的话联系我！</p><span id="more"></span><blockquote><p>恢复说明:原博文为加密文章(hexo-blog-encrypt),加密后的完整页面已妥存于 <code>recovery\encrypted-posts\BehaveMyself.html</code>,找回密码后可恢复为可解密博文。</p></blockquote>]]></content>
    
    
    <summary type="html">&lt;p&gt;这是一篇加密文章，内容只适合一个人的时候自己看😃，想要一起看的话联系我！&lt;/p&gt;</summary>


    <category term="静夜思" scheme="https://www.lightdream.xyz/categories/%E9%9D%99%E5%A4%9C%E6%80%9D/"/>
    
    
    <category term="静夜思" scheme="https://www.lightdream.xyz/tags/%E9%9D%99%E5%A4%9C%E6%80%9D/"/>
    
  </entry>
  
  <entry>
    <title>第14次CSP认证考试总结</title>
    <link href="https://www.lightdream.xyz/TheReflectionof14thCSP.html"/>
    <id>https://www.lightdream.xyz/TheReflectionof14thCSP.html</id>
    <published>2018-10-27T06:58:20.000Z</published>
    <updated>2020-05-24T22:11:38.366Z</updated>
    
    <content type="html"><![CDATA[<p>学而不思则罔，思而不学则殆。不会反思自己的人思想总是不会太深刻，而太过沉溺于幻想之中只会徒增失落。低头前进，全凭一身锐气，不撞南墙不回头；不如与知音进行一次彻夜长谈，回顾过去，展望未来。目极远眺，若许人或在招手。  </p><p>　　回顾整场考试，节奏把握的还是不错的。但其中的三大问题，令人唏嘘：</p><pre><code>* 1.第二题没有仔细分析条件，再加上给的样例，直接将思想带偏到了预定的方向;* 2.第三题题目比较长，在看题的时候没有标注一个重要条件，导致在写代码时将其忽略;* 3.心里没有B Tree，幻想着能在第四，五题得一些分(竟然不是把在一个小时内将4，5题* 　做出来，看来也不是没有B Tree)。</code></pre><h4 id="下面展开进行分析，"><a href="#下面展开进行分析，" class="headerlink" title="下面展开进行分析，"></a>下面展开进行分析，</h4><h3 id="第二题"><a href="#第二题" class="headerlink" title="第二题"></a>第二题</h3><pre><code class="lang-c++">问题描述试题编号：201809-2试题名称：买菜时间限制：1.0s内存限制：256.0MB问题描述：问题描述　　小H和小W来到了一条街上，两人分开买菜，他们买菜的过程可以描述为，    去店里买一些菜然后去旁边的一个广场把菜装上车，两人都要买n种菜，    所以也都要装n次车。具体的，    对于小H来说有n个不相交的时间段[a1,b1],[a2,b2]...[an,bn]在装车，    对于小W来说有n个不相交的时间段[c1,d1],[c2,d2]...[cn,dn]在装车。    其中，一个时间段[s, t]表示的是从时刻s到时刻t这段时间，时长为t-s。　　由于他们是好朋友，他们都在广场上装车的时候会聊天，他们想知道他们可以聊多长时间。输入格式　　输入的第一行包含一个正整数n，表示时间段的数量。　　接下来n行每行两个数ai，bi，描述小H的各个装车的时间段。　　接下来n行每行两个数ci，di，描述小W的各个装车的时间段。输出格式　　输出一行，一个正整数，表示两人可以聊多长时间。样例输入41 35 69 1314 152 45 710 1113 14样例输出3数据规模和约定　　对于所有的评测用例，1 ≤ n ≤ 2000, ai &lt; bi &lt; ai+1，ci &lt; di &lt; ci+1,    对于所有的i(1 ≤ i ≤ n)有，1 ≤ ai, bi, ci, di ≤ 1000000。</code></pre><p>关注数据规模和约定这一句</p><blockquote><p><strong>ai &lt; bi &lt; ai+1，ci &lt; di &lt; ci+1</strong></p></blockquote><p>当时的我处在看完样例之后再看这个条件，而且是在我已经有思路的情况下，于是顺理成章的没有<strong>认认真真、仔仔细细</strong>地再去分析这个条件，按照错误的思路写出了错误的只过了样例的代码，本来还想再造一些样例的，但是此时信心爆棚的我哪还有心思…事后和室友聊了一下，听他用了两个队列做的（我此时心里是带一点慌的），我向他解释我的方法，而且我着重向他介绍我没有<strong>认认真真、仔仔细细</strong>分析过的那个条件。如果没有这个条件，那么我的思路就是错的，但是由于当时没有题面，语言表述又有限，便作罢…过了两天出成绩，<strong>冲动的惩罚</strong>来了——只得了样例的分，而此时的我竟然还没有意识到错误解读条件…看来我还挺偏执…<br><em>所以考试的时候没有仔仔细细的分析条件，那就只能下来分析了，晚矣晚矣~</em></p><blockquote><p><strong>ai &lt; bi &lt; ai+1，ci &lt; di &lt; ci+1</strong></p></blockquote><p>分析一下，也就是数据规格符合逻辑而已，输入的小H、小W休息时间分别不会重叠。满分代码已我放在我的<a href="https://github.com/lightingmoon">Github</a>。</p><h4 id="第三题"><a href="#第三题" class="headerlink" title="第三题"></a>第三题</h4><p>题面比较长，就不搬来了，<a href="http://118.190.20.162/home.page">链接</a>，其中有个条件：id属性大小写不敏感，coding时的确忘了这个条件，得了80分…不得不说运气还挺好…<br>在这里记录一下解决这道题中 <strong>后代选择器</strong>的思路：</p><pre><code>* 第一步，用一个数组记录每一行文档的**层级**(累加每一行文档前面“.”的个数)。* 第二步，将要查询的标签解析分开存在一个vector里，遍历查找vector中每一个标签，* 查找算法步骤如下：    * 第一步，按照解析后的标签的层级从低到高，开始在文档中查找；    * 第二步，每次查找遵循贪心原则，只保存找到的标签的最大的层级数，找到则进    * 行下一步，没找到查找结束；    * 第三步，继续查找下一层标签，但是找到的最大的标签的层数必须是小于上一层    * 找到的标签层数，如是往复。    **题目给的提示绝对是很重要的。贪心，是个好算法。**</code></pre><p>　　一瞬间的失神，可能决定着沧海桑田，望三思而后行。</p>]]></content>
    
    
    <summary type="html">&lt;p&gt;学而不思则罔，思而不学则殆。不会反思自己的人思想总是不会太深刻，而太过沉溺于幻想之中只会徒增失落。低头前进，全凭一身锐气，不撞南墙不回头；不如与知音进行一次彻夜长谈，回顾过去，展望未来。目极远眺，若许人或在招手。 回顾整场考试，节奏把握的还是不错的。但其中的三大问题，令人唏嘘： * 1.第二题没有仔细分析条件，再加上给的样例，直接将思想带偏到了预定的方向; …&lt;/p&gt;</summary>


    <category term="静夜思" scheme="https://www.lightdream.xyz/categories/%E9%9D%99%E5%A4%9C%E6%80%9D/"/>
    
    
    <category term="反思" scheme="https://www.lightdream.xyz/tags/%E5%8F%8D%E6%80%9D/"/>
    
  </entry>
  
  <entry>
    <title>从最少交换次数到交换排序</title>
    <link href="https://www.lightdream.xyz/SwapSort.html"/>
    <id>https://www.lightdream.xyz/SwapSort.html</id>
    <published>2018-10-20T05:31:14.000Z</published>
    <updated>2020-05-24T22:11:30.530Z</updated>
    
    <content type="html"><![CDATA[<p>像往常一样，每周几题。今天这道题**(<a href="https://code.mi.com/problem/list/view?id=8">最少交换次数</a>)**让我做了一次发散性的思考，先把题面搬过来，有收获的小伙伴可以进原题链接练练手。</p><pre><code>最少交换次数序号：#8难度：非常难时间限制：1000ms内存限制：10M描述给出一个无序数列，每次只能交换相邻两个元素，  求将原数列变成递增数列的最少交换次数。   如：数列：2,3,1，交换3和1后变成：2,1,3；交换1和2之后变成：1,2,3。总共交换2次。输入逗号隔开的正整数数列输出正整数输入样例2,3,1输出样例2</code></pre><p>当时看到题面的第一个念头就是用归并排序求<strong>逆序对</strong>(多了解一些准没错)，但是仔细一看题面，只能交换相邻元素，归并排序，pass。转念一想，还有交换(冒泡)排序呀，每次只交换相邻元素，这是完全符合题意要求的。我的代码如下：</p><pre><code class="lang-c++">#include&lt;bits/stdc++.h&gt;#define LARGE_IOusing namespace std;vector&lt;int&gt; split(const string &amp;t)&#123;    vector&lt;int&gt; out;    stringstream tstream(t);    int temp;    while(tstream&gt;&gt;temp)    &#123;        out.push_back(temp);        tstream.ignore(1);    &#125;    return out;&#125;int bubbleSort(vector&lt;int&gt; &amp;p)&#123;    int len = p.size(),cnt=0;    for(int i = 0; i &lt; len - 1; i++)              // 控制趟数    &#123;        for(int j = 1; j &lt; len - i; j++)          // 控制比较元素        &#123;            if(p[j-1] &gt; p[j])            &#123;                swap(p[j-1],p[j]);                // &lt;algorithm&gt;算法库自带                cnt++;            &#125;        &#125;    &#125;    return cnt;&#125;int main()&#123;#ifdef    LARGE_IO    ios::sync_with_stdio(0);#endif    string inputStr;    vector&lt;int&gt; p;    while(getline(cin,inputStr))    &#123;        p = split(inputStr);        cout&lt;&lt;bubbleSort(p)&lt;&lt;endl;    &#125;    return 0;&#125;</code></pre><p>关于冒泡排序，有一个优化：<br>设想一个场景，数组[1,0,2,3,4,5,6,7,8,9]，第一趟只进行了一次有用的比较，数组就有序了，后面的比较都是枉然的。所以考虑加一个flag，只要存在交换，冒泡排序就继续进行下一趟，反之，排序结束。请读者自行完成代码。</p><p>当然，，，，，不可能。</p><pre><code class="lang-C++">int bubbleSort(vector&lt;int&gt; &amp;p)&#123;    int len = p.size(),cnt=0;    bool flag=1;                                // 交换标记    for(int i = 0; i &lt; len - 1&amp;&amp; flag; i++)      // 控制趟数    &#123;        flag = 0;        for(int j = 1; j &lt; len - i; j++)          // 控制比较元素        &#123;            if(p[j-1] &gt; p[j])            &#123;                swap(p[j-1],p[j]);                cnt++;                flag = 1;                        // 存在交换置 真            &#125;        &#125;    &#125;    return cnt;&#125;</code></pre><p>总结:</p><pre><code>* 认真仔细看题面。失之毫厘，差之千里。* 先不要急于思考代码的实现这种细节，而是思考算法与数据结构(深度思考)。* 完成后考虑举一反三，一题多解，锻炼发散性思维(广度思考)。</code></pre>]]></content>
    
    
    <summary type="html">&lt;p&gt;像往常一样，每周几题。今天这道题**( 最少交换次数 )**让我做了一次发散性的思考，先把题面搬过来，有收获的小伙伴可以进原题链接练练手。 最少交换次数 序号：#8 难度：非常难 时间限制：1000ms 内存限制：10M 描述 给出一个无序数列，每次只能交换相邻两个元素， 求将原数列变成递增数列的最少交换次数。 如：数列：2,3,1，交换3和1后变成：2,1…&lt;/p&gt;</summary>


    <category term="算法与数据结构" scheme="https://www.lightdream.xyz/categories/%E7%AE%97%E6%B3%95%E4%B8%8E%E6%95%B0%E6%8D%AE%E7%BB%93%E6%9E%84/"/>
    
    
    <category term="交换排序" scheme="https://www.lightdream.xyz/tags/%E4%BA%A4%E6%8D%A2%E6%8E%92%E5%BA%8F/"/>
    
    <category term="冒泡排序" scheme="https://www.lightdream.xyz/tags/%E5%86%92%E6%B3%A1%E6%8E%92%E5%BA%8F/"/>
    
    <category term="排序" scheme="https://www.lightdream.xyz/tags/%E6%8E%92%E5%BA%8F/"/>
    
  </entry>
  
  <entry>
    <title>split函数实现</title>
    <link href="https://www.lightdream.xyz/theConstructofSplit.html"/>
    <id>https://www.lightdream.xyz/theConstructofSplit.html</id>
    <published>2018-10-03T23:48:44.000Z</published>
    <updated>2021-11-17T02:58:44.625Z</updated>
    
    <content type="html"><![CDATA[<p>字符串分割函数split,将一个字符串按给定的定界符delim分割成字符串数组。实现的方式多种多样，由浅入深，从易到难，开始分割…  </p><p>实现的方式有以下3种:</p><ul><li>用cstring 库中的strtok函数实现</li><li>string类对字符串直接处理实现</li><li>正则表达式结合STL实现</li></ul><h2 id="用strtok函数实现"><a href="#用strtok函数实现" class="headerlink" title="用strtok函数实现"></a>用strtok函数实现</h2><pre><code class="lang-c++">std::vector&lt;std::string&gt; split0(const std::string &amp;str, const std::string &amp;deli)&#123;    std::vector&lt;std::string&gt; out;    if(str.empty())    &#123;        return out;    &#125;    if(deli.empty())    &#123;        out.emplace_back(str);        return out;    &#125;    // c_str()返回当前string对象的c 风格常量字符串,即const char *    const char *del=deli.c_str();    // 将str重新放入流中，再用char数组读取    std::stringstream ot(str);    char strTemp[str.size()+1];    ot&gt;&gt;strTemp;    char *p=strtok(strTemp,del);    while(p != nullptr)    &#123;        out.emplace_back(p);        p = strtok(nullptr,del);    &#125;    return out;&#125;</code></pre><h2 id="用string类实现"><a href="#用string类实现" class="headerlink" title="用string类实现"></a>用string类实现</h2><pre><code class="lang-C++">std::vector&lt;std::string&gt; split1(const std::string &amp;str, const std::string &amp;deli)&#123;    std::vector&lt;std::string&gt; out;    if(str.empty())    &#123;        return out;    &#125;    if(deli.empty())    &#123;        out.emplace_back(str);        return out;    &#125;    // 直接处理字符串    std::string p=str;    p+=deli;                                // 保证结尾有一个定界符    size_t cur;                             // 记录处理过的子串    while((cur = p.find(deli)) != std::string ::npos)    &#123;        out.emplace_back(p.substr(0,cur));  // 截取分割子串        p=p.substr(cur+deli.size());        // 向后滑动    &#125;    return out;&#125;</code></pre><h2 id="用std-regex实现"><a href="#用std-regex实现" class="headerlink" title="用std::regex实现"></a>用std::regex实现</h2><pre><code class="lang-c++">std::vector&lt;std::string&gt; split2(const std::string &amp;str, const std::string &amp;deli)&#123;    std::vector&lt;std::string&gt; out;    if(str.empty())    &#123;        return out;    &#125;    if(deli.empty())    &#123;        out.emplace_back(str);        return out;    &#125;    // 构造定界符正则    std::regex re(deli);    // 获取匹配该定界符的串的前缀    std::sregex_token_iterator p(str.begin(), str.end(), re, -1);    std::sregex_token_iterator end;    while (p != end)    &#123;        out.emplace_back(*p++);    &#125;    return out;&#125;</code></pre><p>完整测试代码见我的<a href="https://github.com/lightingmoon">Github</a><br>参考资料:<br><a href="http://www.cplusplus.com/reference/regex/regex_token_iterator/regex_token_iterator/">C++ Reference</a><br><a href="https://www.cnblogs.com/qianlicao/p/9274444.html">几种c++字符串split 函数实现的比较</a></p>]]></content>
    
    
    <summary type="html">&lt;p&gt;字符串分割函数split,将一个字符串按给定的定界符delim分割成字符串数组。实现的方式多种多样，由浅入深，从易到难，开始分割… 实现的方式有以下3种: 用cstring 库中的strtok函数实现 string类对字符串直接处理实现 正则表达式结合STL实现 用strtok函数实现 std::vector&amp;lt;std::string&amp;gt; split…&lt;/p&gt;</summary>


    <category term="Cpp" scheme="https://www.lightdream.xyz/categories/Cpp/"/>
    
    
    <category term="C-11" scheme="https://www.lightdream.xyz/tags/C-11/"/>
    
    <category term="STL" scheme="https://www.lightdream.xyz/tags/STL/"/>
    
    <category term="split函数" scheme="https://www.lightdream.xyz/tags/split%E5%87%BD%E6%95%B0/"/>
    
    <category term="字符串分割" scheme="https://www.lightdream.xyz/tags/%E5%AD%97%E7%AC%A6%E4%B8%B2%E5%88%86%E5%89%B2/"/>
    
  </entry>
  
  <entry>
    <title>C++正则表达式库(std::regex)</title>
    <link href="https://www.lightdream.xyz/C++std-regex.html"/>
    <id>https://www.lightdream.xyz/C++std-regex.html</id>
    <published>2018-10-02T06:28:15.000Z</published>
    <updated>2021-11-17T02:58:01.946Z</updated>
    
    <content type="html"><![CDATA[<p><a href="https://code.mi.com/site/index">小米OJ</a>里的题有一个独特的数据输入方式，迫使我不得不去掌握一些高效处理字符串的方法，从正则开始。  </p><p>知其所以然，请跳转　<a href="https://www.cnblogs.com/longhuihu/p/4128203.html">正则表达式之基本原理</a>。</p><h3 id="std-regex"><a href="#std-regex" class="headerlink" title="std::regex"></a>std::regex</h3><p>　　其常用函数(类)如下</p><ul><li>regex_match() ，全词匹配。</li><li>regex_search()，搜索匹配。</li><li>regex_replace()，搜索匹配并替换。</li><li>std::regex_iterator，不分组多次全词匹配，可获取整个正则结果。</li></ul><h4 id="regex-match（全词匹配）用法"><a href="#regex-match（全词匹配）用法" class="headerlink" title="regex_match（全词匹配）用法"></a>regex_match（全词匹配）用法</h4><pre><code class="lang-c++">#include&lt;iostream&gt;#include&lt;string&gt;#include&lt;regex&gt;using std::cin;using std::cout;using std::endl;int main()&#123;    std::string s(&quot;122  622&quot;);    std::regex e(&quot;(\\d+)(\\s+)(\\d+)&quot;);        // 两边各最少一个数字，中间至少一个空格    // 是否全词匹配成功    if (std::regex_match (s,e))    &#123;        cout &lt;&lt; &quot;the match is successful!&quot;;    &#125;    else    &#123;        cout&lt;&lt;&quot;the match is failed!&quot;&lt;&lt;endl;    &#125;    // 捕获匹配内容    //std::match_results&lt;const char *&gt; cm;    std::cmatch cm;             // 同于std::match_results&lt;const char *&gt;    std::regex_match (s.c_str(),cm,e);    cout &lt;&lt; &quot;string literal with &quot; &lt;&lt; cm.size() &lt;&lt; &quot; matches\n&quot;;    for(auto y:cm)        cout&lt;&lt;&quot;[&quot;&lt;&lt;y&lt;&lt;&quot;]&quot;&lt;&lt;endl;    return 0;&#125;</code></pre><p><strong>注:捕获的结果中，第一条一般都是字符串本身</strong><br>运行结果:</p><pre><code>the match is successful!string literal with 4 matches[122   622][122][   ][622]</code></pre><h4 id="regex-search（搜索匹配）用法"><a href="#regex-search（搜索匹配）用法" class="headerlink" title="regex_search（搜索匹配）用法"></a>regex_search（搜索匹配）用法</h4><pre><code>#include&lt;iostream&gt;#include&lt;string&gt;#include&lt;regex&gt;using std::cin;using std::cout;using std::endl;int main()&#123;    std::string s(&quot;sss666  333ff&quot;);    std::regex e(&quot;(\\d+)(\\s+)(\\d+)&quot;);    // 是否搜索匹配成功    if (std::regex_search(s,e))    &#123;        cout&lt;&lt;&quot;the match is successful!&quot;&lt;&lt;endl;        // 捕获匹配内容        std::cmatch cm;             // 同于std::match_results&lt;const char *&gt;        std::regex_search(s.c_str(),cm,e);        for(auto y:cm)            cout&lt;&lt;&quot;[&quot;&lt;&lt;y&lt;&lt;&quot;]&quot;&lt;&lt;endl;        &#125;    else    &#123;        cout&lt;&lt;&quot;the match is failed!&quot;&lt;&lt;endl;    &#125;    return 0;&#125;</code></pre><p>运行结果:</p><pre><code>the match is successful![666  333][666][  ][333]</code></pre><h4 id="regex-replace（搜索匹配并替换）用法"><a href="#regex-replace（搜索匹配并替换）用法" class="headerlink" title="regex_replace（搜索匹配并替换）用法"></a>regex_replace（搜索匹配并替换）用法</h4><pre><code>#include&lt;iostream&gt;#include&lt;string&gt;#include&lt;regex&gt;using std::cin;using std::cout;using std::endl;int main()&#123;    // Flags used to control how rgx is matched and how fmt is formatted.    std::regex_constants::match_flag_type fonly =        std::regex_constants::format_first_only;    std::string s(&quot;  sss666  333ffF  d32132  &quot;);    // 由一个及以上的空格开始，接下来是1~3个数字或字母的组合    std::regex rgx(&quot;(\\s+[a-z0-9]&#123;1,3&#125;)&quot;);    std::string fmt=&quot;&quot;;    cout&lt;&lt;&quot;flags: &quot;&lt;&lt;std::regex_replace(s,rgx,fmt,fonly)&lt;&lt;endl;    cout&lt;&lt;&quot;default: &quot;&lt;&lt;std::regex_replace(s,rgx,fmt)&lt;&lt;endl;    return 0;&#125;</code></pre><p>运行结果:</p><pre><code>flags: 666  333ffF  d32132default: 666ffF132</code></pre><h4 id="std-regex-iterator-（不分组多次全词匹配）"><a href="#std-regex-iterator-（不分组多次全词匹配）" class="headerlink" title="std::regex_iterator （不分组多次全词匹配）"></a>std::regex_iterator （不分组多次全词匹配）</h4><pre><code>#include&lt;iostream&gt;#include&lt;string&gt;#include&lt;regex&gt;using std::cin;using std::cout;using std::endl;int main()&#123;   std::string s=&quot;31234a,333sss,3435ss.dwa&quot;;    // 匹配以任意符号开始，接下来是一个及以上的数字与2个及以上小写字母的组合    std::regex rgx(&quot;(\\d+[a-z]&#123;2,&#125;)&quot;);    // std::sregex_iterator == std::regex_iterator&lt;std::string::const_iterator&gt;    std::regex_iterator&lt;std::string::const_iterator&gt; cbegin(s.begin(),s.end(),rgx);    std::sregex_iterator cend;    while(cbegin != cend)    &#123;        cout&lt;&lt;cbegin-&gt;str()&lt;&lt;endl;        cbegin++;    &#125;    return 0;&#125;</code></pre><p>运行结果:</p><pre><code>333sss3435ss</code></pre><p>参考资料:<br><a href="http://www.cplusplus.com/reference/regex/">Cplusplus reference</a><br><a href="https://blog.csdn.net/l357630798/article/details/78235307">Cpp标准库之 std::regex 类的使用</a></p>]]></content>
    
    
    <summary type="html">&lt;p&gt;小米OJ 里的题有一个独特的数据输入方式，迫使我不得不去掌握一些高效处理字符串的方法，从正则开始。 知其所以然，请跳转 正则表达式之基本原理 。 std::regex 其常用函数(类)如下 regex_match() ，全词匹配。 regex_search()，搜索匹配。 regex_replace()，搜索匹配并替换。 std::regex_iterato…&lt;/p&gt;</summary>


    <category term="cpp" scheme="https://www.lightdream.xyz/categories/cpp/"/>
    
    
    <category term="C-11" scheme="https://www.lightdream.xyz/tags/C-11/"/>
    
    <category term="regex" scheme="https://www.lightdream.xyz/tags/regex/"/>
    
    <category term="正则表达式" scheme="https://www.lightdream.xyz/tags/%E6%AD%A3%E5%88%99%E8%A1%A8%E8%BE%BE%E5%BC%8F/"/>
    
  </entry>
  
  <entry>
    <title>C++ Win32网络编程</title>
    <link href="https://www.lightdream.xyz/C++SocketTest.html"/>
    <id>https://www.lightdream.xyz/C++SocketTest.html</id>
    <published>2018-09-19T04:33:45.000Z</published>
    <updated>2021-11-17T02:57:54.757Z</updated>
    
    <content type="html"><![CDATA[<p>最近计算机网络课需要我们做一个图片传输程序，在客户端上传输图片至服务器，要求服务器能过滤文件并展示客户端上传的图片，我带着亲爱的”C++”，开着”百度”，开始畅游”网络”，并在这里写下总结。  </p><p>TCP与UDP都是OSI(Open System Interconnection 开放式系统互联)参考模型下第四层——传输层协议，在这里总结一下它们的特点。</p><h2 id="TCP"><a href="#TCP" class="headerlink" title="TCP"></a>TCP</h2><p><strong>TCP</strong>(Transmission Control Protocol 传输控制协议)，是面向连接的。交互双方都建立一个流式套接字，服务器需要等待客户端连接，一旦连接上就立即返回一个新的套接字描述符，通过描述符调用数据传输函数与客户端进行数据的收发。</p><ul><li>优点：可靠、稳定。</li><li>缺点：速度慢、效率低、占用系统资源多、易被攻击。</li><li>适合场景：网络通讯质量要求高的地方。</li></ul><h2 id="UDP"><a href="#UDP" class="headerlink" title="UDP"></a>UDP</h2><p><strong>UDP</strong>(User Datagram Protocol 用户数据报协议)，是面向无连接的。双方建立的都是数据报套接字，服务器与客户端在进行传描数据之前不需要进行连接的申请和建立，可随时向对方发送消息。</p><ul><li>优点：速度快、比TCP稍安全</li><li>缺点：不可靠，不稳定</li><li>使用场合：网络通讯质量要求不高、速度快的场所。</li></ul><h2 id="TCP-IP三次握手"><a href="#TCP-IP三次握手" class="headerlink" title="TCP&#x2F;IP三次握手"></a>TCP&#x2F;IP三次握手</h2><p>这里有一段生动地描述，我摘抄如下:</p><blockquote><p>主机A向主机B发出连接请求数据包：”我想给你发数据，可以吗？”，这是第一次对话；主机B向主机A发送同意连接和要求同步（同步就是两台主机一个在发送，一个在接收，协调工作）的数据包：”可以，你什么时候发？”，这是第二次对话；主机A再发出一个数据包确认主机B的要求同步：”我现在就发，你接着吧！”，这是第三次对话。三次”对话”的目的是使数据包的发送和接收同步，经过三次”对话”之后，主机A才向主机B正式发送数据。</p></blockquote><p>摘自百度百科<a href="https://baike.baidu.com/item/TCP/UDP%E5%8D%8F%E8%AE%AE/7719820">TCP&#x2F;UDP协议</a>。经过这样三次对话，TCP才能建立稳定、可靠的连接，保证发送数据的正确性。  </p><h2 id="C-实现TCP-IP三次握手，并在传输文件后关闭连接"><a href="#C-实现TCP-IP三次握手，并在传输文件后关闭连接" class="headerlink" title="C++实现TCP&#x2F;IP三次握手，并在传输文件后关闭连接"></a>C++实现TCP&#x2F;IP三次握手，并在传输文件后关闭连接</h2><p><strong>运行环境: VS 2017</strong></p><h3 id="服务器端"><a href="#服务器端" class="headerlink" title="服务器端"></a>服务器端</h3><pre><code>#include &quot;pch.h&quot;#include &lt;iostream&gt;#include &lt;WinSock2.h&gt;#include &lt;string&gt;#include &lt;fstream&gt;#define _WINSOCK_DEPRECATED_NO_WARNINGS#pragma comment(lib, &quot;ws2_32.lib&quot;)        // 导入动态链接库SOCKET sockSrv;void RecvFile();int main(int argc, CHAR* argv[])&#123;    WSADATA wsaData;    int port = 8800;    // 加载套接字    if (WSAStartup(MAKEWORD(2, 2), &amp;wsaData) != 0)    &#123;        std::cout&lt;&lt;&quot;加载套接字失败: &quot;&lt;&lt; WSAGetLastError()&lt;&lt;&quot;......\n&quot;;        return 1;    &#125;     sockSrv = socket(AF_INET, SOCK_STREAM, IPPROTO_TCP);    //    TCP/IP协议     // 初始化IP和端口信息    SOCKADDR_IN addrSrv;    addrSrv.sin_family = AF_INET;    addrSrv.sin_port = htons(port);                            // 1024以上的端口号    addrSrv.sin_addr.S_un.S_addr = INADDR_ANY;    // bind()    if (bind(sockSrv, (LPSOCKADDR)&amp;addrSrv, sizeof(SOCKADDR_IN)) == SOCKET_ERROR)    &#123;        std::cout&lt;&lt;&quot;套接字绑定失败：&quot;&lt;&lt; WSAGetLastError()&lt;&lt;&quot;......\n&quot;;        return 1;    &#125;    // listen()    if (listen(sockSrv, 1) == SOCKET_ERROR)    &#123;        std::cout&lt;&lt;&quot;套接字监听失败：&quot;&lt;&lt;WSAGetLastError()&lt;&lt;&quot;......\n&quot;;        return 1;    &#125;    // 客户端信息    SOCKADDR_IN addrClient;    int len = sizeof(SOCKADDR);    // 开始监听    std::cout&lt;&lt;&quot;服务端启动成功......开始监听...\n&quot;;    while (1)    &#123;        // 等待客户请求到来          sockSrv = accept(sockSrv, (SOCKADDR *)&amp;addrClient, &amp;len);        if (sockSrv == SOCKET_ERROR) &#123;            std::cout&lt;&lt;&quot;建立连接失败：&quot;&lt;&lt;WSAGetLastError()&lt;&lt;&quot;......\n&quot;;            break;        &#125;        std::cout&lt;&lt;&quot;与客户端建立连接......IP：&quot;&lt;&lt;inet_ntoa(addrClient.sin_addr)&lt;&lt;std::endl;        std::cout &lt;&lt; &quot;开始接受数据...&quot; &lt;&lt; std::endl;        RecvFile();        std::cout &lt;&lt; &quot;接受完毕&quot; &lt;&lt; std::endl;        // 关闭套接字        closesocket(sockSrv);    &#125;    WSACleanup();    system(&quot;pause&quot;);    return 0;&#125;void RecvFile() &#123;    const int bufferSize = 1024;    char buffer[bufferSize] = &#123; 0 &#125;;    int readLen = 0;    std::string desFileName = &quot;E:\\demo.jpg&quot;;   // 打开我的E盘的一个图片文件    std::ofstream desFile;    desFile.open(desFileName.c_str(), std::ios::binary);    // 以二进制文件方式，不然图片会乱码    do &#123;                            readLen = recv(sockSrv, buffer, bufferSize, 0);        if (readLen == 0)                            // 循环接受文件，直到发送的文件为 EOF        &#123;            break;        &#125;        else        &#123;            desFile.write(buffer, readLen);        &#125;    &#125; while (true);    desFile.close();                    // 莫忘关闭文件&#125;</code></pre><h3 id="客户端"><a href="#客户端" class="headerlink" title="客户端"></a>客户端</h3><pre><code>#include &quot;pch.h&quot;#include &lt;iostream&gt;#include &lt;WinSock2.h&gt;#include &lt;string&gt;#include &lt;fstream&gt;#pragma comment(lib, &quot;ws2_32.lib&quot;)SOCKET sockClient;void SendFile() &#123;    std::streamsize haveSend = 0;    const int bufferSize = 1024;    char buffer[bufferSize] = &#123;0&#125;;    std::streamsize readLen=0;    std::string srcFileName = &quot;E:\\upload\\universe.jpg&quot;;        // 打开E盘的一个图片文件    std::ifstream srcFile;    srcFile.open(srcFileName.c_str(), std::ios::binary);        // 以二进制文件打开    while (!srcFile.eof()) &#123;                                    // 当读到结尾时会多循环一次，以作为发送结束标志        srcFile.read(buffer, bufferSize);        readLen = srcFile.gcount();        send(sockClient, buffer, readLen, 0);        haveSend += readLen;    &#125;    srcFile.close();&#125;int main(int argc, CHAR* argv[])&#123;    WSADATA wsaData;    int port = 8800;    // 加载套接字    if (WSAStartup(MAKEWORD(2, 2), &amp;wsaData) != 0)    &#123;        std::cout &lt;&lt; &quot;加载套接字失败：&quot; &lt;&lt; WSAGetLastError() &lt;&lt; &quot;......&quot;&lt;&lt;std::endl;        system(&quot;pause&quot;);        return 1;    &#125;    // 初始化IP和端口信息    SOCKADDR_IN addrSrv;    addrSrv.sin_family = AF_INET;    addrSrv.sin_port = htons(port);    addrSrv.sin_addr.S_un.S_addr = inet_addr(&quot;127.0.0.1&quot;);    // socket()    sockClient = socket(AF_INET, SOCK_STREAM, IPPROTO_TCP);    if (SOCKET_ERROR == sockClient)     &#123;        std::cout &lt;&lt; &quot;创建套接字失败:&quot; &lt;&lt; WSAGetLastError() &lt;&lt; &quot;......&quot; &lt;&lt; std::endl;        system(&quot;pause&quot;);        return 2;    &#125;    // 向服务器发出连接请求    if (connect(sockClient, (struct sockaddr*)&amp;addrSrv, sizeof(addrSrv)) == INVALID_SOCKET)    &#123;        std::cout &lt;&lt; &quot;连接服务器失败：&quot; &lt;&lt; WSAGetLastError() &lt;&lt; &quot;......&quot; &lt;&lt; std::endl;        system(&quot;pause&quot;);        return 3;    &#125;    else    &#123;        std::cout &lt;&lt; &quot;连接成功!\n\n&quot; &lt;&lt; std::endl;        std::cout &lt;&lt; &quot;开始发送&quot; &lt;&lt; std::endl;        SendFile();        std::cout &lt;&lt; &quot;\n发送成功!&quot; &lt;&lt; std::endl;    &#125;    // 关闭套接字    closesocket(sockClient);    WSACleanup();    system(&quot;pause&quot;);    return 0;&#125;</code></pre><p>考虑在发送图片文件之前，给服务器发送一些该文件的信息，如名称，大小等，这样服务器可以精确的保存图片文件，诸如此类。<br>参考资料:<br><a href="https://www.cnblogs.com/bitor/p/9486892.html">windows环境下使用C++&amp;Socket实现文件传输</a></p>]]></content>
    
    
    <summary type="html">&lt;p&gt;最近计算机网络课需要我们做一个图片传输程序，在客户端上传输图片至服务器，要求服务器能过滤文件并展示客户端上传的图片，我带着亲爱的”C++”，开着”百度”，开始畅游”网络”，并在这里写下总结。 TCP与UDP都是OSI(Open System Interconnection 开放式系统互联)参考模型下第四层——传输层协议，在这里总结一下它们的特点。 TCP T…&lt;/p&gt;</summary>


    <category term="cpp" scheme="https://www.lightdream.xyz/categories/cpp/"/>
    
    
    <category term="C" scheme="https://www.lightdream.xyz/tags/C/"/>
    
    <category term="Socket" scheme="https://www.lightdream.xyz/tags/Socket/"/>
    
  </entry>
  
  <entry>
    <title>二叉搜索树BST</title>
    <link href="https://www.lightdream.xyz/BinarySearchTree.html"/>
    <id>https://www.lightdream.xyz/BinarySearchTree.html</id>
    <published>2018-08-03T03:25:31.254Z</published>
    <updated>2019-02-25T18:54:59.408Z</updated>
    
    <content type="html"><![CDATA[<p>二叉搜索树(Binary Search Tree)又名二叉查找树、二叉排序树，它要么是一棵空树，要么满足以下条件:</p><ul><li><p>若其左子树不为空，则左子树所有节点的值小于根节点的值；</p></li><li><p>若其右子树不为空，则其右子树所有节点值均大于他的根节点的值；</p></li><li><p>其左右子树也为二叉查找树。</p></li></ul><h3 id="一、-特点"><a href="#一、-特点" class="headerlink" title="一、 特点"></a>一、 特点</h3><p>  　　通过中序遍历二叉搜索树可以得到一个有序的序列。另一方面，通过对一个序列构造二叉搜索树可以将其变为有序，构造构造过程即为排序过程。</p><h5 id="优点"><a href="#优点" class="headerlink" title="优点"></a>优点</h5><p>  　　如果BST左右子树的节点数目保持平衡，即所有非叶子节点的左右子树数目差不多，则它的搜索性能堪比二分查找；二分查找应用于以连续内存空间存储且有序的数组，而以树这种数据结构存储时，对于插入节点和删除节点则比数组这种数据结构高效很多，甚至能达到常数时间。</p><h5 id="缺点"><a href="#缺点" class="headerlink" title="缺点"></a>缺点</h5><p>  　　如果构造二叉搜索树时，没有选好根节点那么构造的二叉搜索树可能会成为这个样子，<br>  <center><img src="image/BSTDegenerate.svg" width="240" height="300"/></center></p><p>  这样的结构则完全失去了二叉搜索树的优势。所以要尽量让二叉搜索树保持平衡，关于保持平衡就要涉及平衡二叉搜索树(AVL)，红黑树(RBT)等数据结构，本文先不介绍。</p><h3 id="二、实践"><a href="#二、实践" class="headerlink" title="二、实践"></a>二、实践</h3><p>  　　以一个公司职员管理系统为例，其底层数据结构用二叉搜索树实现，具备增加加节点，删除节点，修改节点，搜索节点基本功能，主要是实践出真知。二叉树的一个节点也为一个职员，其节点类型如下：</p><pre><code>  typedef struct Node  &#123;    struct Node *left = nullptr;            // 左子树指针    struct Node *right = nullptr;            // 右子树指针    string name;                        // 职员姓名    string gender;                        // 职员性别    string num;                            // 节点的关键字，为社保号，唯一    string date;                            // 入职日期    int salary = 0;                        // 薪资    static int total;                        // 静态变量记录公司职员总人数。    Node() &#123;&#125;    Node(string na, string gen, string number, string da, int s)        // 构造方法    &#123;        name.assign(na);        gender.assign(gen);        num.assign(number);        date.assign(da);        salary = s;        total++;                            // 每构造一个对象总数加一    &#125;    ~Node() &#123;&#125;  &#125; Staff;  int Staff::total = 0;</code></pre><p>  下面是增、删、改、查的一些成员函数，分别用递归和非递归实现:</p><h4 id="增加节点"><a href="#增加节点" class="headerlink" title="增加节点"></a>增加节点</h4><p>  　　即二叉搜索树增加节点，逻辑清晰：</p><ol><li>判定二叉搜索树是否为空，是则直接加入新节点。否则执行第二步</li><li>将新节点的关键字与根节点的关键字相比，小于则进入左子树继续比较以寻找叶子节点并加入新节点，大于则进入右子树寻找加入新节点的位置，</li></ol><ul><li><p><strong>递归</strong></p><pre><code>void addStaff(Staff **r, string m[])        // 传递指针的指针，可在任何地方修改指针指向的地址的内容而不用返回被改变的根节点。&#123;   if(nullptr == (*r))                     // 如果二叉搜索树或节点为空，直接添加新节点。       &#123;       *r = new Staff(m, m[1], m[2], m[3], atoi(m[4].c_str()));       cout &lt;&lt; &quot;添加职员成功！&quot; &lt;&lt; endl;       return;   &#125;   if(m[2] &lt; (*r)-&gt;num)            // 关键字值小于根节点的关键字，新节点加在左子树里面   &#123;       addStaff(&amp;(*r)-&gt;left, m);   &#125;   else                            // 关键字值大于根节点的关键字，新节点加在右子树里面   &#123;       addStaff(&amp;(*r)-&gt;right, m);   &#125;&#125;</code></pre></li><li><p><strong>非递归</strong></p><pre><code>void addStaff(Staff **r, string m[])      // 传递指针的指针，可在任何地方修改指针指向的地址的内容而不用返回。&#123;  if(r == nullptr)                    // 二叉搜索树为空，直接加入节点。  &#123;          *r = new Staff(m[0], m[1], m[2], m[3], atoi(m[4].c_str()));      cout&lt;&lt;&quot;添加成功!&quot;&lt;&lt;endl;      return;  &#125;  while(r != nullptr)                  &#123;     if(m[2] &lt; (*r)-&gt;num)            // 新节点关键字小于根节点，进入左子树寻找      &#123;          r = &amp;(*r)-&gt;left;      &#125;      else                            // 进入右子树寻找位置      &#123;          r = &amp;(*r)-&gt;right;      &#125;      if(nullptr == (*r))                      &#123;          *r = new Staff(m[0], m[1], m[2], m[3], atoi(m[4].c_str()));          cout&lt;&lt;&quot;添加成功!&quot;&lt;&lt;endl;          break;      &#125;  &#125;&#125;</code></pre></li></ul><h4 id="删除节点"><a href="#删除节点" class="headerlink" title="删除节点"></a>删除节点</h4><p>  　　删除节点情况稍微复杂一些，考虑一下：</p><ul><li><p>要删除的节点只有左子树或右子树，或都没有：考虑删除的节点只有左子树，直接将其左子树赋给该节点：反之将右子树赋给该节点。如果删除的是叶子节点，则直接删除该节点(亦左子树或右子树都可以赋给它)。</p></li><li><p>要删除的节点既有左子树又有右子树，找出其右子树最小节点数据覆盖被删除的节点信息，并删除该最小节点。</p></li><li><p>递归</p><pre><code>int deleteStaff(Staff *&amp;r,string num)&#123;  if(nullptr == r)        // BST为空  &#123;      return -1;  &#125;  if(r-&gt;num &gt; num)        // 搜索左子树  &#123;      return deleteStaff(r-&gt;left,num);  &#125;  else if(r-&gt;num &lt; num)   // 搜索右子树  &#123;      return deleteStaff(r-&gt;right,num);  &#125;  else  &#123;      if(r-&gt;left == nullptr || r-&gt;right == nullptr)       // 删除的节点只有左子树或右子树      &#123;          r = (r-&gt;left != nullptr)?r-&gt;left:r-&gt;right;          return 1;      &#125;      else      &#123;          Staff *temp = r-&gt;right;      // 从右子树找一个最小节点并用它来代替被删除的节点，再删除该最小节点。          while(temp-&gt;left != nullptr)          &#123;              temp = temp-&gt;left;          &#125;          // 覆盖信息          r-&gt;name = temp-&gt;name;          r-&gt;gender = temp-&gt;gender;          r-&gt;num = temp-&gt;num;          r-&gt;date = temp-&gt;date;          r-&gt;salary = temp-&gt;salary;          // 删除最小节点          deleteStaff(r-&gt;right,temp-&gt;num);          return 1;      &#125;  &#125;  return -1;&#125;</code></pre></li></ul><h4 id="修改节点和查询节点"><a href="#修改节点和查询节点" class="headerlink" title="修改节点和查询节点"></a>修改节点和查询节点</h4><p>  　　其原理和遍历二叉搜索树相似，直接介绍递归与非递归的中序遍历。</p><h4 id="中序遍历二叉搜索树"><a href="#中序遍历二叉搜索树" class="headerlink" title="中序遍历二叉搜索树"></a>中序遍历二叉搜索树</h4><ul><li><p>递归</p><pre><code>void inOrderTraverse(Staff *r )      // 中序遍历BST&#123;       if(r == nullptr)      &#123;          return;      &#125;  if(r != nullptr)   &#123;          // 递归中序遍历BST      inOrderTraverse(r-&gt;left);      cout &lt;&lt; r-&gt;name &lt;&lt; &quot;\t&quot; &lt;&lt; r-&gt;gender &lt;&lt; &quot;\t&quot; &lt;&lt; r-&gt;num &lt;&lt; &quot;\t&quot; &lt;&lt; r-&gt;date &lt;&lt; &quot;\t&quot; &lt;&lt; r-&gt;salary &lt;&lt; endl;      inOrderTraverse(r-&gt;right);      &#125;&#125;</code></pre></li><li><p>非递归</p><pre><code>void inOrderTraverse(Staff *r )      //非递归 中序遍历BST&#123;    if(r == nullptr)  &#123;          return;  &#125;  stack&lt;Staff*&gt; s;  Staff *p=r;  while(p != nullptr || !s.empty())   // 到叶子节点或栈空  &#123;      while(p != nullptr)                // 先放入相对根节点，次放其左子树，直到左子树空      &#123;          s.push(p);          p = p-&gt;left;      &#125;                              if(!s.empty())                    // 访问节点：左、根、右      &#123;          p = s.top();          cout &lt;&lt; p-&gt;name &lt;&lt; &quot;\t&quot; &lt;&lt; p-&gt;gender &lt;&lt; &quot;\t&quot; &lt;&lt; p-&gt;num &lt;&lt; &quot;\t&quot; &lt;&lt; p-&gt;date &lt;&lt; &quot;\t&quot; &lt;&lt; p-&gt;salary &lt;&lt; endl;           s.pop();          p = p-&gt;right;      &#125;  &#125;&#125;</code></pre><p>完整职员管理系统请转移至<a href="https://github.com/lightingmoon/">我的Github</a>。如果有错误，万望能帮我指出来，不胜感激。</p></li></ul>]]></content>
    
    
    <summary type="html">&lt;p&gt;二叉搜索树(Binary Search Tree)又名二叉查找树、二叉排序树，它要么是一棵空树，要么满足以下条件: 若其左子树不为空，则左子树所有节点的值小于根节点的值； 若其右子树不为空，则其右子树所有节点值均大于他的根节点的值； 其左右子树也为二叉查找树。 一、 特点 通过中序遍历二叉搜索树可以得到一个有序的序列。另一方面，通过对一个序列构造二叉搜索树可…&lt;/p&gt;</summary>


    <category term="算法与数据结构" scheme="https://www.lightdream.xyz/categories/%E7%AE%97%E6%B3%95%E4%B8%8E%E6%95%B0%E6%8D%AE%E7%BB%93%E6%9E%84/"/>
    
    
    <category term="BST" scheme="https://www.lightdream.xyz/tags/BST/"/>
    
    <category term="二叉搜索树" scheme="https://www.lightdream.xyz/tags/%E4%BA%8C%E5%8F%89%E6%90%9C%E7%B4%A2%E6%A0%91/"/>
    
  </entry>
  
  <entry>
    <title>并查集入门</title>
    <link href="https://www.lightdream.xyz/unionFindSet.html"/>
    <id>https://www.lightdream.xyz/unionFindSet.html</id>
    <published>2018-07-30T22:43:38.174Z</published>
    <updated>2020-05-24T22:11:43.582Z</updated>
    
    <content type="html"><![CDATA[<p>在《算法基础》书中，<strong>并查集</strong>又被称为<strong>不相交集结构</strong>：假设有1到N个对象，希望将这些对象分成不相交的集合，在任意给定时间里，每个对象都恰好在一个集合里。对于每个集合，选择一个成员作为集合的标签。例如决定用最小的对象作为标签，可以用”集合2”来表示集合{2,5,7,10}。 抽象结束。  </p><p>作为一个受益者，我强烈建议先看这篇　<strong><a href="https://blog.csdn.net/niushuai666/article/details/6662911">超有爱的并查集~</a></strong> 。　虽不能说是后无来者，但绝对是前无古人，能将知识讲得如此活泼有趣，清晰透彻。望洋兴叹，心向往之。所以在这里只谈一些总结。<br>先看题，<a href="https://pintia.cn/problem-sets/994805046380707840/problems/994805117167976448">原题链接</a></p><hr><pre><code>当芸芸众生忙着在朋友圈中发照片的时候，总有一些人因为太帅而没有朋友。  本题就要求你找出那些帅到没有朋友的人。  输入格式：  输入第一行给出一个正整数N（≤100），是已知朋友圈的个数；  随后N行，每行首先给出一个正整数K（≤1000）,  为朋友圈中的人数，  然后列出一个朋友圈内的所有人——为方便起见，  每人对应一个ID号，为5位数字  （从00000到99999），ID间以空格分隔；  之后给出一个正整数M（≤10000），为待查询的人数；  随后一行中列出M个待查询的ID，以空格分隔。  注意：没有朋友的人可以是根本没安装“朋友圈”，  也可以是只有自己一个人在朋友圈的人。  虽然有个别自恋狂会自己把自己反复加进朋友圈，  但题目保证所有K超过1的朋友圈里都至少有2个不同的人。    输出格式：  按输入的顺序输出那些帅到没朋友的人。ID间用1个空格分隔，  行的首尾不得有多余空格。如果没有人太帅，  则输出No one is handsome。  注意：同一个人可以被查询多次，但只输出一次。  输入样例1：  3  3 11111 22222 55555  2 33333 44444  4 55555 66666 99999 77777  8  55555 44444 10000 88888 22222 11111 23333 88888  输出样例1：  10000 88888 23333  输入样例2：  3  3 11111 22222 55555  2 33333 44444  4 55555 66666 99999 77777  4  55555 44444 22222 11111    输出样例2：  No one is handsome</code></pre><hr><p>这一题考虑用并查集做，现在考虑算法，可以将列举的每一个朋友圈的第一个人作为标签，并将这些标签加入set集合,以便于进行查询。另外再开一个数组为每一个ID置0，默认为未访问标记，查询过的标记置1,如是往复，直到查询结束，因为此题有大量查询语句，所以路径压缩是必须的。且这道题有一个细节：虽然ID号为5位数，但是输入与输出不处理的话，就不满足为5位数，例如00000，存入int型变量输出就会成为0（1位数），所以要固定占位5位，不足5位用0补足。下面是代码：</p><pre><code class="lang-C++">#include&lt;bits/stdc++.h&gt;using namespace std;int pre[100003];int visit[100003] = &#123;0&#125;;set&lt;int&gt; p;int finder(int x)&#123;    int r = x;    while(pre[r] != r)        r = pre[r];    int y = x,z;    while(pre[y]!= r)&#123;  // 路径压缩        z = pre[y];        pre[y] = r;        y = z;    &#125;    return r;&#125;void join(int x, int y)&#123;    int fx = finder(x);    int fy = finder(y);    if(fx != fy)  pre[fx] = fy;&#125;int main()&#123;    ios::sync_with_stdio(false);    // 初始化前导节点    for(int i = 0;i&lt;100003;i++)        pre[i] = i;    // 数据    int n,m,k,id,rt;    bool flag = true;    cin&gt;&gt;n;    while(n--)&#123;        cin&gt;&gt;m&gt;&gt;rt;          //指定根节点        for(int i = 1;i&lt;m;i++)&#123;            cin&gt;&gt;id;            join(rt,id);    // 连接该id与根节点。        &#125;        if(m != 1)            p.insert(finder(pre[rt]));// 保存根节点    &#125;    cin&gt;&gt;k;    for(int i = 0;i&lt;k;i++)&#123;        cin&gt;&gt;id;        if(!visit[id])&#123;            visit[id] = 1;            int res = finder(pre[id]);            auto sig = p.find(res);            if(sig == p.end()) &#123;    // 没有在某个朋友圈里                if(!flag) cout&lt;&lt;&#39; &#39;;                cout&lt;&lt;setw(5)&lt;&lt;setfill(&#39;0&#39;)&lt;&lt;id;                flag = 0;            &#125;        &#125;    &#125;    if(flag) cout&lt;&lt;&quot;No one is handsome&quot;&lt;&lt;&#39;\n&#39;;    else cout&lt;&lt;&#39;\n&#39;;    return 0;&#125;</code></pre><p>对于并查集，</p><ul><li>需要对根节点操作时，可以在录入数据时，指定某个点为为根节点，并将该节点加入set(红黑树)中，以备查找。</li><li>当题目存在大量节点查询时，此时路径压缩算法能起到很大的作用，而题目并没有大量查询时，路径压缩算法作用则不明显，反而会有额外时间开销。</li></ul>]]></content>
    
    
    <summary type="html">&lt;p&gt;在《算法基础》书中， 并查集 又被称为 不相交集结构 ：假设有1到N个对象，希望将这些对象分成不相交的集合，在任意给定时间里，每个对象都恰好在一个集合里。对于每个集合，选择一个成员作为集合的标签。例如决定用最小的对象作为标签，可以用”集合2”来表示集合{2,5,7,10}。 抽象结束。 作为一个受益者，我强烈建议先看这篇 超有爱的并查集~ 。 虽不能说是后无…&lt;/p&gt;</summary>


    <category term="算法与数据结构" scheme="https://www.lightdream.xyz/categories/%E7%AE%97%E6%B3%95%E4%B8%8E%E6%95%B0%E6%8D%AE%E7%BB%93%E6%9E%84/"/>
    
    
    <category term="并查集" scheme="https://www.lightdream.xyz/tags/%E5%B9%B6%E6%9F%A5%E9%9B%86/"/>
    
  </entry>
  
  <entry>
    <title>C++建立大整数类头文件及源文件</title>
    <link href="https://www.lightdream.xyz/BigIntegerSamulation.html"/>
    <id>https://www.lightdream.xyz/BigIntegerSamulation.html</id>
    <published>2018-07-29T21:46:20.557Z</published>
    <updated>2018-10-27T04:23:29.306Z</updated>
    
    <content type="html"><![CDATA[<p>前段时间用Java的BigInteger类做了一道题，于是便萌生了自己用C++实现一个BigInteger类的想法，顺带了解并掌握其底层算法。<br>　　准备阶段，我查阅了一下Java的BigInteger类的源代码(毕竟是轮子)，嗯，只是看了一下 ，然后开工。  </p><p>　　首先我们分析一下BigInteger类<strong>成员变量</strong>以及<strong>成员函数</strong> :</p><hr><h3 id="成员变量"><a href="#成员变量" class="headerlink" title="成员变量"></a>成员变量</h3><ul><li>大整数数串（bigInteger）</li><li>大整数位数（length）</li><li>大整数的正负（signum）</li></ul><h3 id="成员函数"><a href="#成员函数" class="headerlink" title="成员函数"></a>成员函数</h3><ul><li>加法+</li><li>减法-</li><li>乘法*</li><li>除法&#x2F;</li><li>取余%</li></ul><hr><p>下面，我们一步一步的实现…</p><h2 id="第一步：建立头文件-BigInteger-h-声明-BigInteger类"><a href="#第一步：建立头文件-BigInteger-h-声明-BigInteger类" class="headerlink" title="第一步：建立头文件 BigInteger.h 声明 BigInteger类"></a>第一步：建立头文件 <em>BigInteger.h</em> 声明 BigInteger类</h2><p>　　这里我们用vector来存储大数，可以灵活的配置空间。</p><pre><code>#ifndef BIGINTEGER_H_INCLUDED#define BIGINTEGER_H_INCLUDED#include&lt;iostream&gt;#include&lt;vector&gt;#include&lt;string&gt;class BigInteger &#123;private:    std::vector&lt;int&gt; bigInteger;        /* 保存大整数字串    */    size_t length;                      /* 表示大整数长度    */    int signum;                         /* 表示大整数正负 -1为负数 0表示数字0 1表示正数 */public:    // 构造函数    BigInteger();                       /* 空无参构造函数    */    BigInteger(const BigInteger &amp;);     /* 拷贝构造函数      */    BigInteger(const std::string &amp;);    /* 字符串构造大整数  */    // 成员函数    friend std::ostream&amp; operator&lt;&lt;(std::ostream&amp;, BigInteger &amp;);    friend std::istream&amp; operator&gt;&gt;(std::istream&amp;, BigInteger &amp;);    void setLength(const int&amp;);    void setSignum(const int&amp;);    int getLength();    int getSignum();    bool operator==(const BigInteger &amp;);    bool operator&gt;(const BigInteger &amp;);    void operator=(const BigInteger &amp;);    BigInteger operator+(const BigInteger &amp;);    BigInteger operator-(const BigInteger &amp;);    BigInteger operator*(const BigInteger &amp;);    BigInteger operator/(const BigInteger &amp;);    BigInteger operator%(const BigInteger &amp;);&#125;;#endif // BIGINTEGER_H_INCLUDED</code></pre><h2 id="第二步：实现功能（这里只详解主要功能，其它略）"><a href="#第二步：实现功能（这里只详解主要功能，其它略）" class="headerlink" title="第二步：实现功能（这里只详解主要功能，其它略）"></a>第二步：实现功能（这里只详解主要功能，其它略）</h2><p>　　我们先来看两个常数：</p><pre><code>const int LIMIT = 4;const int CARRY = 1e4;</code></pre><p><strong>LIMIT</strong>是**bigInteger (vector)**每个元素存的整数的位数，因为vector每个元素都存一个范围为<br>-2^31 至2^31 - 1的整数，最大的数位数为9位，考虑到最大的4位数相乘,也只有8位，故不会溢出int，所以选择存储4位数。<br>而CARRY则是vector的每个元素的基数，到10000就进位。</p><h3 id="1-加法"><a href="#1-加法" class="headerlink" title="1.加法"></a>1.加法</h3><p>　　加法应该是最好实现的，只用从低位开始加，加完判断进位即可。<br>PS: <strong>代码块可左右滑动</strong></p><pre><code>BigInteger BigInteger::operator+(const BigInteger &amp;tmp)&#123;    BigInteger t = *this, q = tmp;    size_t len1, len2;    if(t &gt; q)  swap(t, q);                          /* 前面重载了 &gt; 、= 和 == 运算符，选择位数多的加*/    len1 = t.bigInteger.size();                     /* 位数少的，再更新它的属性。将其作为返回值。*/    len2 = q.bigInteger.size();    bool flag = false;    for(size_t i = 0; i &lt; len2; i++) &#123;              /* 索引小的为低位，大的为高位        */        if(i &lt; len1)                                /* 防止越界            */            q.bigInteger[i] += t.bigInteger[i];        if(q.bigInteger[i] &gt;= CARRY) &#123;            if(i == len2 - 1) &#123;                      /* 最高位进位为q扩容并加入1 */                q.bigInteger.push_back(1);           /* 进1                 */                q.bigInteger[i] -= CARRY;                flag = true;            &#125; else &#123;                                /* 高位进位          */                q.bigInteger[i + 1]++;                q.bigInteger[i] -= CARRY;           /* 保存本位           */            &#125;        &#125;    &#125;    if(flag) q.length++;                            /* 最高位有进位       */    return q;&#125;</code></pre><h3 id="2-减法"><a href="#2-减法" class="headerlink" title="2.减法"></a>2.减法</h3><p>　　虽然减法不能交换两个数的位置，但是交换后对结果处理一下符号也可以。所以如果被减数大于减数，则直接进行减法；<br>如果被减数小于减数，则交换它们的位置，再相减，并为结果添上负号。减的时候如果结果小于零，此时需要向高位借位。</p><pre><code>BigInteger BigInteger::operator-(const BigInteger &amp;tmp)&#123;    BigInteger q = *this, t = tmp;    size_t len1, len2;    if(q == t) &#123;                                    /*两数相等则直接返回0*/        BigInteger r(&quot;0&quot;);        return r;    &#125;    if(q &gt; t) &#123;        len1 = q.bigInteger.size();        len2 = t.bigInteger.size();        for(size_t i = 0; i &lt; len1; i++) &#123;            if(i &lt; len2)                            /*防止越界          */                q.bigInteger[i] -= t.bigInteger[i];            if(q.bigInteger[i] &lt; 0) &#123;               /* 本位所减的结果小于0则向高位借位 */                q.bigInteger[i + 1]--;                q.bigInteger[i] += CARRY;           /*  更新本位        */            &#125;        &#125;        // 高位去0        for(int i = len1 - 1; i &gt;= 0; i--) &#123;        /* 因为q的最高位 只能大于等于t的最高位，         */            if(q.bigInteger[i] == 0) &#123;              /* 当它们最高位相等时,此时最高位为0，用此算法    */                q.length -= LIMIT;                  /* 把高位的0去掉                                 */                q.bigInteger.pop_back();            &#125; else break;                           /* 从最高位开始扫描，遇到第一个不为0的数则跳出   */        &#125;        // 更新大数的长度        q.length = (q.bigInteger.size() - 1) * LIMIT;   /* 重新计算最高位的位数                   */        int k = q.bigInteger.back();        while(k) &#123;                                  /*  计算位数        */            k /= 10;            q.length++;        &#125;        return q;    &#125; else &#123;        len1 = t.bigInteger.size();        len2 = q.bigInteger.size();        for(size_t i = 0; i &lt; len1; i++) &#123;            if(i &lt; len2)                t.bigInteger[i] -= q.bigInteger[i];            if(t.bigInteger[i] &lt; 0) &#123;                t.bigInteger[i + 1]--;                t.bigInteger[i] += CARRY;            &#125;        &#125;        // 大数符号        t.signum = -1;                              /*  反过来减，结果为负数*/        // 高位去0        for(int i = len1 - 1; i &gt;= 0; i--) &#123;            if(t.bigInteger[i] == 0) &#123;                t.length -= LIMIT;                t.bigInteger.pop_back();            &#125; else break;        &#125;        t.length = (t.bigInteger.size() - 1) * LIMIT;        int k = t.bigInteger.back();        while(k) &#123;            k /= 10;            t.length++;        &#125;        return t;    &#125;&#125;</code></pre><p><strong>加减只支持无符号大整数运算,因为在算的时候可以灵活的加括号与换符号</strong></p><h3 id="3-乘法"><a href="#3-乘法" class="headerlink" title="3.乘法"></a>3.乘法</h3><p>　　乘法依照竖式算法，被乘数的每一位和乘数的每一位相乘并将结果保存到相应的位置，且该相应位置应加上上一位的进位与本位值。</p><pre><code>BigInteger BigInteger::operator*(const BigInteger &amp;tmp)&#123;    BigInteger t = *this, q = tmp, r;    int carry;    size_t i, j;    size_t len1 = t.bigInteger.size(), len2 = q.bigInteger.size();    vector&lt;int&gt; T(len1+len2, 0);    for(i = 0; i &lt; len1; i++) &#123;        carry = 0;        for(j = 0; j &lt; len2; j++) &#123;            int temp = t.bigInteger[i] * q.bigInteger[j] + T[i + j] + carry;  /* 保存第i位与第j位的乘积，并加上本位与进位值*/            if(temp &gt;= CARRY) &#123;                carry = temp / CARRY;                                         /* 保存进位值 */                T[i + j] = temp - temp / CARRY * CARRY;                       /* 更新本位值 */            &#125; else &#123;                carry = 0;                T[i + j] = temp;            &#125;        &#125;        if(carry != 0)         T[i + j] = carry;                                      /* 最高位进位 */    &#125;    // 处理符号    if(t.signum &lt; 0 &amp;&amp; q.signum &lt; 0)        r.signum = 1;    else &#123;        if(t.signum &lt; 0 || q.signum &lt; 0)            q.signum = -1;        else if(t.signum == 0 || q.signum == 0) &#123;            r.signum = 0;        &#125; else &#123;            r.signum = 1;        &#125;    &#125;    // 处理长度    if(r.signum != 0) &#123;                                                      /* 先判断结果的符号 */        //  高位去0        for(int i = T.size() - 1; i &gt;= 0; i--) &#123;            if(T[i] == 0) &#123;                T.pop_back();            &#125; else &#123;                break;            &#125;        &#125;        // 数字串长度        r.length = (T.size() - 1) * LIMIT;        int k = T.back();        while(k) &#123;            k /= 10;            r.length++;        &#125;        r.bigInteger = T;    &#125; else &#123;        r.length = 1;        T.resize(1);        r.bigInteger = T;    &#125;    return r;&#125;</code></pre><h3 id="4-除法"><a href="#4-除法" class="headerlink" title="4.除法"></a>4.除法</h3><p>　　判定大小，如果被除数等于除数，返回1；如果被除数小于除数，返回0；如果被除数大于除数，则进入除法，最简单的就是反复的做减法，看能减多少个除数。这里只介绍最基础的<br>法。还有一种将这种方法优化一些的算法，完整版见我的Github <a href="https://github.com/lightingmoon/">明月光</a>。</p><pre><code>BigInteger BigInteger::operator/(const BigInteger &amp;tmp)     // 最基础的算法，效率上可能有不足&#123;    BigInteger q = *this , t = tmp, ans, ZERO(&quot;0&quot;);    assert(!(t == ZERO));                       /* 除数不为0                */    if(q == ZERO) return ZERO;                  /* 被除数为0返回0           */    if(q == t) &#123;                                /* 两数相等则直接返回1      */        ans.signum = 1;        ans.length = 1;        ans.bigInteger.push_back(1);    &#125; else &#123;        if(q &gt; t) &#123;                             /* 被除数大于除数，开始整除 */            vector&lt;int&gt; T(100, 0);            int index = 0, maxl = 0;            while(true) &#123;                q = q - t;                if(ZERO &gt; q) &#123;                    if(!(ZERO == q)) break;     /* 直到减到q小于零，当能整除的时候要将商加1 */                &#125;                T[index]++;                if(T[index] &gt;= CARRY) &#123;         /*判定进位              */                    T[index] = 0;                    T[++index]++;                    maxl = max(maxl, index);                    for(int i = index; i &lt; maxl; i++) &#123;                        if(T[i] &gt;= CARRY) &#123;                            T[i + 1]++;                            T[i] = 0;                        &#125;                    &#125;                    index = 0;                  /* 重回最低位累加      */                &#125;            &#125;            T.resize(maxl + 1);                 /* 缩放空间             */            if(q.signum &lt; 0 &amp;&amp; t.signum &lt; 0)                q.signum = 1;            else &#123;                if(q.signum &lt; 0 || t.signum &lt; 0)                     q.signum = -1;                else &#123;                    q.signum = 1;                &#125;            &#125;            ans.bigInteger = T;        &#125; else &#123;            ans = ZERO;        &#125;    &#125;    return ans;&#125;</code></pre><h3 id="5-取余"><a href="#5-取余" class="headerlink" title="5.取余"></a>5.取余</h3><p>　　最简单的方法，代码如下2333333…</p><pre><code>BigInteger BigInteger::operator%(const BigInteger &amp;tmp)&#123;    BigInteger q = *this, t = tmp, ZERO(&quot;0&quot;), m;    assert(!(q==ZERO));    assert(!(t==ZERO));    m = q / t;    return q - (m * t);&#125;</code></pre><p>　　这里还有另一种模拟取余的方法，</p><pre><code>long long BigInteger::operator%(const long long &amp;tmp)&#123;    BigInteger q = *this;    long long mod = 0, len = q.bigInteger.size();    for(int i = len - 1; i &gt;= 0; i--) &#123;        mod = ((mod * CARRY)%tmp + q.bigInteger[i]) % tmp;    &#125;    return mod;&#125;</code></pre><p>下面是一些测试:</p><pre><code>开始测试p:1234567890123456789q:123456789012345678p - q = 1111111101111111111p + q = 1358024679135802467p * q = 152415787532388366390794098763907942p / q = 10p % q = 9p % 1234567890 = 123456789结束测试</code></pre><p>参考资料：</p><ul><li><a href="https://blog.csdn.net/u010983881/article/details/77503519">【算法】大数乘法问题及其高效算法</a></li><li><a href="https://blog.csdn.net/hackbuteer1/article/details/6595881">C++大数模板</a></li></ul>]]></content>
    
    
    <summary type="html">&lt;p&gt;前段时间用Java的BigInteger类做了一道题，于是便萌生了自己用C++实现一个BigInteger类的想法，顺带了解并掌握其底层算法。 准备阶段，我查阅了一下Java的BigInteger类的源代码(毕竟是轮子)，嗯，只是看了一下 ，然后开工。 首先我们分析一下BigInteger类 成员变量 以及 成员函数 : 成员变量 大整数数串（bigInte…&lt;/p&gt;</summary>


    <category term="算法与数据结构" scheme="https://www.lightdream.xyz/categories/%E7%AE%97%E6%B3%95%E4%B8%8E%E6%95%B0%E6%8D%AE%E7%BB%93%E6%9E%84/"/>
    
    
    <category term="C" scheme="https://www.lightdream.xyz/tags/C/"/>
    
    <category term="大整数类" scheme="https://www.lightdream.xyz/tags/%E5%A4%A7%E6%95%B4%E6%95%B0%E7%B1%BB/"/>
    
  </entry>
  
  <entry>
    <title>千寻诗意，洒脱如风</title>
    <link href="https://www.lightdream.xyz/mysoul.html"/>
    <id>https://www.lightdream.xyz/mysoul.html</id>
    <published>2018-07-22T06:08:56.607Z</published>
    <updated>2019-01-22T07:29:25.737Z</updated>
    
    <content type="html"><![CDATA[<blockquote><p>白云一片去悠悠，青枫浦上不胜愁。谁家今夜扁舟子，何处相思明月楼。——张若虚</p></blockquote><h4 id="自定义"><a href="#自定义" class="headerlink" title="自定义"></a>自定义</h4><p>我如浮云般漂浮不定，又如江中磐石，永不动摇。所寄者，洒脱也。古人狂歌痛饮三大白作离别，诗仙斗酒诗百篇以明志，我辈又如何能望其项背？ 然太史公曰：”高山仰止，景行行止，虽不能至，然心向往之”，必穷尽一生去追求也。 金岳霖为林徽因终生未娶，满怀期待与林的下一辈子的爱情。在林去世时，金为她写下这样的诗句：”一身诗意千寻瀑，万古人间四月天”。林惊才艳艳，金又何尝不是呢？若不是他们的千寻诗意，便没有今天这洒脱如风的诗句了吧。 或者说若没有他们的洒脱如风，便没有这般光芒万丈的珍奇了吧。只是赞叹，只有赞叹。 就像深入灵魂，像蜡炬成灰泪始干，像女儿红...</p><h4 id="重定义"><a href="#重定义" class="headerlink" title="重定义"></a>重定义</h4><p><img src="/image/KnowYourself.jpg">{height&#x3D;”75” width&#x3D;”125”}</p><p>一 . 认识自己</p><p>古希腊阿波罗神殿门楣的石板上刻着这样一行字: 认识你自己。这寥寥几个字从人类文明发祥伊始，至现代，一直是一个长久不衰的话题。而我们又如何去认识自己呢？<br>问题的答案如同一千个人眼中的《哈姆雷特》，各有千秋。坚守自己的”哈姆雷特”让独特欲盖弥彰。</p><p>二 . 改变自己</p><p>在威斯敏斯特大教堂地下室的墓碑林中，有一块闻名于世的墓碑。<br>它普通而又不平凡。普通是因为它周围都是诸如狄更斯、达尔文等世界名人的装饰华丽的墓碑，而它却只是粗糙的花岗岩质地，造型也一般，甚至连墓志铭都没有——是一块无名氏墓碑；<br>不平凡是因为每一位到过这里的人，他们可以不去拜谒世界名人，但是定会来到这座墓碑前，进而被它深深地震撼。因为这座墓碑上刻着这样一段碑文：</p><blockquote><p>When I was young and free and my imagination had no limits, I dreamed of changing the world. As I grew older and wiser, I discovered the world would not change, so I shortened my sights somewhat and decided to change my country. But it, too, seemed immovable. As I grew into my twilight years, in one last desperate attempt, I settled for changing only my family, those closest to me. But alas, they would have none of it. And now, as I lie on my bed, I suddenly realize:If I had only changed myself first, then by example I would have changed my family. From their inspiration and encouragement, I would then have been able to better my country, and who knows I may have even change the world.</p></blockquote><h4 id="终定义"><a href="#终定义" class="headerlink" title="终定义"></a>终定义</h4><p>漫漫长路，如何在有限的生命中寻到人生终极价值？青山不语，冷月云蔽，唯见旧时的风载着新落的叶缓缓而沉。</p>]]></content>
    
    
    <summary type="html">&lt;p&gt;白云一片去悠悠，青枫浦上不胜愁。谁家今夜扁舟子，何处相思明月楼。——张若虚 自定义 我如浮云般漂浮不定，又如江中磐石，永不动摇。所寄者，洒脱也。古人狂歌痛饮三大白作离别，诗仙斗酒诗百篇以明志，我辈又如何能望其项背？ 然太史公曰：”高山仰止，景行行止，虽不能至，然心向往之”，必穷尽一生去追求也。 金岳霖为林徽因终生未娶，满怀期待与林的下一辈子的爱情。在林去世时…&lt;/p&gt;</summary>


    <category term="静夜思" scheme="https://www.lightdream.xyz/categories/%E9%9D%99%E5%A4%9C%E6%80%9D/"/>
    
    
    <category term="静夜思" scheme="https://www.lightdream.xyz/tags/%E9%9D%99%E5%A4%9C%E6%80%9D/"/>
    
  </entry>
  
</feed>