自己早已对机器学习观望已久,现在不入门,更待何时?在找到Coursera时,发现教学方法很对胃口,于是开始ML之旅…现在在这里总结一下机器学习之线性回归。
机器学习有很多种方式,比如监督学习,半监督学习,无监督学习等。它们区别于训练集的种类,比如监督学习的训练集其每一个训练样本都有正确的答案,而无监督学习则没有,只能通过算法自动分类。而半监督学习,顾名思义,一部分是监督学习,一部分是无监督学习。
监督学习
监督学习又分为聚类和回归。其中聚类是预测连续值,回归是预测离散值。例如垃圾邮件识别,网页类别划分等是聚类。预测房价、股票涨跌等是回归。
下面总结一下线性回归。
线性回归
线性回归模型
截取自Coursera课程课件
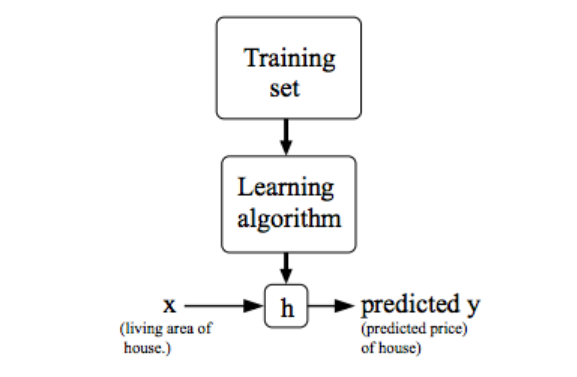
假设有房价数据集如下:
| 房子面积/$m_{2}$(x) | 价格/w(y) |
|---|---|
| 80 | 40 |
| 90 | 60 |
| 100 | 80 |
| … | … |
数据集1
以下为一些字母的含义:
| 字母 | 含义 |
|---|---|
| $m$ | 表示训练样本数量 |
| $x$ | 表示输入特征(特征量) |
| $y$ | 表示输出变量(目标量) |
| $(x,y)$ | 表示一个训练样本 |
| $(x^{(i)},y^{(i)})$ | 表示第i个训练样本 |
对应于线性回归的**假设函数(hypothesis function)**为
$$h_{\theta}(x)=\theta_{0}+\theta_{1}x$$
其中$\theta$为参数
对应的代价函数(cost function)(其图像为一个凹函数)为
$$J(\theta_{0},\theta_{1})=\frac{1}{2m}\sum_{i=1}^{m}(h_{\theta}(x^{(i)})-y^{(i)})^2$$
这个方程有什么意义呢?
下面是一个散点图:
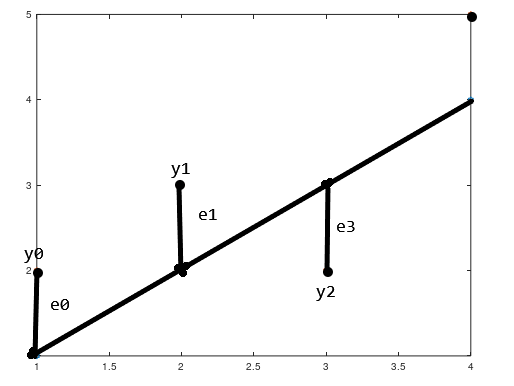
由图片e表示假设函数结果与训练样本之间的误差。
$$e_{0}=h_{\theta}(1)-y_{0}$$$$e_{1}=h_{\theta}(2)-y_{1}$$$$e_{2}=h_{\theta}(3)-y_{2}$$$$…$$
所有误差的和即为
$$\sum_{i=1}^{m}(h_{\theta}(x^{(i)})-y^{(i)})$$
要想得到拟合最好的效果,我们必须要让误差和最小。但是通常我们都用平均每个训练样本的误差的一半来表示。也即代价函数:
$$J(\theta_{0},\theta_{1})=\frac{1}{2m}\sum_{i=1}^{m}(h_{\theta}(x^{(i)})-y^{(i)})^2$$
此时得到的参数$\theta_{0},\theta_{1}$为最合适的参数。
梯度下降算法(Gradient Descent Algorithm)
$$\theta_{j}=\theta_{j}-\alpha\frac{\partial{J(\theta_{0},\theta_{1})}}{\partial{j}}$$
其中$\theta$表示参数,$\alpha(\geq0)$表示学习效率,后面表示$\theta_{j}$的偏导。
为了叙述方便,下面令$\theta_{0}=0$,此时$J({\theta_{1}})$只有一个参数$\theta_{1}$,令$J(\theta)$最小值对应于$\theta_{min}$
- 假如$\theta_{1}>\theta_{min}$,则该点切线斜率大于等于0,即$\frac{dJ(\theta_{1})}{d\theta_{1}}\geq 0$(因为只有一个参数,所以退化为求微分),所以$\theta_{1}=\theta_{1}-\alpha\frac{dJ(\theta_{1})}{d\theta_{1}}$,$\theta_{1}$减去一个正数,$\theta_{1}$减小,则$\theta_{1}$更靠近$\theta_{min}$
- $\theta_{1}<\theta_{min}$分析方法类似
梯度下降算法在线性回归中的应用
将之前的代价函数带入梯度下降算法里,得到(其实就是复合函数求导,可以手动算一下):
$$\theta_{0}=\theta_{0}-\alpha\frac{1}{m}\sum_{i=1}^{m}(h_{\theta}(x^{(i)})-y^{(i)})$$$$\theta_{1}=\theta_{1}-\alpha\frac{1}{m}\sum_{i=1}^{m}(h_{\theta}(x^{(i)})-y^{(i)})*x_{1}$$
多元线性回归
有数据集如下:
| $x_{0}$ | 房子面积/$m_{2}(x_{1})$ | 卧室数量$(x_{2})$ | 层数$(x_{3})$ | 房子寿命$(x_{4})$ | 价格/w(y) |
|---|---|---|---|---|---|
| 1 | 80 | 1 | 1 | 50 | 50 |
| 1 | 90 | 2 | 2 | 60 | 60 |
| 1 | 100 | 3 | 3 | 70 | 60 |
| … | … | … | … | … | … |
数据集2
PS:为了$\theta_{i}$与$x_{j}$下标一致,所以多加一列,其所有值都为1
补充字母含义:
| 字母 | 含义 |
|---|---|
| n | 特征数量 |
| $x^{(i)}$ | 第i个训练样本 |
| $x^{(i)}_{j}$ | $i^{th}$训练样本$j^{th}$特征值 |
此时,假设函数为:
$$h_{\theta}(x)=\theta_{0}x_{0}+\theta_{1}x_{1}+\theta_{2}x_{2}+…+\theta_{n}x_{n}$$
代价函数:
$$J(\theta)=\frac{1}{2m}\sum_{i=1}^{m}(\theta^{T}x^{(i)}-y^{(i)})^2$$
也等价于
$$J(\theta)=\frac{1}{2m}\sum_{i=1}^{m}((\sum_{j=0}^{n}\theta_{j}x_{j}^{(i)})-y^{(i)})^2$$
则梯度下降算法对应的偏导为:
$$\theta_{j}=\theta_{j}-\alpha\frac{1}{m}\sum_{i=1}^{m}(h_{\theta}(x^{(i)})-y^{(i)})*x_{j}^{(i)}$$
加快梯度下降算法收敛方法
- 特征缩放(feature scaling)
保证每个特征量范围都在$-1\geq x_{i}\geq 1$,每个特征值除以该特征范围。 - 均值归一化(mean normalization)
保证特征变量在$-0.5\geq x_{i} \geq 0.5$,令$$x_{i}=\frac{x_{i}-\mu_{i}}{s_{i}}$$其中,$\mu_{i}$表示$i^{th}$特征的均值,$s_{i}$表示表示$i^{th}$特征的范围或标准差。 - 调整学习效率$\alpha$
$\alpha$必须足够小,且$J(\theta)$必须在每一次迭代后减小,可以以每次为原来的3倍来调整$\alpha$。- 当$\alpha$太小,算法收敛过慢。
- 当$\alpha$太大,$J(\theta)$可能在迭代若干次后开始增加,最终算法不能收敛。
多项式线性回归
当假设函数不再是线性时,可以通过平方,立方,开平方来进行多项式拟合。
e.g
$h_{\theta}(x)=\theta_{0}+\theta_{1}x_{1}$
对于数据集1,可以令
- $h_{\theta}(x)=\theta_{0}+\theta_{1}x_{1}^{2}$
此函数为二次函数,根据实际情况,房价不可能随面积增大而减小。 - $h_{\theta}(x)=\theta_{0}+\theta_{1}x+\theta_{1}x_{1}^{2}+\theta_{2}x_{1}^{3}$
此函数中,令$x_{2}=x_{1}^{2},x_{3}=x^{3}_{1}$,此时,三个特征范围相差过大,对于特征值归一化有不利影响。 - $h_{\theta}(x)=\theta_{0}+\theta_{1}x_{1}+\theta_{2}\surd{x_{1}}$
此时较符合模型。运用此方法 ,特征缩放很重要,而且特征之间关联程度要小。
正规方程(Normal Equation)
对于训练样本数为m,特征数为n,
令矩阵
$$X=\left[ \begin{matrix} x_0^{i} & x_1^{i} & x_2^{i} & x_3^{i} &…\end{matrix} \right]^{T}$$
其中$(1\leq i \leq m)$,X为m*(n+1)阶矩阵。
$$y=\left[ \begin{matrix} y^{(1)} \
y^{(2)} \
… \
y^{(m)} \end{matrix} \right]$$
有正规方程,在数学上可证明其正确性:
$$\theta=(X^{T}X)^{-1}X^{T}y$$
最终$\theta$为1*(n+1)阶矩阵
梯度下降算法与正规方程比较
| 梯度下降算法 | 正规方程 |
|---|---|
| 需要选择$\alpha$ | 不需要选择$\alpha$ |
| 需要多次迭代 | 不需要迭代 |
| 时间复杂度为$O(kn^{2}$) | $O(n^{3}$),主要在矩阵求逆 |
| 当n很大时,能运行得不错 | 当n很大时,因为矩阵求逆而速度很慢 |
注: 当n大于10000时,考虑用梯度下降算法
正规方程不可逆
- 存在多余的特征,即存在关联程度很大的特征,此时可以分析特征,删去关联程度大的特征中一个。
- 特征值太多,例如$m<n$。此时可以删去存在关联的特征,或进行正则化。
夜已深,就总结到这里,接下来准备做一个小项目。晚安~