粒子群算法( Particle Swarm Optimization, PSO)是由Eberhart和Kennedy于1995年提出,它的基本概念源于对鸟群觅食行为的研究。设想这样一个场景:一群鸟在随机搜寻食物,在这个区域里只有一块食物,所有的鸟都不知道食物在哪里,但是它们知道当前的位置离食物还有多远。那么找到食物的最优策略是什么呢?最简单有效的就是搜寻目前离食物最近的鸟的周围区域。
PSO算法就从这种生物种群行为特性中得到启发并用于求解优化问题。在PSO中,每个优化问题的潜在解都可以想象成d维搜索空间上的一个点,我们称之为”粒子”(Particle),所有的粒子都有一个被目标函数决定的适应值(Fitness Value ),每个粒子还有一个速度决定他们飞翔的方向和距离,然后粒子们就追随当前的最优粒子在解空间中搜索。随着位置更新(迭代次数)增加,粒子最终在搜索空间上收敛于最优值(理想状态下)。
标准粒子群算法(全局版本)
例如,求函数$y=1-cos(3x)e^{-x}$在$[0,4]$上的最大值,并在[0,4]之间放置了两个随机的点,假设为$x_1=1.5,x_2=2.5$,则$x_1,x_2$为标量。对于高维情况,比如二维,求$z=2x_1+{x_2}^{2}$,此时每个粒子都是二维的,记
$$P_1=(x_{11},x_{12}),P_2=(x_{21},x_{22}),…,\
P_n=(x_{n1},x_{n2})$$
这里$n$为粒子群群体规模,也是粒子个数,每个粒子维数为2。更一般的粒子维数为q,则这个种群中有n个粒子,每个粒子为q维。
对由n个粒子组成的Q维空间进行搜索,第i个粒子表示$x_i=(x_{i1},x_{i2},…,x_{iq}), i=1,2,…,n$,其在各个维度上速度表示为$v_i=(v_{i1},v_{i2},…,v_{iq})$,每个粒子在搜索时考虑以下两个因素:
- 自己搜索到的历史最优值$p_i, p_i=(p_{i1},p_{i2},…,p_{iq}),i=1,2,…,n$
- 全部粒子搜索到的最优值$p_g, p_g=(p_{g1},p_{g2},…,p_{gn}), i=1,2…,n$
下面是粒子在搜索时位置速度更新公式:$$v_{id}^{k+1}=\omega v_{id}^{k}+c_1(p_{id}^{k}-x_{id}^{k})\
+c_2(p_{gd}^{k}-x_{id}^{k})$$$$x_{id}^{k+1}=x_{id}^k+rv_{id}^{k+1}$$其中的参数:
- $w$为保持原来速度的系数,即惯性权重,其值非负。当值较大时,全局寻优能力强,局部寻优也就弱了;其值较小时,局部寻优能力强,全局寻优能力弱。
- $c_1$是跟踪自己历史最优值的权重系数,表示粒子自身的认识,所以叫”认知”,通常设置为2
- $c_2$是粒子跟踪群体最优值的权重系数,表示粒子对整个群体知识的认识,叫”社会知识”,经常叫做”社会”,通常设置为2
- r 是对位置更新的时候在速度前面加的一个系数,这个系数被称为约束因子,通常设置为1
这就是一个标准的粒子群算法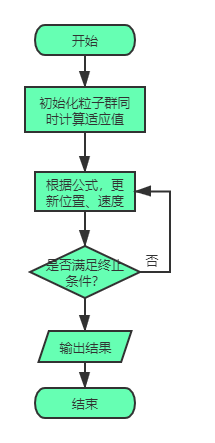
标准粒子群算法(局部版本)
如果改变全局版本的速度更新公式,让每个粒子位置速度更新根据:
粒子自己搜索到的历史最优值$p_i$
粒子邻域内搜索搜索到的最佳值$pn_{k}$
其余保持不变,则就成了局部版本的粒子群算法。
一般一个粒子$p_i$的邻域随着迭代次数增加,第一次迭代时,其邻域为0,随着迭代次数邻域线性变大,最后扩展到整个粒子群,这时就变成了全局版本的粒子群算法了。实践证明:
全局版本的粒子群算法收敛速度较快,但容易陷入局部最优解;而局部版本的收敛速度慢,但是不容易陷入局部最优。故现在粒子群优化算法大都在收敛速度与摆脱局部最优之间做权衡。
静态邻域:
按照粒子的编号取粒子的邻域
环形
随机环形
轮形
随机轮形
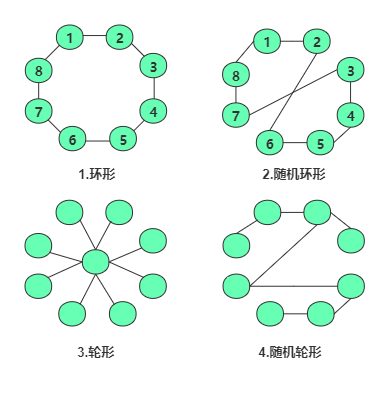
环形取法如上图1中:
对编号为1的粒子来说,当粒子邻域个数k为0时,则邻域是其本身;粒子邻域个数k为1时,则其邻域为{2,8};粒子邻域个数k为2时,其邻域为{2,8,7,3}…当邻域个数为4时,粒子的邻域就为整个粒子群了。轮形取法如上图3
对于指定粒子i,其位于邻域中心,其它粒子以一定规则与粒子i相连。只有中心粒子与其它相连粒子进行信息交换,中心粒子通过比较邻域中所有粒子携带信息而向其中最优粒子靠近。同时,邻域内最优信息通过中心粒子的性能改善而传播到种群的其它粒子。因此,中心个体令较好信息在种群中的传播速度变慢而增大了全局搜索能力,不至于早收敛。
动态邻域
- 按照粒子的欧式距离取粒子的邻域
记录任何两个粒子间最大距离为$d_m$,对每一粒子按照$\frac{||x_a - x_b||}{d_m}$,其中$||x_a-x_b||$为粒子a与粒子b的欧氏距离。而选择阈值$frac$根据迭代次数而变化,当另一粒子b满足$\frac{||x_a-x_b||}{d_m} < frac$,认为b是当前粒子的邻域内。由于要计算所有粒子之间的距离,计算量大且需要很多额外的存储空间,所以该方法不常用。
参考文献: - [1]李丽,牛奔.[M]粒子群优化算法.北京:冶金工业出版社,2009
- 感谢这位前辈13年前的博客niuyongjie引我入门。